Статьи о железе для ИИ
Как выбрать видеокарту и сервер под свою модель, чем отличаются поколения NVIDIA и Huawei и что нужно дата-центру. Без маркетинга, с расчётами.
Выбор оборудования
Видеокарта для Stable Diffusion, Flux и Wan: изображения и видео
Видеокарта для Stable Diffusion, FLUX и Wan: сколько памяти занимают модели, когда хватит RTX 5090, зачем 96 ГБ, что дают FP8 и FP4 и как устроить студийную очередь.
Как выбрать видеокарту для нейросетей: память, скорость, бюджет
Как выбрать видеокарту для нейросетей: какие параметры важнее, чем игровые карты отличаются от серверных, сколько нужно памяти и какая карта подойдёт под вашу задачу.
Рабочая станция для ИИ: DGX Spark, DGX Station или ПК с RTX
Рабочая станция для ИИ: сравниваем ПК с RTX 5090, станцию на RTX PRO 6000, DGX Spark и DGX Station GB300 по памяти, скорости и потреблению и разбираем ограничения офиса.
Сервер для локальной LLM в компании: как подобрать конфигурацию
Как подобрать сервер для LLM в компании: расчёт памяти под модель и пользователей, KV-кеш, три типовые конфигурации от отдела до крупного сервиса и софт для запуска.
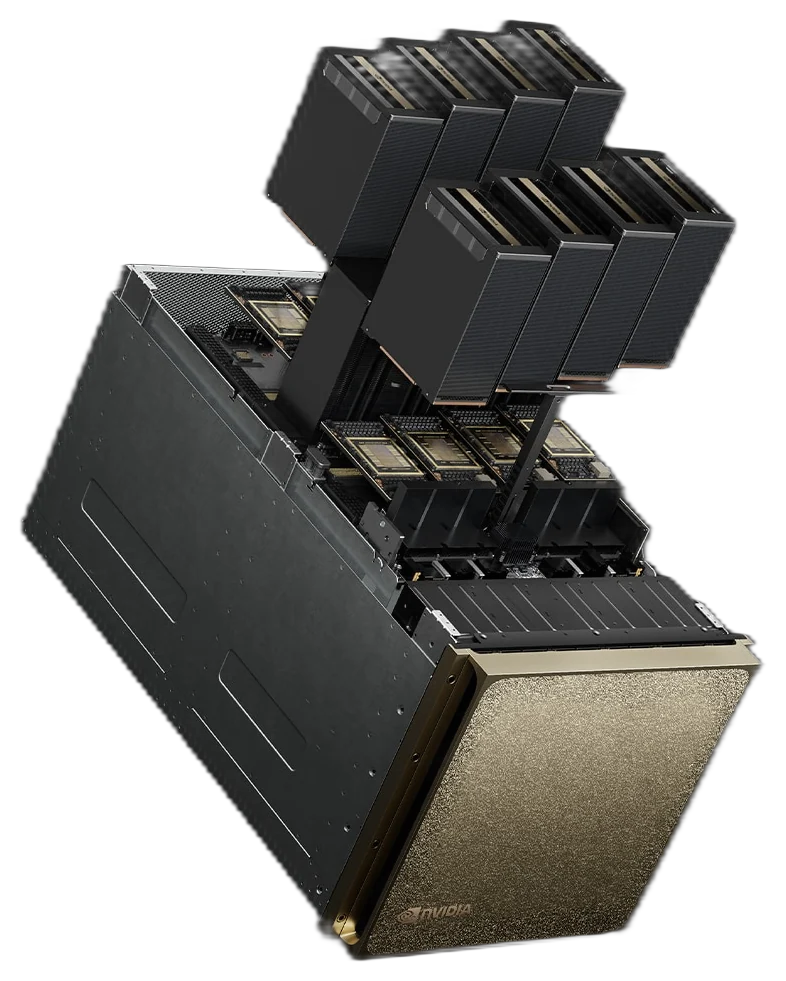
Сервер для обучения нейросетей: что важно кроме GPU
Сервер для обучения нейросетей: сколько памяти GPU нужно на параметр, зачем NVLink и быстрая сеть, какое хранилище и питание заложить и когда хватит одной карты.
Сколько видеопамяти нужно для LLM: расчёт для моделей от 8B до 671B
Простая формула, сколько видеопамяти нужно языковой модели: веса, KV-кеш и запас. Таблица для Qwen3, Llama 70B, gpt-oss и DeepSeek и подбор GPU под объём.
Сравнения
DGX или HGX: NVIDIA DGX или сервер Supermicro на тех же GPU
DGX или HGX: чем готовая система NVIDIA отличается от сервера Supermicro на той же плате с восемью GPU. Сравниваем DGX B200, DGX H200 и HGX-серверы, кому что подходит.
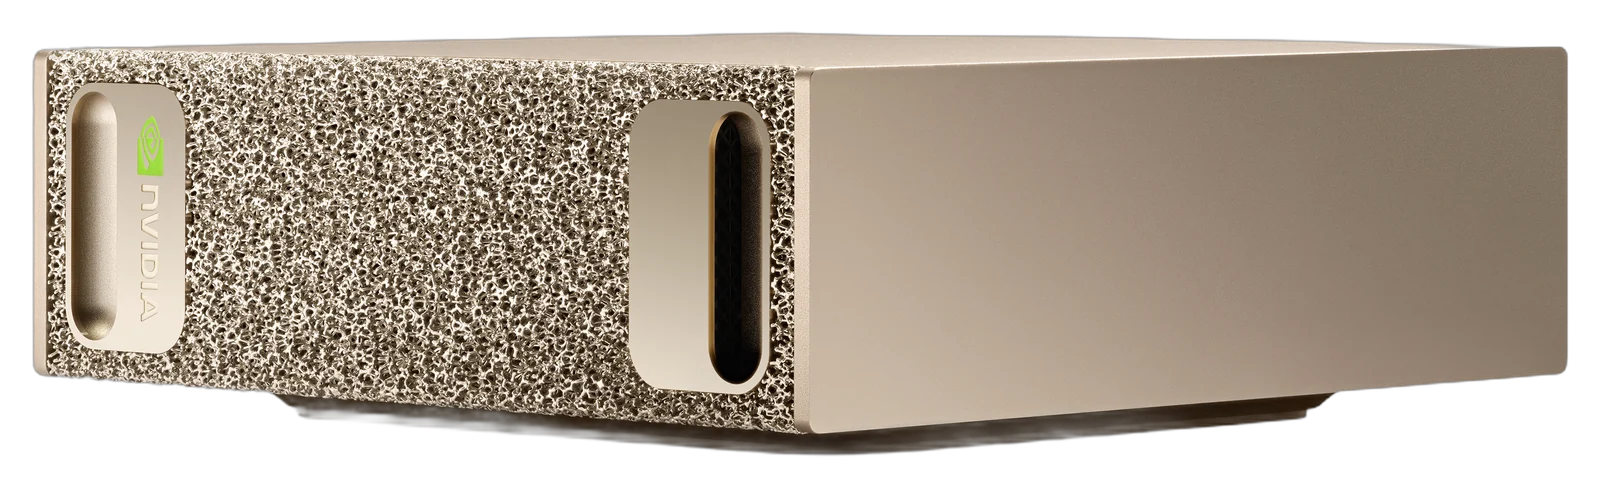
DGX Spark, Mac Studio или RTX 5090: что выбрать для локальных LLM
DGX Spark vs Mac Studio и RTX 5090 для локальных LLM: объём и скорость памяти, CUDA, длинные промпты и теоретический потолок генерации. Кому что подходит.
H200 vs B200: сравнение NVIDIA Hopper и Blackwell
H200 vs B200: память, скорость, FP4, NVLink 5 и потребление. Сравниваем DGX H200 и DGX B200 и объясняем, когда хватит Hopper, а когда нужен Blackwell.
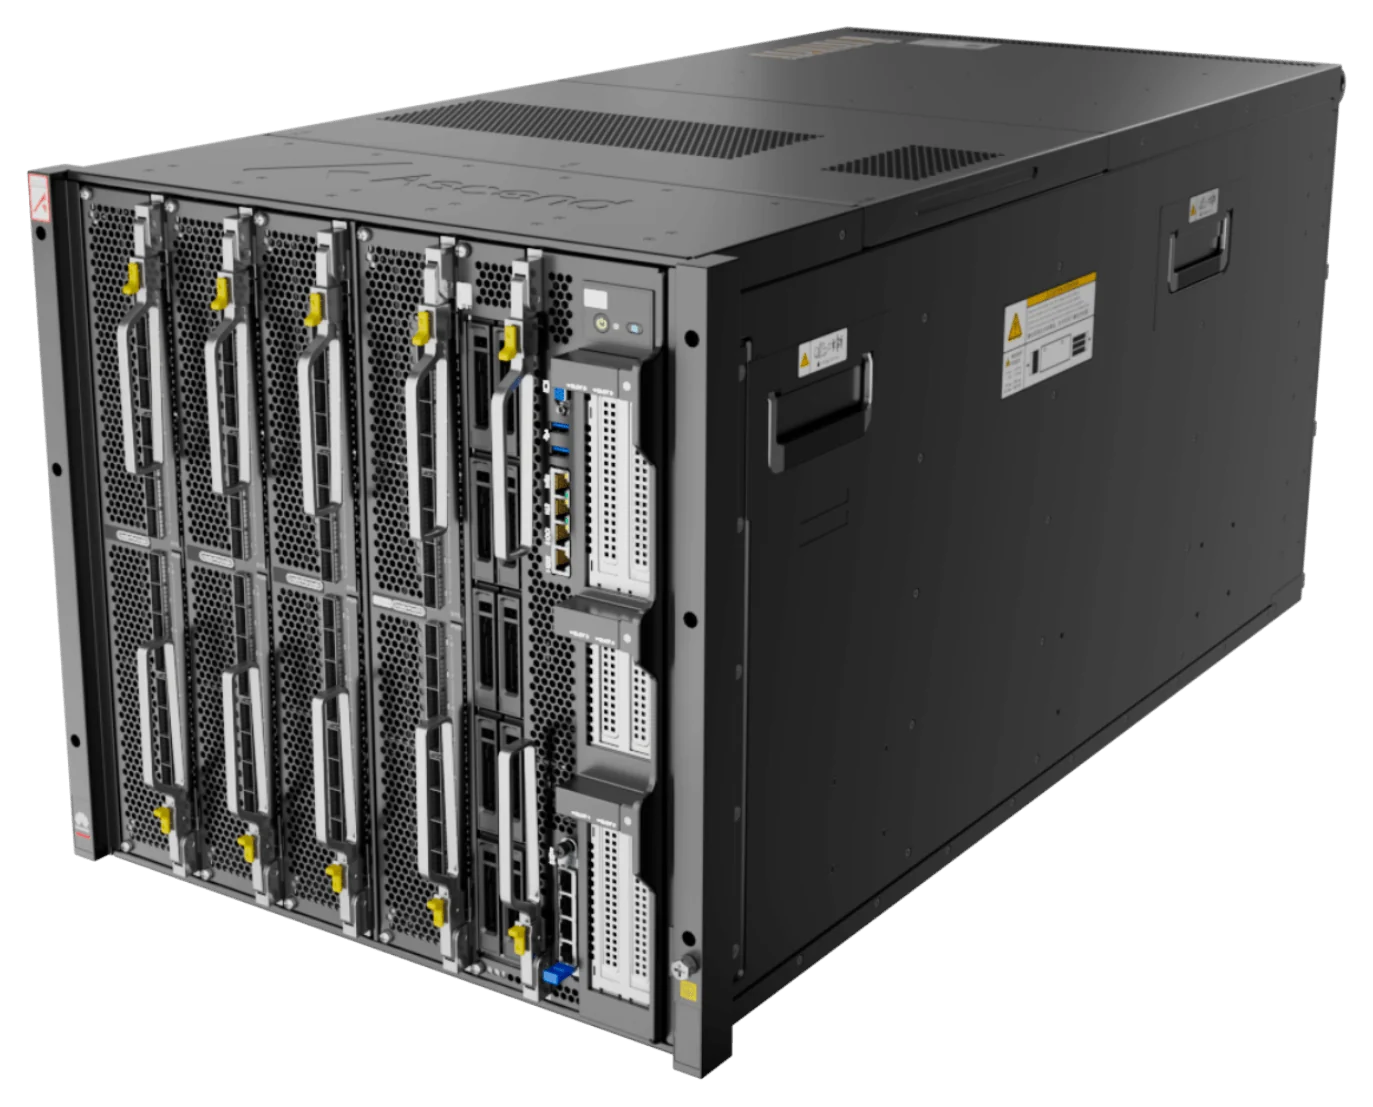
Huawei Ascend или NVIDIA: что выбрать для ИИ в России
Huawei Ascend или NVIDIA для ИИ: сравниваем чипы 910B, 910C и 950PR с H200 по памяти и связи, софт CANN против CUDA и разбираем, кому какая платформа подходит.
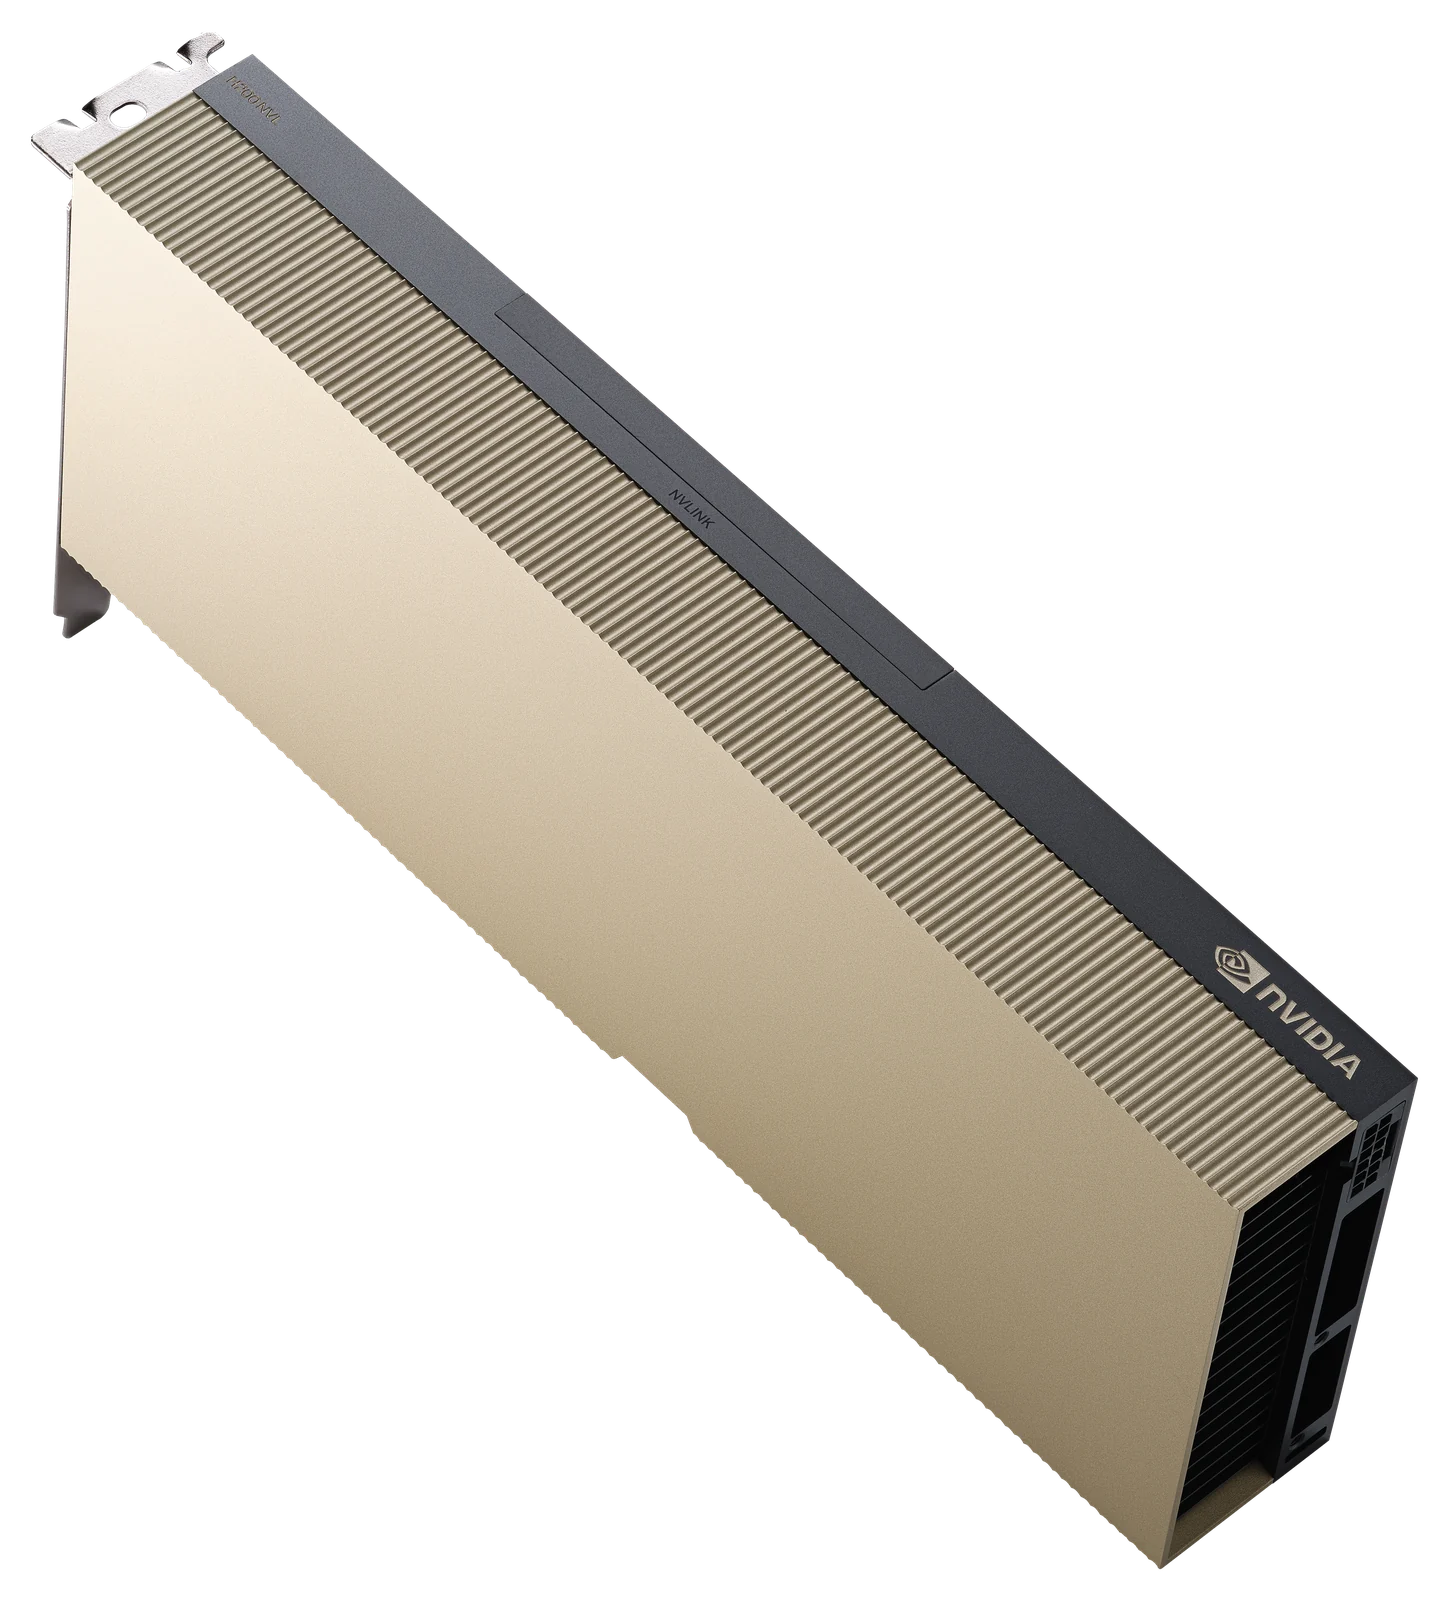
NVIDIA H100 vs H200: в чём разница и что выбрать
H100 vs H200: один чип Hopper, но у H200 141 ГБ HBM3e вместо 80 ГБ и 4,8 ТБ/с вместо 3,35. Что это даёт в инференсе LLM, какие есть версии и что выбрать.
RTX 5090 vs RTX PRO 6000 Blackwell: что взять для ИИ
RTX 5090 vs RTX PRO 6000: одна архитектура и одинаковая скорость памяти, но 32 ГБ против 96 ГБ. Разбираем ECC, MIG, лицензию драйвера и кому какая карта подходит.
Запуск моделей
Дообучение LLM: сколько GPU нужно для LoRA и полного обучения
Сколько памяти и GPU нужно для дообучения LLM методами LoRA, QLoRA и полного обучения: таблица для моделей 8B, 32B и 70B, подбор железа и софт.
Квантование LLM: FP8, INT4 и FP4 простыми словами
Что такое квантование LLM простыми словами: форматы FP8, INT8, INT4, FP4 и GGUF, сколько памяти они экономят, как влияют на качество и какое железо их поддерживает.
Корпоративный ИИ-ассистент и RAG: какое железо нужно компании
Какое железо нужно корпоративному ИИ-ассистенту на базе RAG: из чего состоит система, что потребляет память GPU и расчёт на 50, 300 и 1 000 сотрудников.
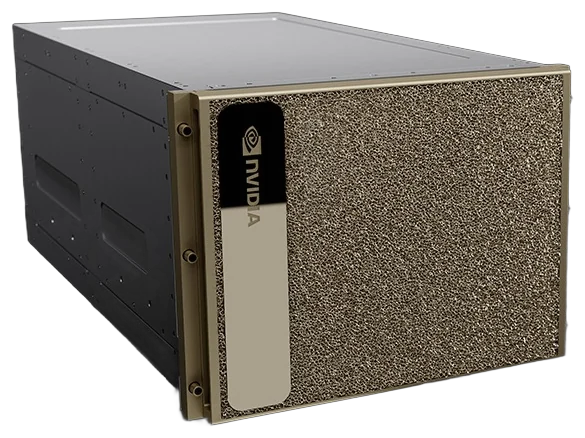
Сервер для DeepSeek V3 и R1: какое железо нужно для полной модели
Какой сервер для DeepSeek V3 и R1 нужен, чтобы запустить полную модель на 671B: сколько памяти занимают веса и варианты на H200, B200, Ascend и RTX PRO 6000.
gpt-oss-120b и gpt-oss-20b: на каком железе запускать
Сколько памяти нужно gpt-oss-120b и gpt-oss-20b, открытым моделям OpenAI: веса в MXFP4, какие GPU подходят, сколько пользователей потянет карта и чем запускать.
Qwen3 локально: какие GPU нужны для моделей 8B, 32B и 235B
Как запустить Qwen3 локально или на своём сервере: сколько памяти нужно моделям от 8B до 235B в BF16, FP8 и 4 битах и какие GPU и серверы под них подойдут.
vLLM, Ollama или SGLang: чем запускать LLM на сервере
vLLM или Ollama, SGLang или TensorRT-LLM: чем отличаются движки для запуска LLM, что выбрать для сервиса на компанию и как движок влияет на выбор GPU.
Обзоры
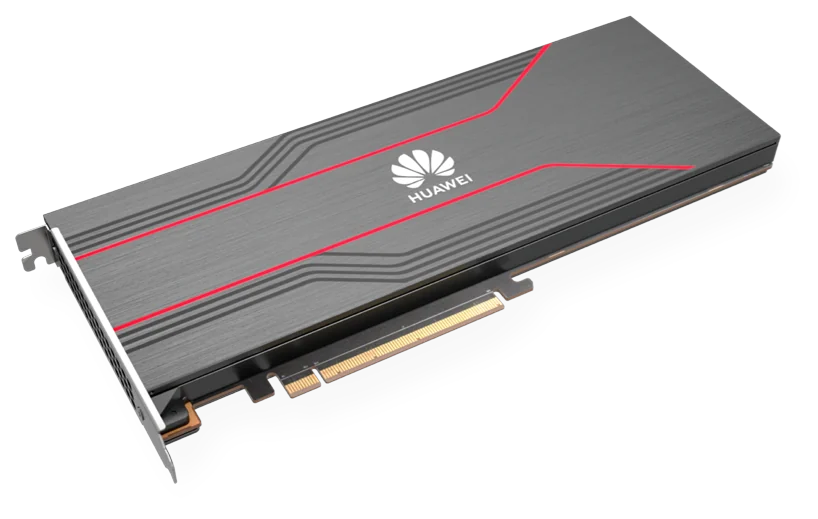
Huawei Atlas 300I Duo: обзор карты на 96 ГБ для инференса
Обзор Huawei Atlas 300I Duo: характеристики, два чипа Ascend 310P и 96 ГБ памяти при 150 Вт, какие LLM и задачи видеоаналитики потянет и чем уступает картам на HBM.
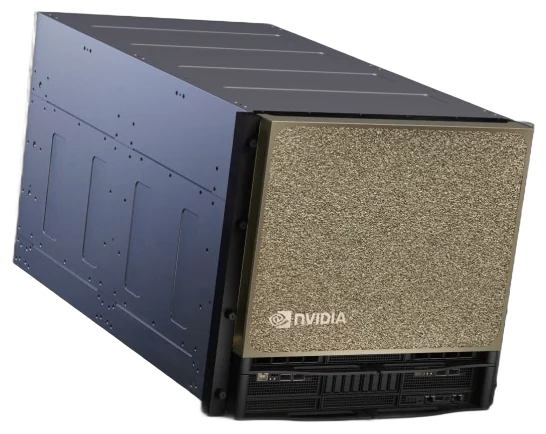
NVIDIA DGX B300: обзор флагманской системы на Blackwell Ultra
Обзор NVIDIA DGX B300: характеристики, чем система на Blackwell Ultra отличается от DGX B200, для каких задач она нужна и что подготовить под питание и сеть.
NVIDIA DGX Spark: обзор, характеристики и для чего он нужен
Обзор NVIDIA DGX Spark на суперчипе GB10 Grace Blackwell: характеристики, какие LLM помещаются в 128 ГБ, скорость генерации, связка из двух систем и альтернативы.
NVIDIA H200 NVL: обзор PCIe-ускорителя на 141 ГБ для LLM
Обзор NVIDIA H200 NVL: характеристики, чем PCIe-версия отличается от SXM, какие LLM помещаются в 141 ГБ HBM3e и когда выбрать её вместо RTX PRO 6000.
RTX PRO 6000 Blackwell: обзор карты на 96 ГБ для ИИ
Обзор RTX PRO 6000 Blackwell: характеристики, версии Workstation, Max-Q и Server Edition, какие LLM помещаются в 96 ГБ и чем карта отличается от RTX 5090 и H200 NVL.
Инфраструктура
Аренда GPU-сервера или свой сервер: что выгоднее для компании
Аренда GPU-сервера или покупка своего: формула сравнения, точка безубыточности по загрузке, скрытые расходы, данные и доступность GPU. Когда выгоден гибрид.
Как купить серверы и видеокарты NVIDIA в России: порядок закупки
Как купить сервер NVIDIA в России юрлицу: шаги от задачи до приёмки, что указать в запросе, что проверить в предложении и договоре, как принять оборудование.
Питание и охлаждение GPU-сервера: что подготовить до поставки
Охлаждение и питание GPU-сервера: сколько потребляют системы на 8 GPU, как отвести 10–14 кВт тепла, какие нужны линии и ИБП. Чек-лист серверной до поставки.
InfiniBand или Ethernet: какая сеть нужна для GPU-кластера
InfiniBand или Ethernet с RoCE для GPU-кластера: когда сеть между серверами критична, чем отличаются технологии и что заложить при покупке первого сервера.
Получить предложение
Опишите задачу или пришлите спецификацию. Ответим в течение рабочего дня с ценой и сроком поставки.