Запуск моделей
vLLM, Ollama или SGLang: чем запускать LLM на сервере
vLLM или Ollama, SGLang или TensorRT-LLM: чем отличаются движки для запуска LLM, что выбрать для сервиса на компанию и как движок влияет на выбор GPU.
Содержание
- Что делает движок и почему от него зависит число GPU
- Ollama и llama.cpp: проще всего начать
- vLLM: стандарт для сервиса на много пользователей
- SGLang: когда запросы начинаются одинаково
- TensorRT-LLM и движки для Huawei Ascend
- Как движок влияет на выбор железа
- vLLM или Ollama и другие: сравнение и выбор по сценарию
- Коротко
Вопрос «vLLM или Ollama» решает число пользователей. Ollama подходит одному человеку и пилоту: модель запускается одной командой. vLLM нужен, когда к модели одновременно обращаются десятки сотрудников или приложений через API. SGLang выбирают для агентов, RAG и DeepSeek, где запросы начинаются с одного и того же текста. TensorRT-LLM даёт максимум скорости на GPU NVIDIA, но сложнее в настройке, а на серверах Huawei Ascend ту же работу делают MindIE и vLLM Ascend.
Что делает движок и почему от него зависит число GPU
Движок инференса это программа, которая держит модель в памяти GPU и отвечает на запросы. Он загружает веса, хранит KV-кеш каждого диалога, принимает запросы по API и решает, в каком порядке и какими пачками их считать.
Модель и видеокарта могут быть одинаковыми, а пропускная способность под нагрузкой отличаться в разы. Всё решают две вещи: как движок объединяет запросы в пачки и как распределяет свободную память под кеш. Для одного пользователя разница почти незаметна, а для сотни она определяет, сколько GPU придётся купить.
Ollama и llama.cpp: проще всего начать
llama.cpp это движок на C++, который запускает модели на видеокартах, на Mac и даже на обычном процессоре. Ollama это удобная оболочка над тем же подходом: скачивает модель из каталога и запускает её одной командой. Модели хранятся в формате GGUF с готовыми вариантами квантования, например Q4_K_M (4 бита) или Q8_0 (8 бит).
Сильные стороны:
- установка за минуты на Linux, Windows и macOS;
- работает на GPU NVIDIA, на Mac и, медленно, на процессоре;
- большой каталог готовых квантованных моделей;
- HTTP API, в том числе совместимый с API OpenAI.
Слабое место проявляется под нагрузкой. Эти движки сделаны ради простоты, а не ради пропускной способности: при десятках одновременных запросов vLLM и SGLang распределяют память и объединяют запросы заметно эффективнее. И ещё деталь: если модель не помещается в одну карту, Ollama раскладывает её слои по нескольким GPU, но карты работают по очереди. Памяти становится больше, а скорость одного диалога не растёт.
Когда Ollama для компании оправдана
- Пилот: показать руководству, как модель отвечает на ваших документах.
- Рабочее место разработчика или аналитика.
- Небольшая команда, где запросы редко приходят одновременно.
Когда сервисом начинает пользоваться отдел, пора переходить на vLLM. Приложения почти не придётся переписывать, если они уже обращались к OpenAI-совместимому API.
vLLM: стандарт для сервиса на много пользователей
vLLM стал стандартом для многопользовательских сервисов благодаря трём вещам.
- PagedAttention. KV-кеш хранится небольшими страницами, примерно как оперативная память в операционной системе. Память не простаивает в кусках, зарезервированных «на всякий случай» под длинный ответ, и в те же гигабайты помещается больше диалогов.
- Непрерывный батчинг. Новый запрос встаёт в работу сразу, не дожидаясь, пока закончатся остальные. GPU загружен постоянно, а пользователи не стоят в очереди.
- OpenAI-совместимый API. Чат-боты, плагины и библиотеки, написанные под API OpenAI, начинают работать с вашим vLLM-сервером после смены адреса и ключа.
Кроме того, vLLM умеет делить одну модель на несколько GPU (тензорный параллелизм), работает с FP8 и 4-битными форматами AWQ и GPTQ, кеширует общие префиксы запросов и поддерживает большинство популярных открытых моделей. Цена удобства: нужен Linux, а параметры вроде доли памяти под кеш и максимальной длины контекста стоит подобрать под вашу нагрузку.
SGLang: когда запросы начинаются одинаково
SGLang решает ту же задачу, что vLLM, и тоже даёт OpenAI-совместимый API. Его главная особенность называется RadixAttention: движок запоминает KV-кеш общего начала запросов и переиспользует его, вместо того чтобы считать заново.
Выигрыш заметен там, где у запросов много общего текста:
- агенты, которые раз за разом отправляют модели длинную инструкцию с описанием инструментов;
- поиск по базе знаний с одинаковым системным промптом во всех запросах;
- серия вопросов к одному большому документу;
- многошаговые цепочки, где каждый шаг продолжает предыдущий.
В vLLM кеширование префиксов тоже есть, но в SGLang вокруг него построена вся архитектура. Второй повод выбрать SGLang: сильная поддержка DeepSeek V3 и R1, поэтому его часто берут именно для этих моделей.
TensorRT-LLM и движки для Huawei Ascend
TensorRT-LLM это библиотека NVIDIA, которая оптимизирует модель под конкретный GPU. Она выжимает из карт NVIDIA максимум скорости, но требует больше времени на подготовку и настройку, чем vLLM. Если нужен готовый результат без глубокой настройки, у NVIDIA есть NIM: контейнеры с уже оптимизированными моделями.
На серверах Huawei, например Atlas 800I A2 на восьми Ascend 910B, работают два варианта. MindIE это собственный движок инференса Huawei поверх CANN. vLLM Ascend это плагин, который запускает vLLM на NPU Ascend: API и большинство параметров те же, что на NVIDIA, и команде не придётся переучиваться. Популярные открытые модели, включая DeepSeek и Qwen, запускаются на Ascend через оба движка.
Как движок влияет на выбор железа
Память сверх весов уходит под кеш
vLLM и SGLang при старте занимают почти всю свободную память GPU и отдают её под KV-кеш. Чем больше памяти остаётся после весов, тем больше диалогов карта ведёт одновременно.
Возьмём Llama 3.3 70B в FP8: веса около 70 ГБ, кеш в FP16 около 0,31 МБ на токен. На RTX PRO 6000 с 96 ГБ после весов и служебных буферов под кеш остаётся 10–20 ГБ: один-два диалога по 32 тысячи токенов или около десятка диалогов по 4 тысячи. На H200 NVL со 141 ГБ остаётся около 60 ГБ, и одновременных диалогов в несколько раз больше. Как посчитать кеш под свою модель, мы разобрали в статье о видеопамяти для LLM.
Связь между GPU
Если модель не помещается в одну карту, vLLM и SGLang режут каждый слой на части по нескольким GPU. Карты обмениваются данными на каждом слое, и скорость связи между ними начинает влиять на скорость ответа:
- H200 NVL соединяются NVLink-мостом на 2 или 4 карты, 900 ГБ/с;
- RTX PRO 6000 общаются через PCIe 5.0 x16, это около 64 ГБ/с в каждую сторону.
Поэтому на сервере Gigabyte с восемью RTX PRO 6000 часто разумнее запустить несколько независимых копий модели, по одной на карту или пару карт, и распределять запросы между ними. Резать одну модель на все восемь карт имеет смысл, когда иначе она не помещается: например, Qwen3 235B в FP8 или DeepSeek V3 в 4 битах.
Формат весов
FP8 аппаратно поддерживается в Hopper и Blackwell, FP4 (NVFP4) только в Blackwell. Выигрыш в памяти и скорости будет, только если движок умеет работать с этим форматом на вашей карте. TensorRT-LLM поддерживает FP4 на Blackwell, в vLLM и SGLang поддержка новых форматов быстро развивается, поэтому конкретную модель и версию движка стоит проверить заранее.
vLLM или Ollama и другие: сравнение и выбор по сценарию
| Движок | Сильная сторона | Типичный сценарий | Много одновременных запросов | Сложность запуска |
|---|---|---|---|---|
| Ollama / llama.cpp | запуск одной командой, GGUF | пилот, рабочее место | слабое место | минимальная |
| vLLM | PagedAttention, непрерывный батчинг | сервис на отдел или компанию | да | средняя |
| SGLang | переиспользование общего префикса | агенты, RAG, DeepSeek | да | средняя |
| TensorRT-LLM | максимум скорости на NVIDIA | нагруженный сервис | да | высокая |
| MindIE, vLLM Ascend | стек Huawei | серверы Atlas | да | средняя |
Что выбрать:
- Один разработчик пробует модели. Ollama на рабочей станции или ноутбуке.
- Сервис на отдел или компанию через API. vLLM на одной-двух картах RTX PRO 6000 или H200 NVL. Как подобрать остальную конфигурацию, читайте в статье о сервере для локальной LLM.
- Ассистент с поиском по документам, агенты. SGLang или vLLM с кешированием префиксов. Расчёт железа под такой сервис есть в материале о корпоративном RAG.
- DeepSeek V3 или R1 целиком. SGLang или vLLM на сервере с восемью GPU.
- Нагруженный сервис и опытная команда. TensorRT-LLM или NIM.
- Серверы Huawei. MindIE или vLLM Ascend.
Начать можно с Ollama на пилоте, а на vLLM перейти, когда появятся пользователи. Железо остаётся тем же, меняется формат весов: вместо GGUF берутся веса в формате Hugging Face.
Коротко
- Ollama и llama.cpp: один пользователь, пилот, формат GGUF, запуск за минуты.
- vLLM: стандарт для сервиса на много пользователей с OpenAI-совместимым API.
- SGLang: агенты, RAG и DeepSeek, где запросы начинаются одинаково.
- TensorRT-LLM даёт максимум скорости на NVIDIA ценой сложности, на Ascend работают MindIE и vLLM Ascend.
- Память сверх весов уходит под кеш и определяет, сколько диалогов одна карта ведёт одновременно.
Расскажите, какую модель и для скольких пользователей вы хотите запустить: оставьте заявку, и мы подберём железо и подскажем подходящий движок. Цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
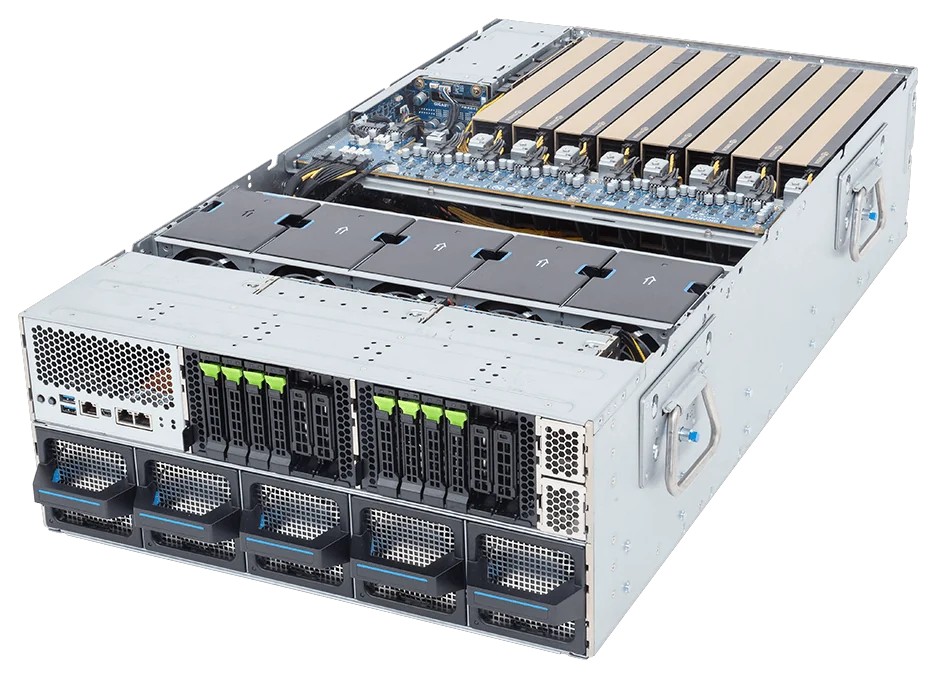
Gigabyte
Gigabyte XL44-SX2
Восемь RTX PRO 6000 в одном сервере: 768 ГБ памяти GPU.
- RTX PRO 6000
- 8GPU
- Память GPU
- 768ГБ
- Высота
- 4U
Цена по запросу
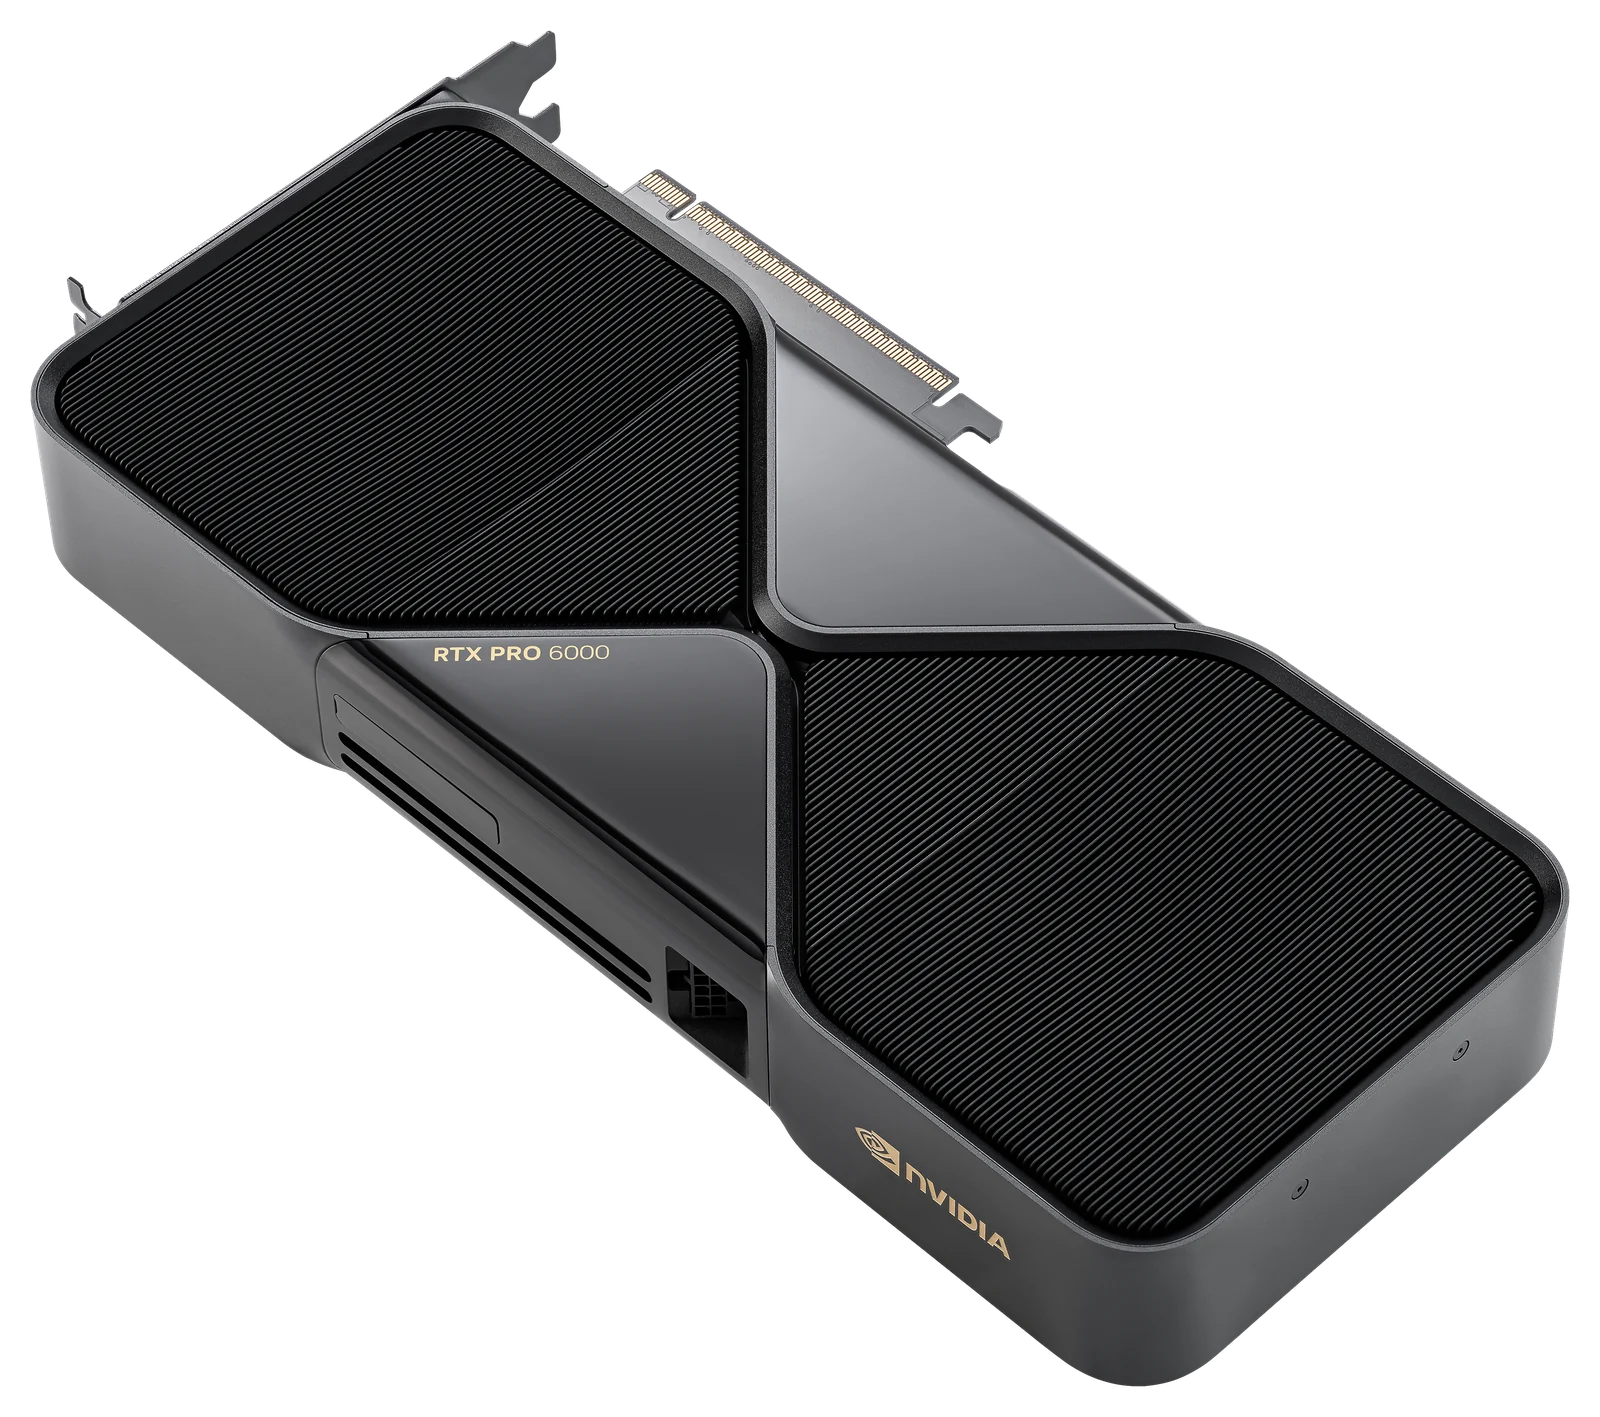
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
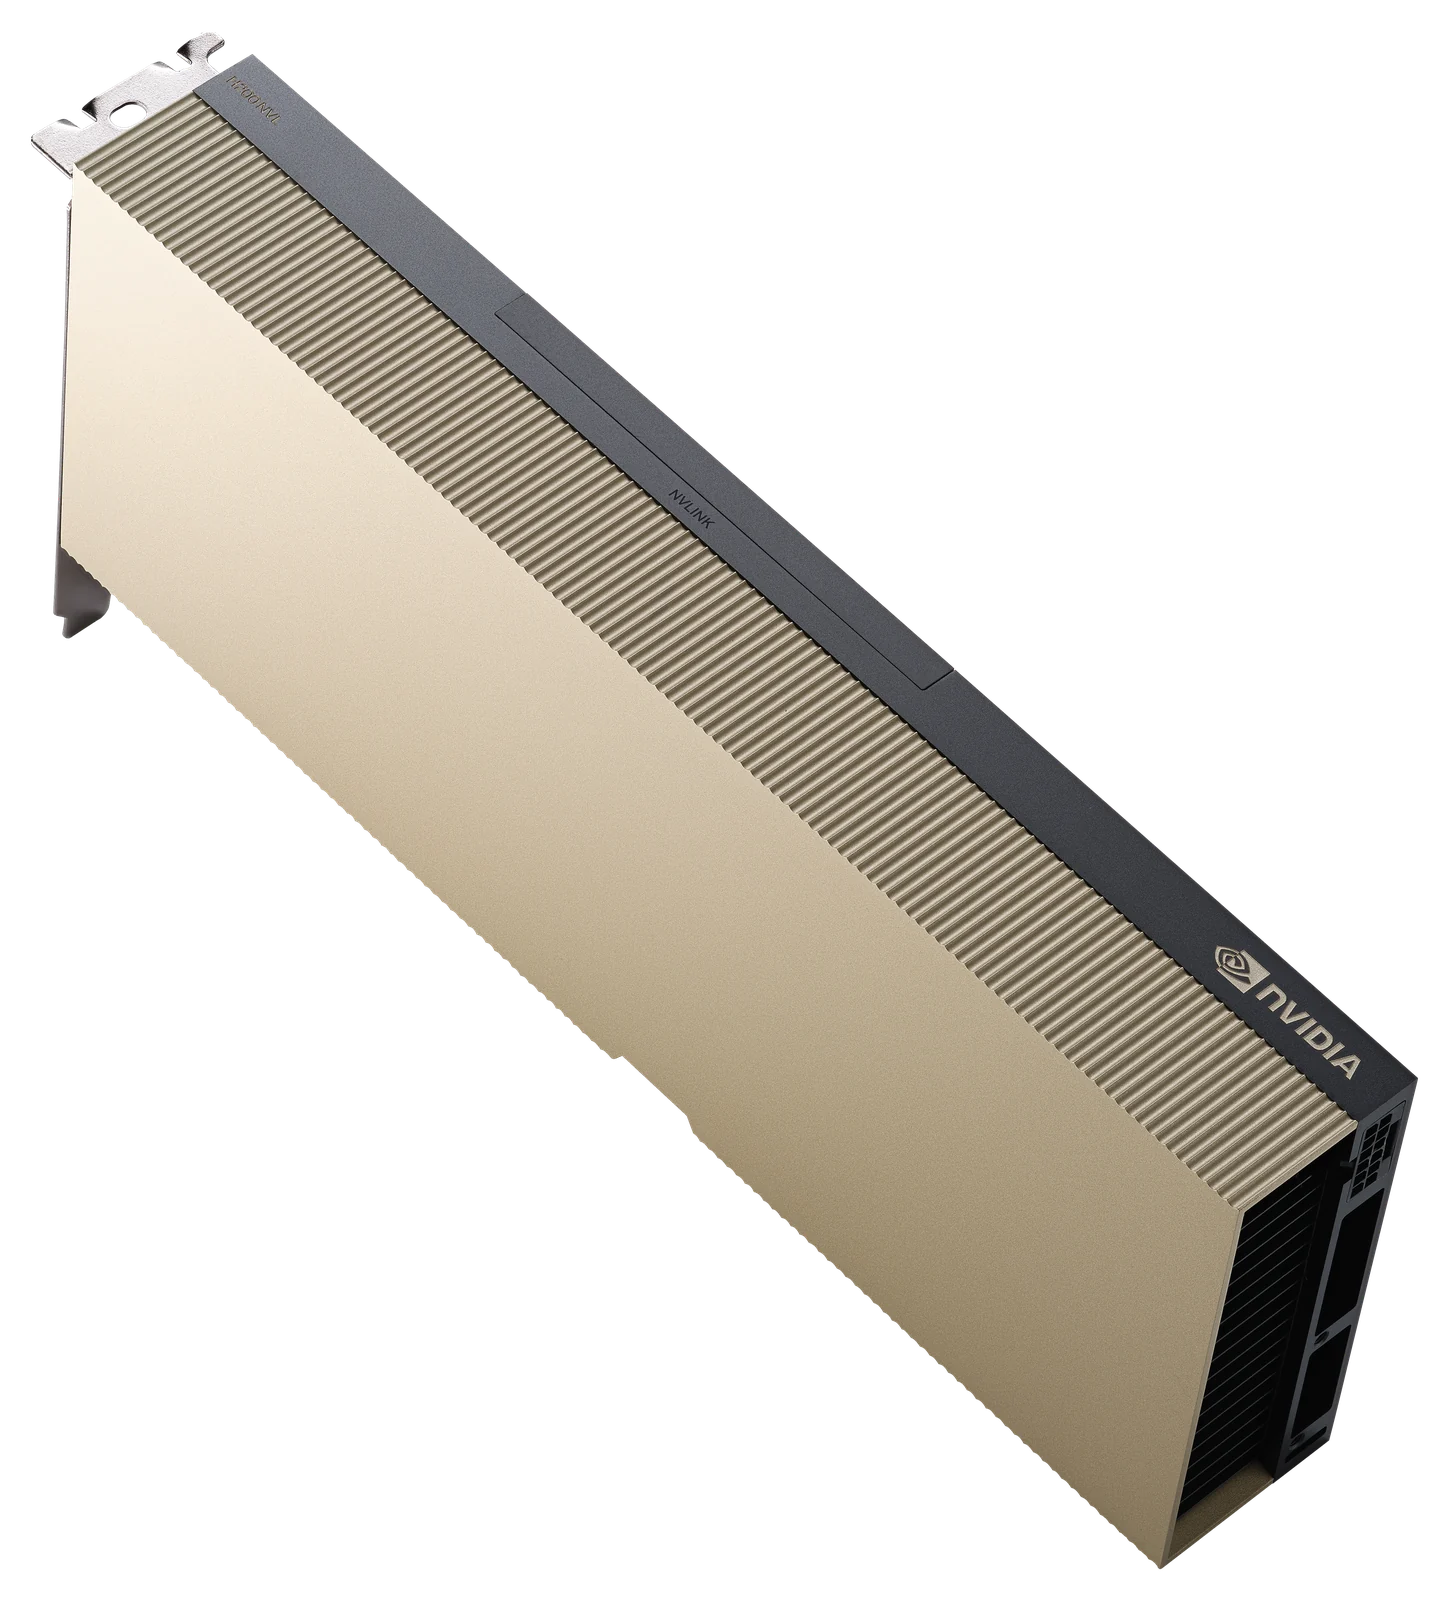
NVIDIA
H200 NVL
Больше всего памяти в формате PCIe: 141 ГБ HBM3e на карту.
- HBM3e
- 141ГБ
- Скорость памяти
- 4,8ТБ/с
- FP8
- 3341TFLOPS
Цена по запросу
Читайте также
Сервер для локальной LLM в компании: как подобрать конфигурацию
Как подобрать сервер для LLM в компании: расчёт памяти под модель и пользователей, KV-кеш, три типовые конфигурации от отдела до крупного сервиса и софт для запуска.
Корпоративный ИИ-ассистент и RAG: какое железо нужно компании
Какое железо нужно корпоративному ИИ-ассистенту на базе RAG: из чего состоит система, что потребляет память GPU и расчёт на 50, 300 и 1 000 сотрудников.
Qwen3 локально: какие GPU нужны для моделей 8B, 32B и 235B
Как запустить Qwen3 локально или на своём сервере: сколько памяти нужно моделям от 8B до 235B в BF16, FP8 и 4 битах и какие GPU и серверы под них подойдут.