Выбор оборудования
Сервер для обучения нейросетей: что важно кроме GPU
Сервер для обучения нейросетей: сколько памяти GPU нужно на параметр, зачем NVLink и быстрая сеть, какое хранилище и питание заложить и когда хватит одной карты.
Содержание
Сервер для обучения нейросетей выбирают прежде всего по памяти GPU и скорости связи между картами, а уже потом по сети, хранилищу и питанию. При полном обучении на каждый параметр модели уходит около 16–18 байт, поэтому модели 8B нужно примерно 130–145 ГБ памяти GPU, а модели 70B больше 1 ТБ: это как минимум восемь B200 с 1 440 ГБ в одном сервере, а на практике чаще несколько серверов. Если же задача в дообучении через LoRA или QLoRA, часто хватает одной карты.
Чем обучение отличается от инференса
Один и тот же GPU при обучении и при запуске модели нагружается по-разному. Поэтому сервер, который отлично отвечает пользователям, может плохо подходить для обучения.
| Инференс | Обучение | |
|---|---|---|
| Память на параметр | 0,5–2 байта | 16–18 байт плюс активации |
| Узкое место | скорость памяти | вычисления и связь между GPU |
| Обмен между GPU | если модель поделена на части | на каждом шаге |
| Длительность задачи | секунды на запрос | дни и недели без перерыва |
| Данные | запросы пользователей | датасет и контрольные точки |
Откуда 16–18 байт. Веса в BF16 занимают 2 байта, градиенты ещё 2, основная копия весов в FP32 4 байта, два состояния оптимизатора Adam по 4 байта. Сверху идут активации: промежуточные результаты прямого прохода, которые нужны для обратного. Их объём растёт с размером батча и длиной последовательностей.
Сколько памяти нужно серверу для обучения нейросетей
Память под веса, градиенты и оптимизатор без учёта активаций:
| Модель | Полное обучение | LoRA, база в BF16 | QLoRA, база в 4 битах | Что нужно для полного обучения |
|---|---|---|---|---|
| 8B | 128–144 ГБ | 16 ГБ + адаптеры | 4 ГБ + адаптеры | сервер на 8 GPU: Atlas 800T A2, DGX H200 |
| 32B | 512–576 ГБ | 64 ГБ + адаптеры | 16 ГБ + адаптеры | 8 × H200 или 8 × B200 |
| 70B | 1 120–1 260 ГБ | 140 ГБ + адаптеры | около 48 ГБ в сумме | 8 × B200 впритык, чаще кластер |
| 235B | 3 760–4 230 ГБ | 470 ГБ + адаптеры | ~118 ГБ + адаптеры | кластер из нескольких серверов |
Активации добавляют сверху ещё заметный объём, он зависит от размера батча и длины последовательностей. Его сокращают пересчётом активаций (gradient checkpointing) и распределением состояния оптимизатора между GPU через FSDP или DeepSpeed ZeRO. Но основной объём никуда не девается: полное обучение модели 70B не помещается даже в 1 128 ГБ восьми H200.
Связь между GPU внутри сервера: NVLink и HCCS
При обучении на нескольких GPU карты обмениваются градиентами на каждом шаге, а крупную модель ещё и делят на части. Если связь медленная, дорогие GPU простаивают в ожидании данных.
- NVLink 4 (Hopper): 900 ГБ/с на GPU. Так связаны восемь H200 в DGX H200.
- NVLink 5 (Blackwell): 1,8 ТБ/с на GPU. В DGX B200 это 14,4 ТБ/с суммарно на восемь карт.
- PCIe 5.0 x16: около 64 ГБ/с в каждую сторону, на порядок медленнее NVLink. Так общаются карты без NVLink, например RTX PRO 6000.
- HCCS у Huawei: собственная шина между чипами Ascend внутри сервера, роль аналогична NVLink.
Вывод простой: для обучения на нескольких GPU нужен сервер с NVLink или HCCS, а серверы на картах PCIe лучше оставить для инференса и дообучения.
Серверы для обучения в каталоге:
| Сервер | GPU | Память GPU | Связь GPU | Процессоры | Питание | Высота |
|---|---|---|---|---|---|---|
| DGX H200 | 8 × H200 SXM | 1 128 ГБ HBM3e | NVLink, 900 ГБ/с на GPU | 2 × Xeon Platinum 8480C | до 10,2 кВт | 8U |
| DGX B200 | 8 × B200 | 1 440 ГБ HBM3e | NVLink 5, 14,4 ТБ/с суммарно | 2 × Xeon Platinum 8570 | до 14,3 кВт | 10U |
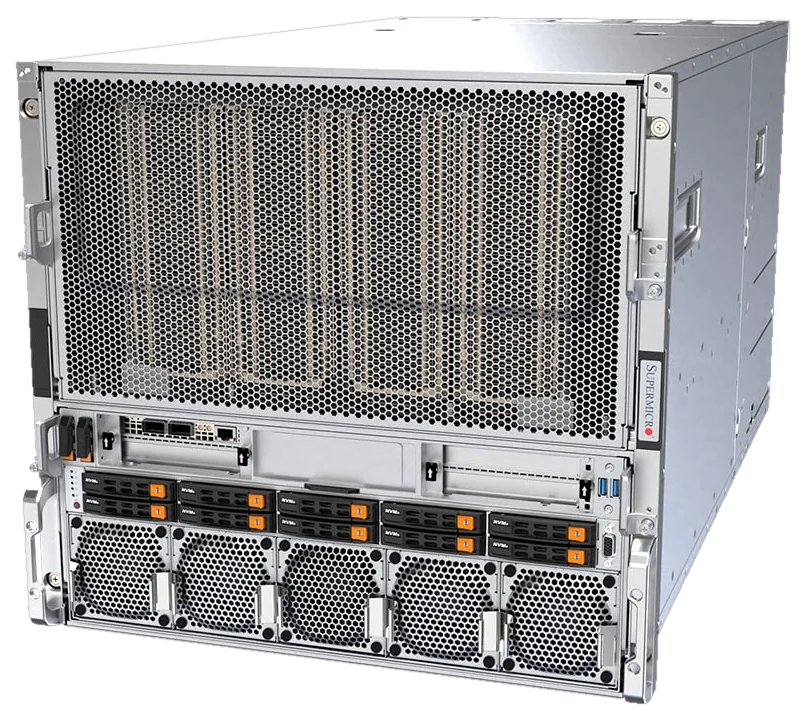
| Supermicro SYS-A22GA-NBRT | 8 × B200 (HGX) | 1 440 ГБ HBM3e | NVLink 5 | 2 × Xeon 6900 | 6 × 5250 Вт с резервированием | 10U |
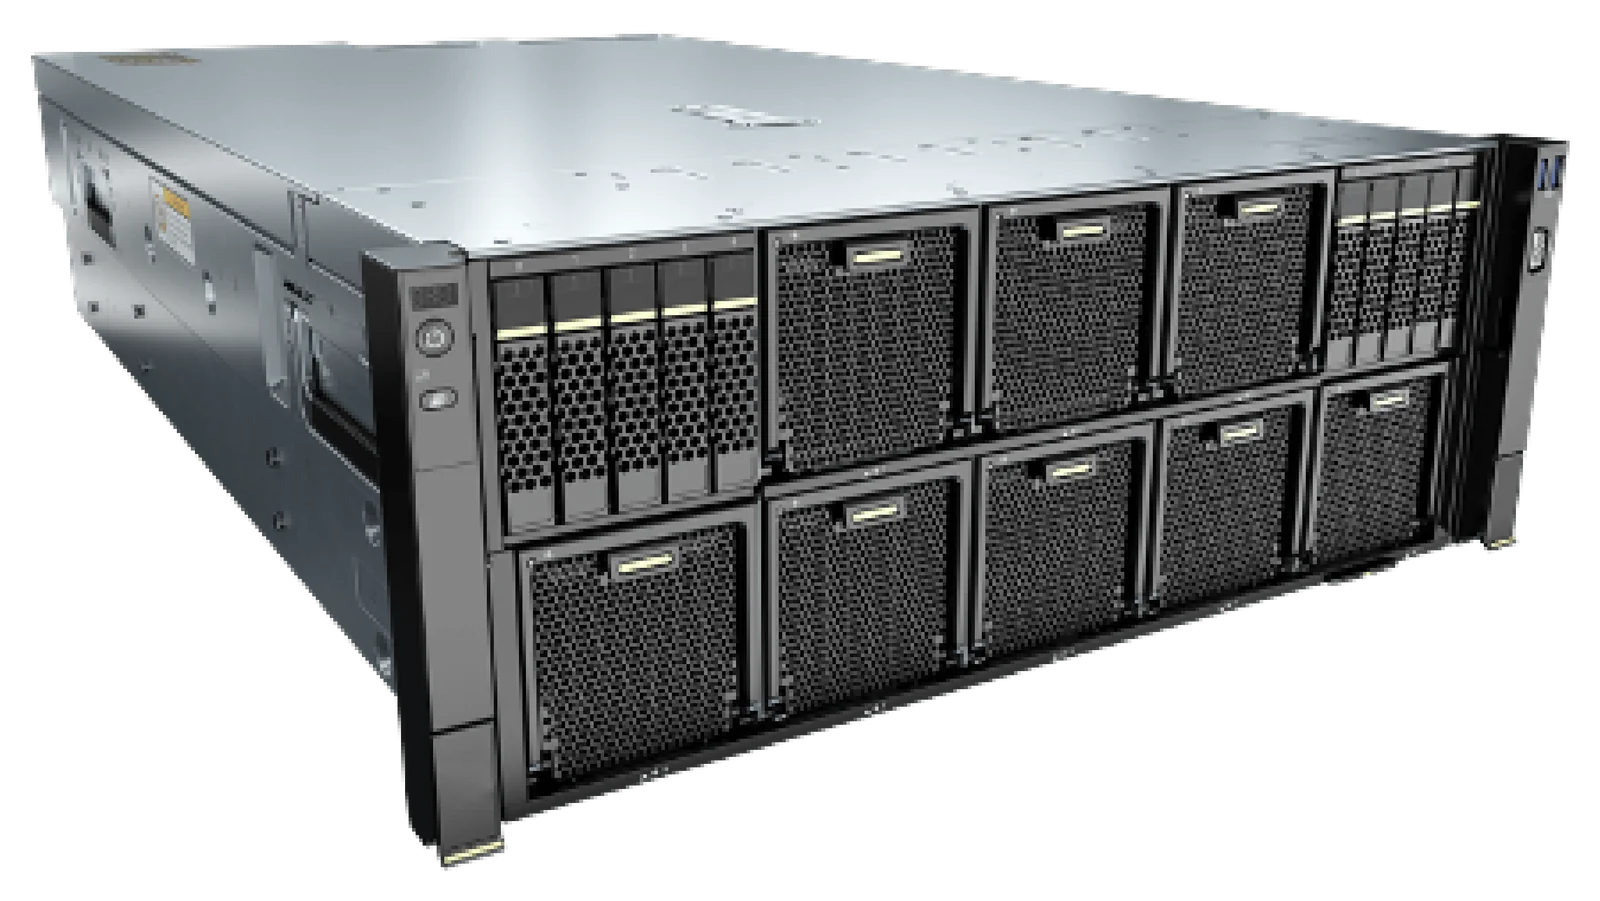
| Huawei Atlas 800T A2 | 8 × Ascend 910B | 512 ГБ HBM | HCCS | 4 × Kunpeng 920 | до 5,8 кВт | 4U |
По данным NVIDIA, DGX B200 втрое быстрее DGX H100 в обучении. Supermicro SYS-A22GA-NBRT построен на той же плате HGX B200 с восемью GPU по 180 ГБ, но процессоры, память, диски и сеть в нём можно подобрать под задачу. Atlas 800T A2 подходит тем, кто строит инфраструктуру на стеке Huawei: восемь Ascend 910B и до 3 ПФЛОПС в FP16 при потреблении до 5,8 кВт.
Сеть между серверами
Пока обучение идёт внутри одного сервера, внешняя сеть почти не влияет на скорость. Когда серверов несколько, градиенты синхронизируются уже по сети, и она становится узким местом.
- Порт на каждый GPU. Типичная схема обучающего кластера: у каждого GPU свой сетевой порт 400G. В DGX H200 так и сделано: 8 × 400 Гбит/с ConnectX-7. В Supermicro SYS-A22GA-NBRT под сетевые карты есть десять низкопрофильных слотов PCIe 5.0 x16 и два FHHL.
- InfiniBand или Ethernet. InfiniBand NDR даёт 400 Гбит/с на порт, XDR 800 Гбит/с. Альтернатива: Ethernet с RoCE, например NVIDIA Spectrum-X. В Atlas 800T A2 восемь портов 200GE RoCE.
- GPUDirect RDMA. GPU обмениваются данными по сети напрямую, минуя CPU.
- Отдельные сети. Хранилище и управление выносят в свои сети, чтобы загрузка данных не мешала синхронизации градиентов.
Даже порт 400 Гбит/с (около 50 ГБ/с) в десятки раз медленнее NVLink 5 внутри сервера. Поэтому модель делят так, чтобы самый интенсивный обмен шёл внутри сервера, а между серверами только то, без чего не обойтись. Подробно о выборе сети в статье «InfiniBand или Ethernet».
Хранилище, процессоры и оперативная память
GPU должны получать данные быстрее, чем успевают их обрабатывать, иначе они простаивают. Именно здесь сервер для машинного обучения чаще всего недооценивают.
- Хранилище. Кроме датасета, есть контрольные точки: при полном обучении в них сохраняются веса и состояние оптимизатора, для модели 70B это порядка терабайта на одну точку. Нужны быстрые локальные NVMe (в SYS-A22GA-NBRT их десять, формата U.2), а для кластера отдельная система хранения со своей сетью.
- Процессоры. CPU читают и декодируют данные, токенизируют текст, готовят изображения. В DGX H200 и DGX B200 стоят по два Xeon Platinum, всего 112 ядер, в SYS-A22GA-NBRT два Xeon 6900 до 128 ядер.
- Оперативная память. В DGX H200 её 2 ТБ, в DGX B200 до 4 ТБ, в SYS-A22GA-NBRT до 6 ТБ. ОЗУ нужна под буферы загрузки данных и под выгрузку состояния оптимизатора, если памяти GPU не хватает.
Питание и охлаждение
GPU-сервер для обучения моделей работает на полной мощности сутками, поэтому считать нужно по максимальному потреблению, а не по среднему. DGX H200 потребляет до 10,2 кВт, DGX B200 до 14,3 кВт, Atlas 800T A2 до 5,8 кВт.
Всё это превращается в тепло: 14,3 кВт соответствуют примерно 48 800 BTU/ч, и столько же должно отвести охлаждение. Обычная серверная и типичная стойка часто не рассчитаны на такую плотность.
Что проверить до поставки:
- выделенные линии питания под суммарную мощность и ИБП;
- резервирование блоков питания (в SYS-A22GA-NBRT шесть блоков по 5250 Вт с резервированием);
- мощность кондиционирования в серверной;
- высоту и место в стойке: от 4U у Atlas 800T A2 до 10U у DGX B200.
Подробный чек-лист в статье о питании и охлаждении GPU-сервера.
Когда хватит одной карты
Не каждой команде нужен сервер на восемь GPU. Чтобы адаптировать готовую модель под свои данные и стиль, чаще всего хватает LoRA или QLoRA.
- LoRA. Базовые веса в BF16 заморожены, обучаются небольшие адаптеры. Модели 8B нужно около 16 ГБ под базу плюс активации, это одна карта на 32–96 ГБ.
- QLoRA. База хранится в 4 битах, модель 70B помещается примерно в 48 ГБ. Это одна RTX PRO 6000 с 96 ГБ или H200 NVL со 141 ГБ.
- LoRA для 70B. Под базу в BF16 нужно около 140 ГБ, это уже две карты или сервер.
Для таких задач подходят Hugging Face TRL и PEFT, Unsloth, Axolotl, LLaMA-Factory. Когда дообучение оправдано и сколько GPU нужно под каждый метод, мы разобрали в статье о дообучении LLM.
Коротко
- Полное обучение требует около 16–18 байт памяти GPU на параметр плюс активации: модели 70B нужно больше 1 ТБ.
- Для обучения на нескольких GPU нужна быстрая связь внутри сервера: NVLink у NVIDIA, HCCS у Huawei.
- Для кластера закладывайте сетевой порт 400G на каждый GPU, отдельную сеть хранилища и быстрые NVMe.
- Считайте питание и охлаждение по максимуму: DGX B200 потребляет до 14,3 кВт.
- Для QLoRA и LoRA небольших моделей часто хватает одной карты на 96–141 ГБ.
Опишите модель, объём данных и сроки, и мы подберём сервер для обучения на NVIDIA или Huawei, а также сеть и хранилище под него: оставьте заявку, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
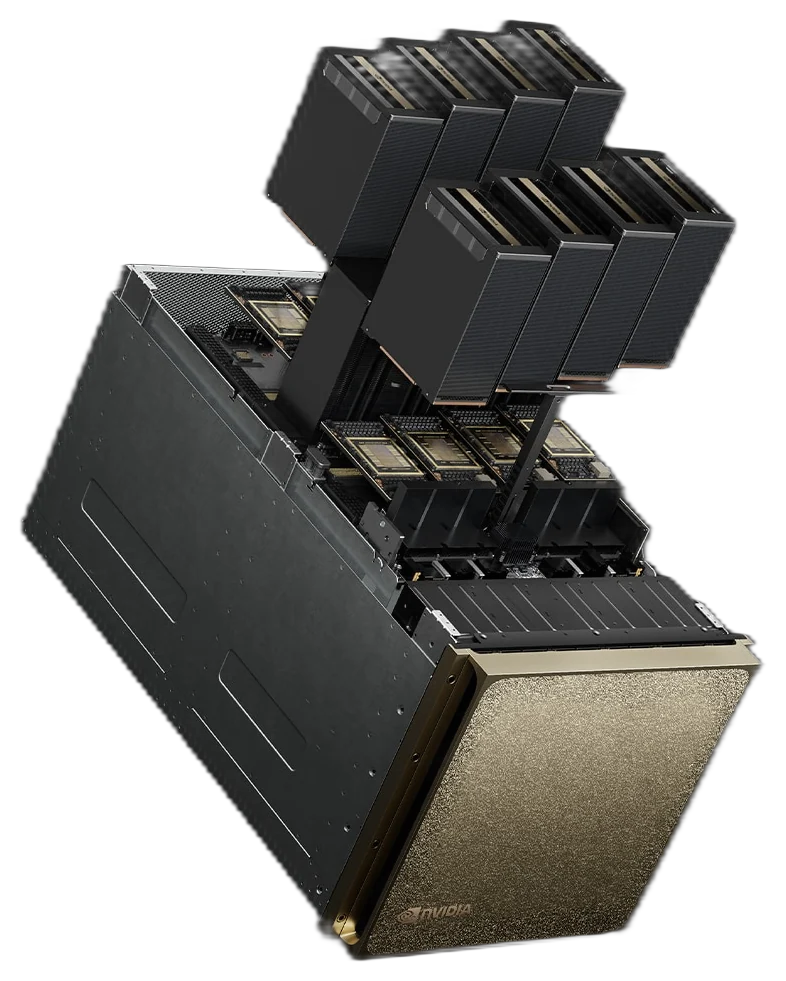
NVIDIA
DGX B200
Blackwell для обучения и инференса: 1,44 ТБ памяти GPU.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- FP4
- 144ПФЛОПС
Цена по запросу
Supermicro
Supermicro SYS-A22GA-NBRT
Сервер на HGX B200: Blackwell без переплаты за бренд DGX.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- Высота
- 10U
Цена по запросу
Huawei
Atlas 800T A2
Сервер обучения на восьми Ascend 910B.
- Ascend 910B
- 8NPU
- Память HBM
- 512ГБ
- FP16
- 3ПФЛОПС
Цена по запросу
Читайте также
Дообучение LLM: сколько GPU нужно для LoRA и полного обучения
Сколько памяти и GPU нужно для дообучения LLM методами LoRA, QLoRA и полного обучения: таблица для моделей 8B, 32B и 70B, подбор железа и софт.
InfiniBand или Ethernet: какая сеть нужна для GPU-кластера
InfiniBand или Ethernet с RoCE для GPU-кластера: когда сеть между серверами критична, чем отличаются технологии и что заложить при покупке первого сервера.
DGX или HGX: NVIDIA DGX или сервер Supermicro на тех же GPU
DGX или HGX: чем готовая система NVIDIA отличается от сервера Supermicro на той же плате с восемью GPU. Сравниваем DGX B200, DGX H200 и HGX-серверы, кому что подходит.