Сравнения
DGX Spark, Mac Studio или RTX 5090: что выбрать для локальных LLM
DGX Spark vs Mac Studio и RTX 5090 для локальных LLM: объём и скорость памяти, CUDA, длинные промпты и теоретический потолок генерации. Кому что подходит.
Содержание
- Главное: объём памяти против скорости памяти
- DGX Spark vs Mac Studio: CUDA или максимум памяти
- DGX Spark или RTX 5090: память против скорости
- Сравнение: память, скорость и теоретический потолок генерации
- Длинные промпты и RAG: где Mac проигрывает
- Какой компьютер для локальных LLM выбрать
- Если нужно больше: RTX PRO 6000 и DGX Station
- Коротко
Выбор DGX Spark vs Mac Studio сводится к тому, что важнее: стек NVIDIA или максимум памяти. DGX Spark даёт 128 ГБ единой памяти и CUDA, как в дата-центре, но память у него медленная, 273 ГБ/с. Mac Studio на M3 Ultra берёт объёмом, до 512 ГБ при 819 ГБ/с, но работает без CUDA и медленнее обрабатывает длинные промпты. RTX 5090 генерирует быстрее всех (1,79 ТБ/с), но в её 32 ГБ помещаются только модели примерно до 32B в 4 битах.
Главное: объём памяти против скорости памяти
Для локальной языковой модели важны три характеристики, и каждая влияет на своё.
- Объём памяти решает, поместится ли модель вместе с кешем под контекст.
- Скорость памяти решает, как быстро модель пишет ответ. Для каждого нового токена она читает все веса, поэтому теоретический потолок для одного диалога ≈ скорость памяти ÷ объём весов.
- Вычислительная мощность решает, как быстро модель прочитает ваш запрос. Промпт обрабатывается целиком и параллельно, здесь работают ядра, а не память. На длинных документах эта фаза становится заметной.
Ни одно из трёх устройств не выигрывает по всем пунктам сразу. Поэтому правильный вопрос звучит не «что лучше», а «какие модели и какие запросы у вас будут».
DGX Spark vs Mac Studio: CUDA или максимум памяти
DGX Spark
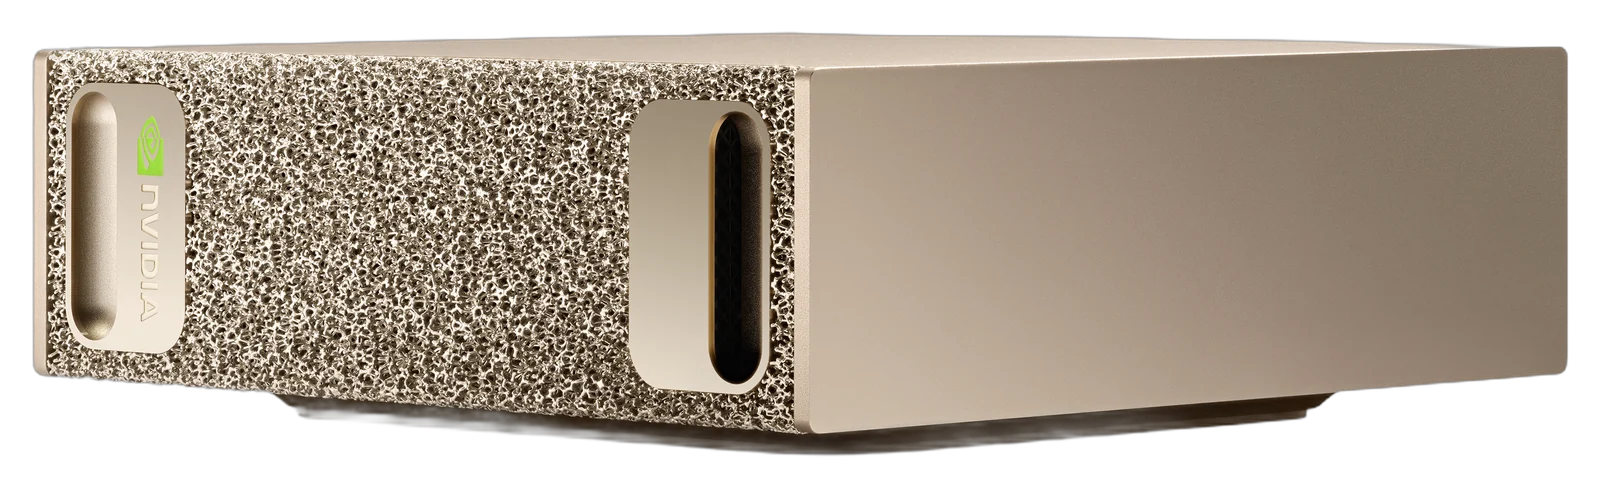
DGX Spark построен на суперчипе GB10 Grace Blackwell: 20 ядер Arm и GPU Blackwell с общей памятью 128 ГБ LPDDR5x.
- До 1 ПФЛОПС в FP4 по данным NVIDIA, потребление 240 Вт, корпус 150 × 150 × 50,5 мм и 1,2 кг.
- DGX OS и стек NVIDIA: CUDA, те же библиотеки и контейнеры, что на серверах. Прототип, отлаженный на столе, проще перенести в дата-центр.
- Сеть ConnectX-7 на 200 Гбит/с позволяет связать две системы и запускать модели до 405B параметров.
- Слабое место: скорость памяти 273 ГБ/с.
Подробно о самой системе мы рассказали в обзоре DGX Spark.
Mac Studio
Mac Studio мы не продаём, но без него честного сравнения не получится.
- На M3 Ultra до 512 ГБ единой памяти со скоростью 819 ГБ/с, на M4 Max до 128 ГБ и 546 ГБ/с.
- Даже Mac Studio на M4 Max с теми же 128 ГБ читает память вдвое быстрее DGX Spark.
- CUDA нет. Модели запускаются через MLX, llama.cpp и Ollama. Для чата с одной моделью этого хватает, но TensorRT-LLM и любой код, завязанный на CUDA, на Mac не работают.
- Длинный промпт обрабатывается заметно медленнее, чем на GPU NVIDIA с тем же объёмом памяти.
Mac Studio для нейросетей хорош как личная машина для общения с очень крупной моделью. DGX Spark хорош как среда разработки под будущий сервер NVIDIA.
DGX Spark или RTX 5090: память против скорости
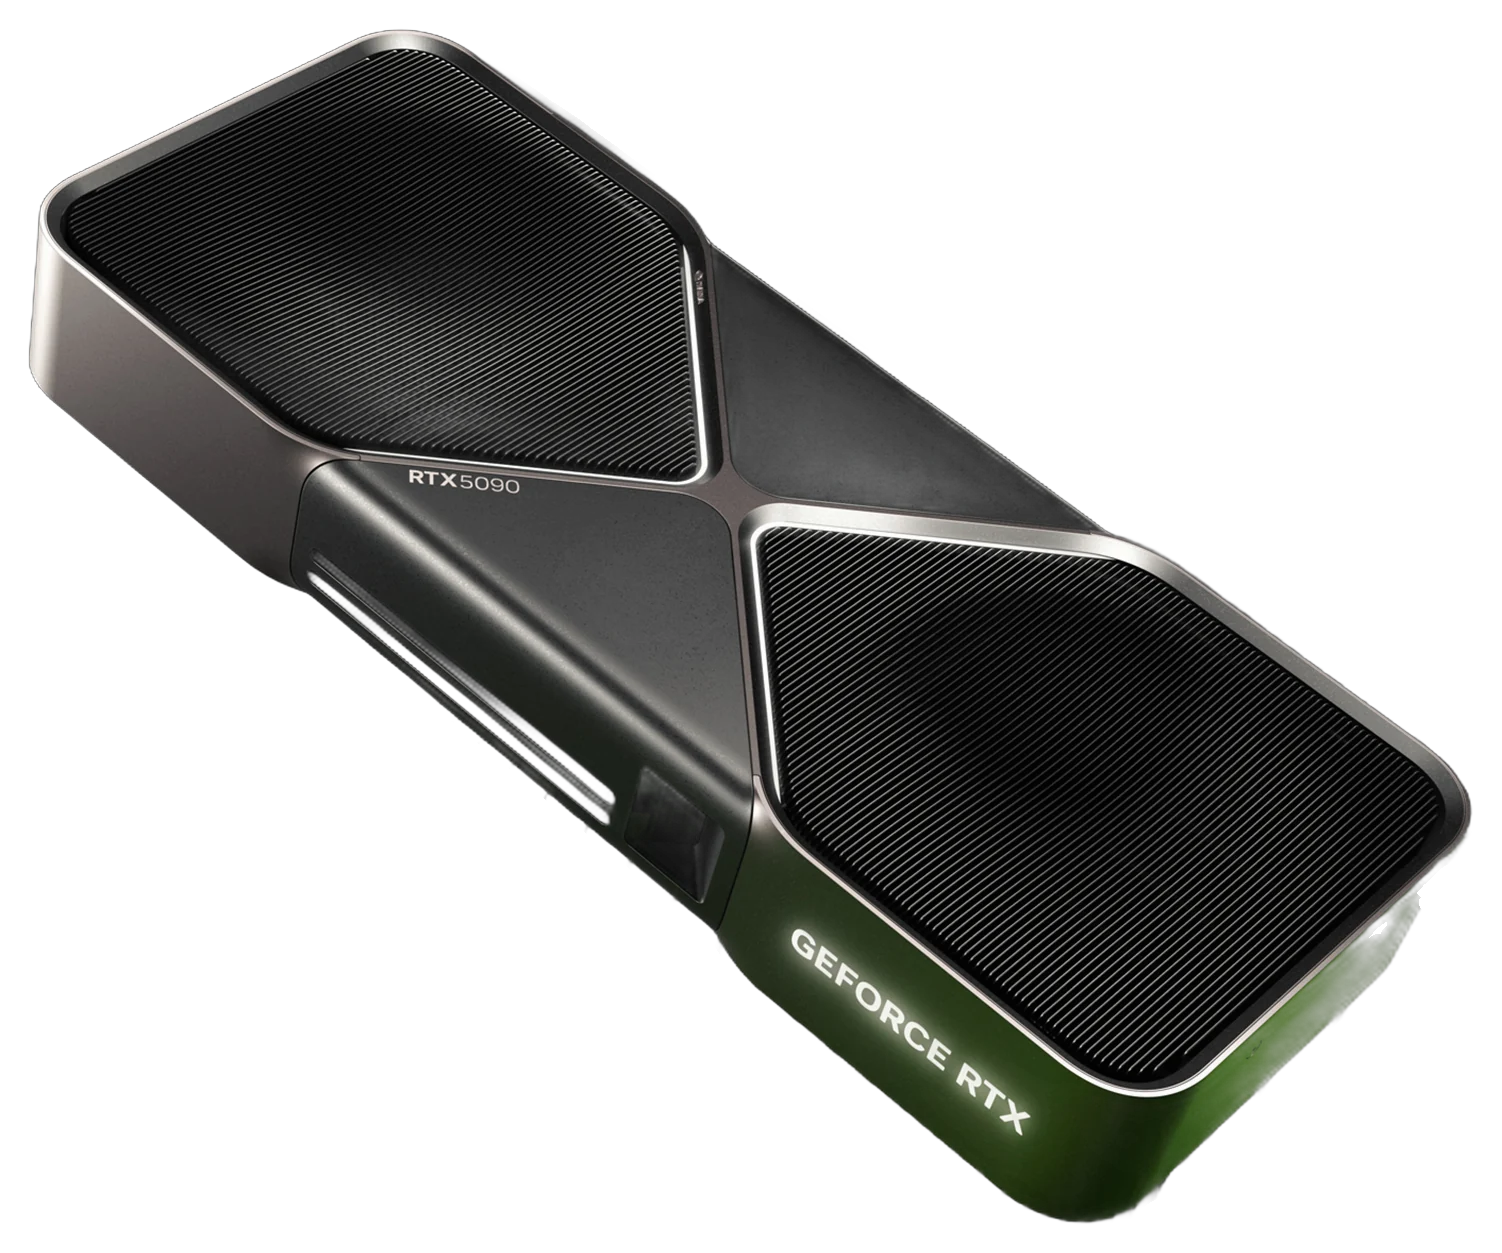
GeForce RTX 5090 устроена противоположно DGX Spark: память очень быстрая, но её мало.
- 32 ГБ GDDR7, 1,79 ТБ/с, 21 760 ядер CUDA, 3 352 TOPS в FP4.
- Память в шесть с половиной раз быстрее, чем у DGX Spark.
- Qwen3 32B в 4 битах (около 18 ГБ) помещается с запасом под контекст. Llama 3.3 70B уже нет даже в 4 битах (около 40 ГБ).
- Нужен полноценный ПК с мощным блоком питания: одна карта потребляет до 575 Вт, больше, чем два DGX Spark вместе.
- Это карта GeForce. Для рабочего стола она подходит, но лицензия драйвера GeForce не предусматривает установку в дата-центрах.
Выбор «DGX Spark или RTX 5090» решается размером модели. Если ваши модели укладываются в 32 ГБ, RTX 5090 ответит в разы быстрее. Если нужны 70B и крупнее, нужен Spark. Особенно ему подходят модели MoE с малым числом активных параметров: gpt-oss-120b (около 61 ГБ весов, 5,1B активных) помещается целиком и генерирует заметно быстрее плотной 70B.
Сравнение: память, скорость и теоретический потолок генерации
| DGX Spark | Mac Studio M4 Max | Mac Studio M3 Ultra | RTX 5090 | |
|---|---|---|---|---|
| Память | 128 ГБ общая | до 128 ГБ общая | до 512 ГБ общая | 32 ГБ GDDR7 |
| Скорость памяти | 273 ГБ/с | 546 ГБ/с | 819 ГБ/с | 1,79 ТБ/с |
| CUDA | есть | нет | нет | есть |
| Обработка длинного промпта | быстрее, чем на Mac | медленнее NVIDIA | медленнее NVIDIA | быстрее всех в таблице |
| Потребление | 240 Вт | — | — | 575 Вт только карта |
| Потолок для Qwen3 32B в 4 битах (~18 ГБ), токенов/с | ~15 | ~30 | ~45 | ~100 |
| Потолок для Llama 3.3 70B в 4 битах (~40 ГБ), токенов/с | ~7 | ~14 | ~20 | не помещается |
Потолок посчитан по формуле «скорость памяти ÷ объём весов». Это теоретический максимум для одного диалога, на практике скорость ниже, особенно на длинном контексте. Но соотношение между устройствами он передаёт верно.
Отдельно про очень крупные модели. Один DGX Spark вмещает модели примерно до 200B в 4 битах, две связанные системы дают 256 ГБ и модели до 405B. А Mac Studio на M3 Ultra с 512 ГБ вмещает даже DeepSeek R1 в 4 битах (около 380 ГБ), но на пределе: macOS по умолчанию отдаёт видеоядру не всю память, лимит приходится поднимать вручную. И длинные запросы к такой модели будут обрабатываться долго.
Длинные промпты и RAG: где Mac проигрывает
Работа модели над запросом идёт в две фазы. Сначала она читает весь промпт: системную инструкцию, историю диалога, вставленные документы. Эта фаза упирается в вычисления. Потом пишет ответ по одному токену, и здесь всё решает скорость памяти.
В коротком чате вторая фаза занимает почти всё время, и Mac Studio благодаря быстрой памяти отвечает быстрее DGX Spark. Но в сценариях с длинным контекстом картина меняется:
- поиск по базе знаний (RAG), где в каждый запрос подставляются десятки страниц;
- анализ кода, договоров, отчётов целиком;
- агенты, которые накапливают длинную историю действий.
Здесь заметную часть времени пользователь ждёт первого слова ответа, и GPU NVIDIA за счёт вычислительной мощности справляются с этой фазой заметно быстрее Mac. Если ваш сценарий строится на длинных документах, преимущество Mac в скорости памяти может съесться ожиданием первого токена.
Какой компьютер для локальных LLM выбрать
- RTX 5090. Модели до 32B в 4 битах, максимальная скорость ответа, заодно генерация изображений. Подходит одному разработчику или небольшой команде, если модели не растут.
- DGX Spark. Разработчики, которые будут разворачивать сервисы на серверах NVIDIA; прототипы на моделях до 200B; дообучение небольших моделей с привычными библиотеками CUDA. Компактная система на 240 Вт без требований к серверной.
- Mac Studio. Один человек, которому нужен чат с очень крупной моделью и не нужна CUDA. Обработка длинных документов будет медленнее, чем на NVIDIA.
Ни один из трёх вариантов не рассчитан на сервис для отдела с десятками пользователей. Для этого нужна карта или сервер с быстрой памятью и движком vLLM. Где проходит граница между рабочей станцией и сервером, мы разобрали в статье «Рабочая станция для ИИ».
Если нужно больше: RTX PRO 6000 и DGX Station
Когда компьютер для локальных LLM упирается в память или скорость, есть два следующих шага.
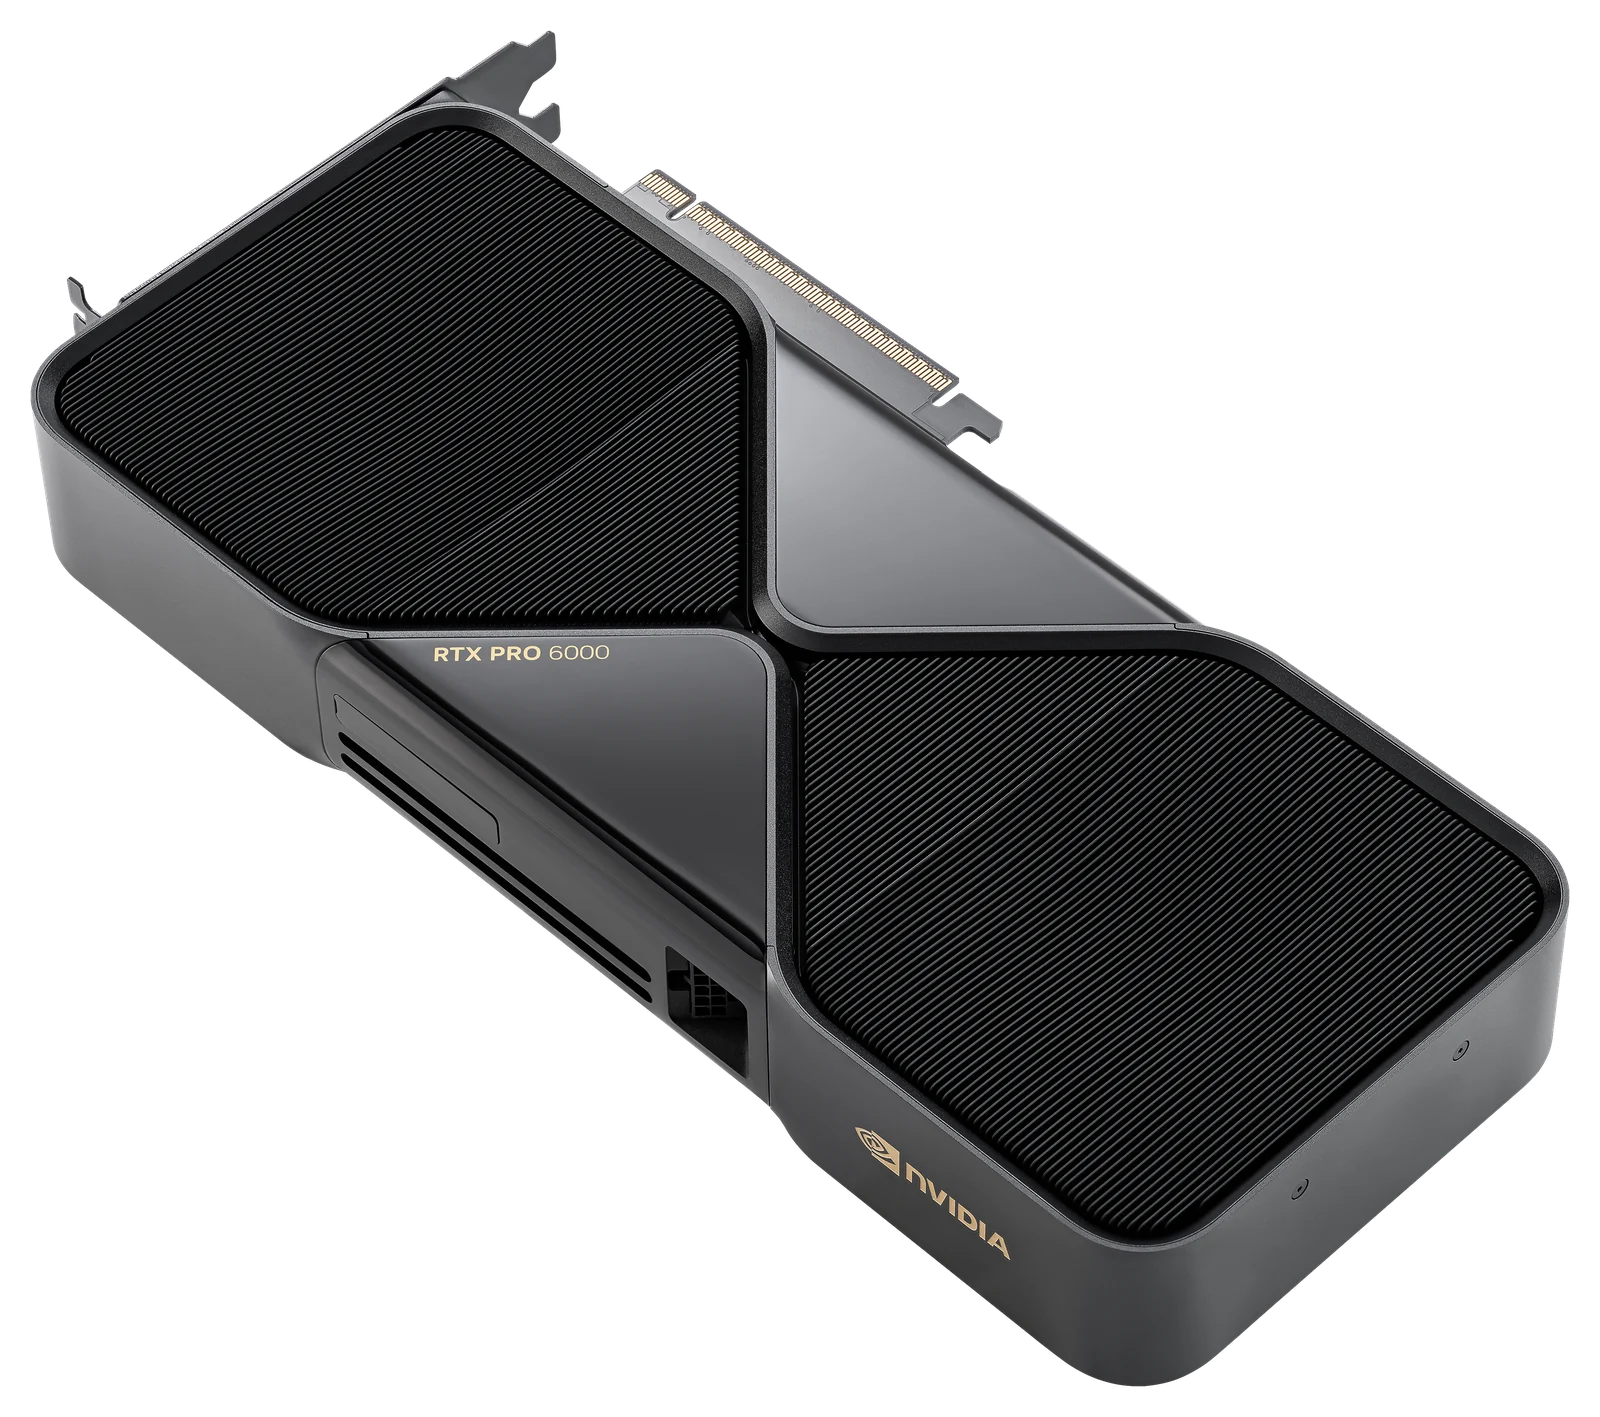
- RTX PRO 6000 Blackwell: та же скорость памяти, что у RTX 5090 (1,79 ТБ/с), но 96 ГБ с ECC. Llama 3.3 70B в 4 битах помещается с теоретическим потолком около 45 токенов в секунду, gpt-oss-120b целиком. Версия Max-Q потребляет 300 Вт вместо 600 Вт.
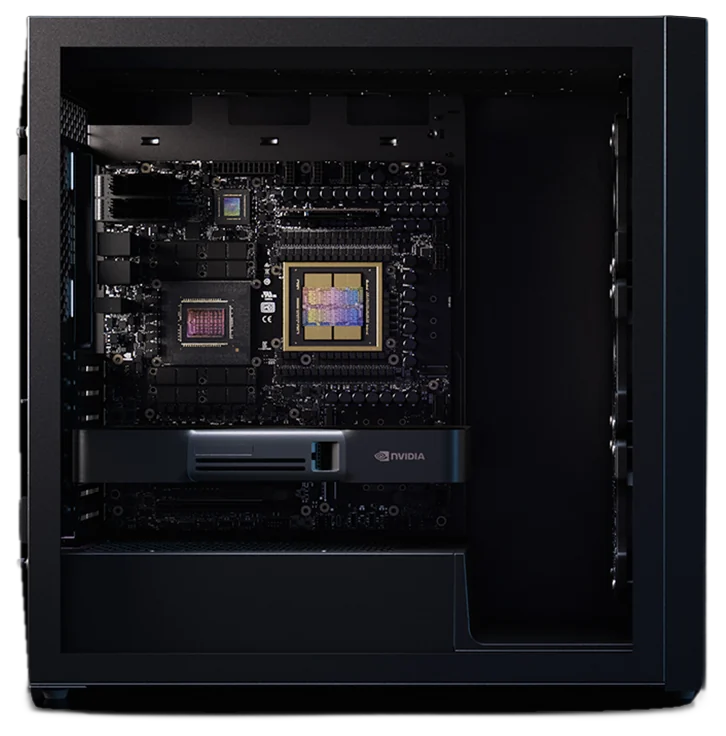
- DGX Station GB300: 748 ГБ общей памяти, из них 252 ГБ HBM3e со скоростью 7,1 ТБ/с, до 20 ПФЛОПС в FP4, сеть до 800 Гбит/с. Для Llama 3.3 70B в 4 битах теоретический потолок около 180 токенов в секунду. Потребление 1 600 Вт: это уже машина для обучения и тяжёлого инференса в офисе.
Коротко
- DGX Spark: 128 ГБ, CUDA и стек NVIDIA, но память 273 ГБ/с, поэтому крупные плотные модели генерируют медленно.
- Mac Studio: до 512 ГБ и до 819 ГБ/с, но без CUDA и с медленной обработкой длинных промптов.
- RTX 5090: самая быстрая память в сравнении (1,79 ТБ/с), но только 32 ГБ, это модели до 32B в 4 битах.
- Нужно больше памяти и скорости: RTX PRO 6000 на 96 ГБ или DGX Station GB300.
Подскажем, что из этого подойдёт под ваши модели и сценарии: оставьте заявку, и мы пришлём варианты конфигураций, цену и срок в течение рабочего дня.
Оборудование из статьи
NVIDIA Популярное
DGX Spark
Суперкомпьютер размером с книгу: модели до 200B на столе.
- Общая память
- 128ГБ
- ИИ, FP4
- 1ПФЛОПС
- Вес
- 1,2кг
от 990 000 ₽
NVIDIA
GeForce RTX 5090
Самая мощная потребительская карта: модели до 32B, генерация изображений и видео.
- GDDR7
- 32ГБ
- ИИ, FP4
- 3352TOPS
- Потребление
- 575Вт
от 350 000 ₽
NVIDIA Новинка
DGX Station GB300
Мощность серверной стойки в корпусе рабочей станции.
- Общая память
- 748ГБ
- ИИ, FP4
- 20ПФЛОПС
- Сеть
- 800Гбит/с
Цена по запросу
Читайте также
NVIDIA DGX Spark: обзор, характеристики и для чего он нужен
Обзор NVIDIA DGX Spark на суперчипе GB10 Grace Blackwell: характеристики, какие LLM помещаются в 128 ГБ, скорость генерации, связка из двух систем и альтернативы.
Рабочая станция для ИИ: DGX Spark, DGX Station или ПК с RTX
Рабочая станция для ИИ: сравниваем ПК с RTX 5090, станцию на RTX PRO 6000, DGX Spark и DGX Station GB300 по памяти, скорости и потреблению и разбираем ограничения офиса.
gpt-oss-120b и gpt-oss-20b: на каком железе запускать
Сколько памяти нужно gpt-oss-120b и gpt-oss-20b, открытым моделям OpenAI: веса в MXFP4, какие GPU подходят, сколько пользователей потянет карта и чем запускать.