Запуск моделей
Сервер для DeepSeek V3 и R1: какое железо нужно для полной модели
Какой сервер для DeepSeek V3 и R1 нужен, чтобы запустить полную модель на 671B: сколько памяти занимают веса и варианты на H200, B200, Ascend и RTX PRO 6000.
Содержание
- Сколько весит полная DeepSeek и почему MoE не экономит память
- Distill-версии: это другие модели
- Какой сервер для DeepSeek выбрать: четыре варианта
- Сравнение вариантов в таблице
- Скорость: почему DeepSeek отвечает быстрее, чем кажется по размеру
- Запуск DeepSeek на своём сервере: какой софт нужен
- Коротко
Сервер для DeepSeek V3 или R1 в полной версии должен вместить около 700 ГБ весов в родном FP8 и ещё оставить место под контекст пользователей. На практике это система на восемь ускорителей с памятью от 1 ТБ: 8 × H200 дают 1 128 ГБ, 8 × B200 дают 1 440 ГБ. Если устроит 4-битная версия (около 380 ГБ), хватит сервера на восьми RTX PRO 6000 с 768 ГБ памяти.
Сколько весит полная DeepSeek и почему MoE не экономит память
DeepSeek V3 и рассуждающая DeepSeek R1 устроены одинаково: 671B параметров, из которых на каждый токен работают 37B. Это архитектура MoE (Mixture of Experts): модель состоит из множества «экспертов», и для каждого токена выбирается лишь несколько из них. Контекст до 128 тысяч токенов, лицензия MIT разрешает коммерческое использование.
Главная ловушка в цифре 37B. Кажется, что памяти нужно как плотной модели на 37B, то есть несколько десятков гигабайт. Но эксперты меняются от токена к токену, и заранее неизвестно, какой понадобится следующим. Поэтому в памяти ускорителей должны лежать все 671B параметров, иначе каждый токен будет ждать подгрузки весов из оперативной памяти.
Отсюда главные требования DeepSeek к железу:
| Формат | Объём весов | Когда нужен |
|---|---|---|
| FP8 (родной) | ~700 ГБ | Так модель выпущена, эталонное качество |
| BF16 | ~1,3 ТБ | Железо без поддержки FP8, памяти нужно вдвое больше |
| 4 бита | ~380 ГБ | Экономия памяти, потери качества заметнее на сложных задачах |
К весам добавьте KV-кеш под контекст каждого пользователя и 10–20% служебной памяти. Как считать кеш и запас, мы подробно разобрали в статье «Сколько видеопамяти нужно для LLM».
Distill-версии: это другие модели
Под названием DeepSeek R1 часто скачивают совсем не то. DeepSeek-R1-Distill на базе Qwen и Llama размером от 1,5B до 70B это отдельные небольшие модели, которые дообучили на ответах R1. Они запускаются на одной видеокарте, но по знаниям и качеству ответов остаются моделями своего размера, а не уменьшенной копией R1 на 671B.
Если задача в том, чтобы запустить DeepSeek R1 локально с качеством полной модели, считать железо нужно от 671B. При загрузке смотрите на число параметров в названии: 7B, 32B или 70B означает distill-версию. А если вам хватает качества модели на 32–70B, честнее сравнить distill с другими моделями того же размера, например с Qwen3 32B или Llama 3.3 70B.
Какой сервер для DeepSeek выбрать: четыре варианта
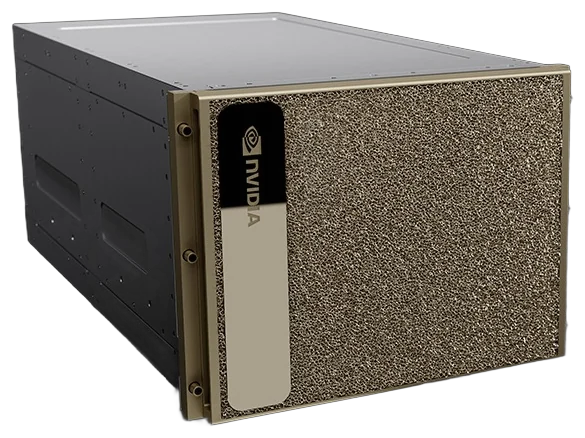
8 × H200: DGX H200 или сервер на HGX H200
DGX H200 несёт восемь H200 SXM по 141 ГБ, всего 1 128 ГБ HBM3e. Модель в родном FP8 занимает около 700 ГБ, и ещё около 400 ГБ остаётся под кеш и служебные буферы: этого хватает для многих одновременных диалогов с длинным контекстом. GPU связаны NVLink со скоростью 900 ГБ/с на каждый. Это важно, потому что модель разрезана на восемь частей и ускорители постоянно обмениваются данными.
Та же плата HGX H200 стоит в Supermicro SYS-821GE-TNHR. GPU и память те же, а процессоры, оперативную память (до 8 ТБ) и сетевые карты можно подобрать под задачу. DGX H200 потребляет до 10,2 кВт и занимает 8U в стойке.
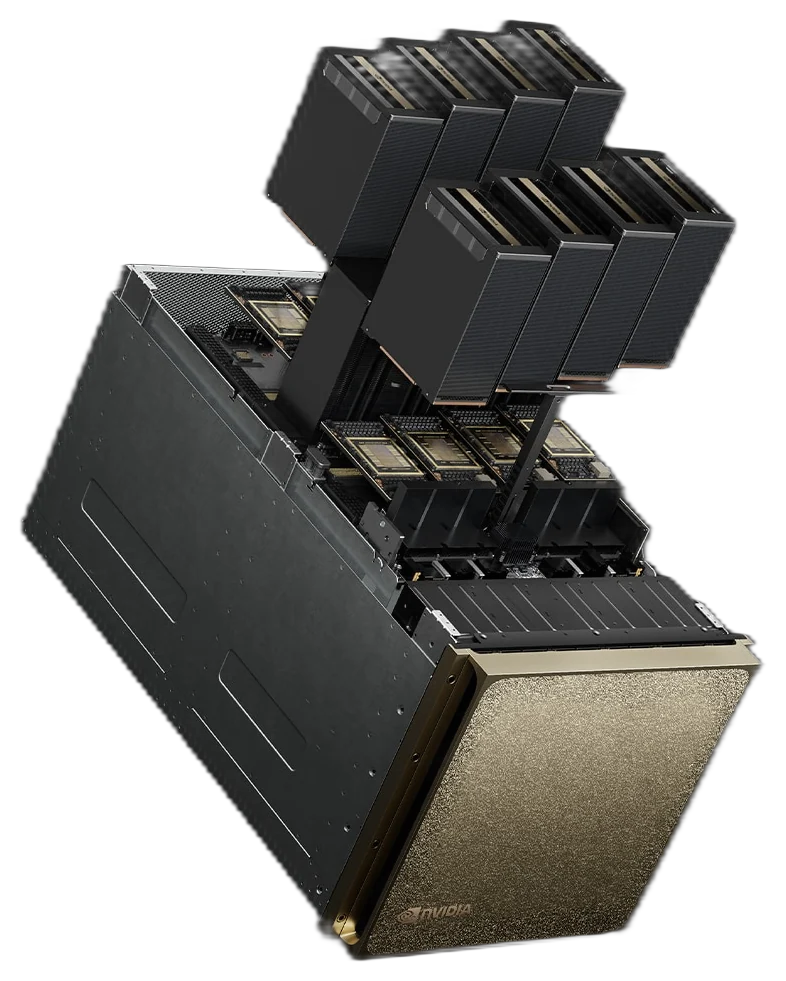
8 × B200: DGX B200
DGX B200 несёт 1 440 ГБ HBM3e, примерно вдвое больше, чем нужно весам в FP8. Запас уходит под кеш: больше пользователей и длиннее контекст на одной системе. Blackwell аппаратно поддерживает FP4, поэтому 4-битные версии модели в формате NVFP4 работают на нём с аппаратным ускорением, у Hopper такой поддержки нет.
GPU связаны NVLink 5, суммарно 14,4 ТБ/с на восемь ускорителей. Плата за производительность: до 14,3 кВт и 10U в стойке. Та же платформа есть в виде сервера Supermicro на HGX B200 с более гибкой конфигурацией.
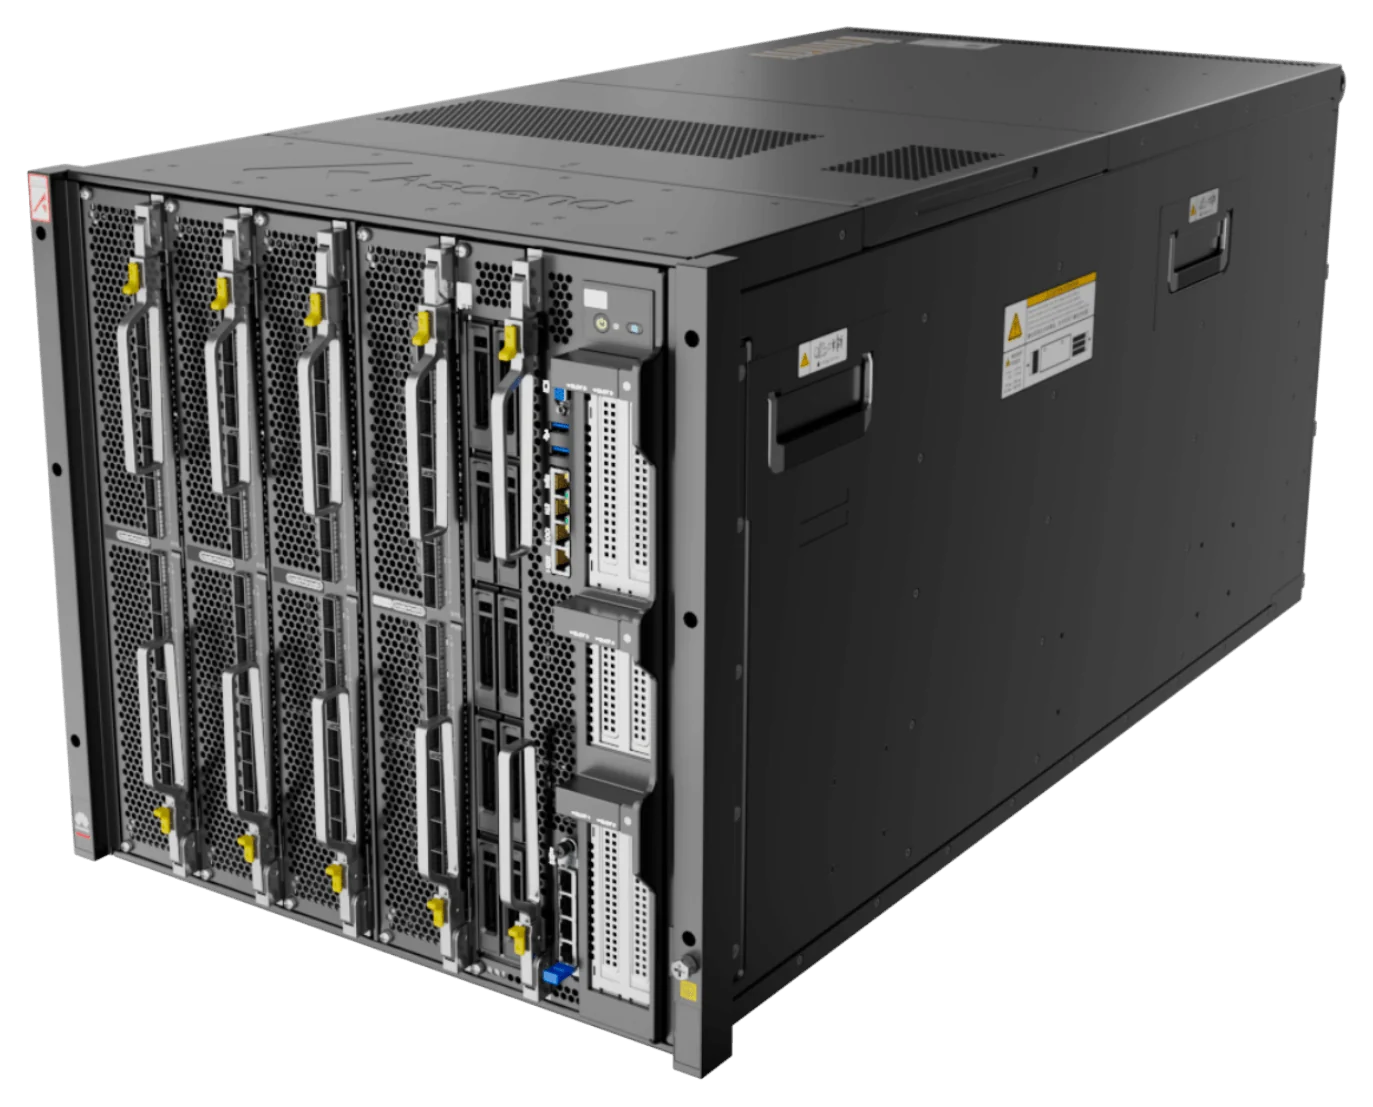
Huawei Atlas 800I A3 на Ascend 910C
Atlas 800T A3 / 800I A3 построен на восьми Ascend 910C по 128 ГБ, всего 1 ТБ HBM. Для запуска модели нужна версия 800I, версия 800T рассчитана на обучение. 8-битная версия весов (около 700 ГБ) помещается в один сервер, под кеш остаётся около 300 ГБ.
Чипы связаны между собой на 784 ГБ/с, потребление до 14,6 кВт, высота 10U, охлаждение воздушное. Этот вариант логичен, если компания строит инфраструктуру на стеке Huawei: софт для запуска здесь свой, о нём ниже.
8 × RTX PRO 6000: 4-битная версия
Gigabyte XL44-SX2 на восьми RTX PRO 6000 Blackwell Server Edition даёт 768 ГБ памяти GPU. Веса в FP8 формально помещаются, но под кеш почти ничего не остаётся. Практичный вариант для этого сервера: 4-битная версия на ~380 ГБ, тогда под контекст остаётся почти столько же.
Ограничение в связи между картами. У RTX PRO 6000 нет NVLink, данные идут через PCIe 5.0, это около 64 ГБ/с в каждую сторону против 900 ГБ/с у H200. При большой нагрузке обмен между картами упирается в шину раньше, чем в системах с NVLink. Зато это самый компактный вариант (4U) и самый доступный путь к полной DeepSeek.
Сравнение вариантов в таблице
| Система | Память ускорителей | Что помещается | Связь ускорителей | Питание | Высота |
|---|---|---|---|---|---|
| DGX H200 | 1 128 ГБ HBM3e | FP8 с большим запасом под кеш | NVLink, 900 ГБ/с на GPU | до 10,2 кВт | 8U |
| Supermicro HGX H200 | 1 128 ГБ HBM3e | FP8 с большим запасом под кеш | NVLink, 900 ГБ/с на GPU | 6 × 3000 Вт с резервированием | 8U |
| DGX B200 | 1 440 ГБ HBM3e | FP8 или FP4, максимум места под кеш | NVLink 5, 14,4 ТБ/с суммарно | до 14,3 кВт | 10U |
| Atlas 800I A3 | 1 ТБ HBM | 8 бит с запасом под кеш | 784 ГБ/с | до 14,6 кВт | 10U |
| Gigabyte XL44-SX2 | 768 ГБ GDDR7 с ECC | 4 бита с запасом под кеш | PCIe 5.0 | 4 × 3200 Вт с резервированием | 4U |
DGX H200, DGX B200 и Atlas 800I A3 потребляют от 10,2 до 14,6 кВт, и почти вся эта мощность уходит в тепло. Перед покупкой стоит проверить, выдержат ли стойка, линии питания и охлаждение такую нагрузку.
Скорость: почему DeepSeek отвечает быстрее, чем кажется по размеру
Генерация текста упирается в чтение весов из памяти: на каждый новый токен модель читает нужные веса целиком. У MoE читаются только активные параметры, поэтому DeepSeek в FP8 читает на токен около 37 ГБ, а не 700. Для сравнения, плотная Llama 3.3 70B в FP8 читает 70 ГБ на каждый токен.
Получается, что теоретический потолок скорости генерации у DeepSeek выше, чем у плотной модели почти в десять раз меньше по размеру. Реальная скорость ниже потолка: ускорители обмениваются данными, выбор экспертов добавляет накладные расходы, а на длинном контексте растёт кеш, который тоже нужно читать.
Есть и обратная сторона. R1 сначала рассуждает и только потом отвечает, поэтому на один вопрос она генерирует заметно больше токенов, чем V3. Для сервиса на много пользователей важны и объём памяти под кеш, и связь между GPU. Конкретную скорость лучше измерять на своих запросах: она зависит от движка, длины промптов и числа одновременных диалогов.
Запуск DeepSeek на своём сервере: какой софт нужен
- SGLang. Сильная поддержка DeepSeek. RadixAttention переиспользует общий префикс запросов, например одинаковый системный промпт, и экономит вычисления при множестве пользователей.
- vLLM. Стандарт для многопользовательского сервиса: PagedAttention, непрерывный батчинг и OpenAI-совместимый API, к которому легко подключить готовые приложения.
- TensorRT-LLM. Максимум скорости на NVIDIA, но сложнее в настройке.
- На Huawei Ascend: MindIE и vLLM Ascend поверх стека CANN.
- llama.cpp и Ollama запускают 4-битные версии в формате GGUF, но рассчитаны скорее на одного пользователя.
Чем 4 бита отличаются от FP8 по качеству и скорости, читайте в статье о квантовании LLM. А сравнение движков собрано в материале «vLLM, Ollama или SGLang».
Коротко
- Полная DeepSeek V3 или R1: 671B параметров, около 700 ГБ в FP8 и около 380 ГБ в 4 битах.
- MoE экономит время на токен, а не память: в ускорителях должны лежать все веса.
- Для FP8 с запасом под пользователей нужен сервер на 8 × H200 или 8 × B200, на стеке Huawei подойдёт Atlas 800I A3.
- Для 4-битной версии хватит 768 ГБ на восьми RTX PRO 6000.
- Distill-версии на 1,5–70B это отдельные модели, а не облегчённая R1.
Если планируете запускать DeepSeek внутри компании, оставьте заявку: подберём один из вариантов под ваше число пользователей и длину запросов, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA
DGX H200
Тот же DGX, но с почти вдвое большей памятью: 1,1 ТБ HBM3e.
- H200 SXM
- 8GPU
- Память GPU
- 1128ГБ
- FP8
- 32ПФЛОПС
Цена по запросу
NVIDIA
DGX B200
Blackwell для обучения и инференса: 1,44 ТБ памяти GPU.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- FP4
- 144ПФЛОПС
Цена по запросу
Huawei Флагман
Atlas 800T A3 / 800I A3
Текущий флагман Huawei: восемь Ascend 910C и 1 ТБ HBM.
- Ascend 910C
- 8NPU
- Память HBM
- 1ТБ
- FP16
- 6ПФЛОПС
Цена по запросу
Читайте также
Сколько видеопамяти нужно для LLM: расчёт для моделей от 8B до 671B
Простая формула, сколько видеопамяти нужно языковой модели: веса, KV-кеш и запас. Таблица для Qwen3, Llama 70B, gpt-oss и DeepSeek и подбор GPU под объём.
Квантование LLM: FP8, INT4 и FP4 простыми словами
Что такое квантование LLM простыми словами: форматы FP8, INT8, INT4, FP4 и GGUF, сколько памяти они экономят, как влияют на качество и какое железо их поддерживает.
Питание и охлаждение GPU-сервера: что подготовить до поставки
Охлаждение и питание GPU-сервера: сколько потребляют системы на 8 GPU, как отвести 10–14 кВт тепла, какие нужны линии и ИБП. Чек-лист серверной до поставки.