Обзоры
NVIDIA DGX Spark: обзор, характеристики и для чего он нужен
Обзор NVIDIA DGX Spark на суперчипе GB10 Grace Blackwell: характеристики, какие LLM помещаются в 128 ГБ, скорость генерации, связка из двух систем и альтернативы.
Содержание
NVIDIA DGX Spark это ИИ-компьютер размером 150 × 150 × 50,5 мм на суперчипе GB10 Grace Blackwell: 128 ГБ памяти, общей для процессора и GPU, до 1 ПФЛОПС в FP4 и потребление 240 Вт. Он вмещает модели до 200B параметров, а две связанные системы справляются с моделями до 405B. Это машина для разработчика, а не сервер: память работает на 273 ГБ/с, поэтому крупные модели генерируют текст медленно, зато программный стек NVIDIA здесь тот же, что в дата-центре.
Характеристики DGX Spark
Данные по DGX Spark из нашего каталога:
| Параметр | Значение |
|---|---|
| Суперчип | GB10 Grace Blackwell |
| Процессор | 20 ядер Arm |
| Память | 128 ГБ LPDDR5x, общая для CPU и GPU |
| Скорость памяти | 273 ГБ/с |
| ИИ-производительность | до 1 ПФЛОПС (FP4) |
| Накопитель | до 4 ТБ NVMe |
| Сеть | ConnectX-7 200 Гбит/с, 10 GbE, Wi-Fi 7 |
| Размеры | 150 × 150 × 50,5 мм |
| Вес | 1,2 кг |
| Питание | 240 Вт |
| ОС | NVIDIA DGX OS |
Производительность 1 ПФЛОПС указана по данным NVIDIA для формата FP4. В более точных форматах, например BF16, она ниже.
Суперчип GB10 Grace Blackwell и единая память
GB10 Grace Blackwell объединяет в одном корпусе процессор Arm и GPU поколения Blackwell. Память у них общая, и это главная особенность системы.
- Модели доступна почти вся память. В обычном ПК модель ограничена видеопамятью карты, например 32 ГБ у RTX 5090. Здесь GPU работает со всеми 128 ГБ, за вычетом того, что занимают система и программы.
- Форматы Blackwell. Аппаратная поддержка FP8 и FP4 (NVFP4), как у серверных B200 и карт RTX PRO 6000. Модель, квантованную под Blackwell, можно проверить на столе до запуска в дата-центре.
- Цена за объём. LPDDR5x медленнее, чем GDDR7 и HBM. 273 ГБ/с против 1,79 ТБ/с у RTX PRO 6000 и 4,8 ТБ/с у H200 NVL.
Для кого нужен NVIDIA DGX Spark
- Разработчики ИИ-сервисов. Прототип собирается на локальной машине с тем же софтом, что и на серверах: CUDA, DGX OS, контейнеры и библиотеки NVIDIA. После отладки его переносят на DGX или HGX-сервер.
- Команды, которые пробуют модели. Модель до 200B можно запустить и сравнить с другими, не занимая общий сервер и не дожидаясь очереди.
- Дообучение небольших моделей. По памяти помещаются LoRA для моделей среднего размера и QLoRA вплоть до 70B (с базой в 4 битах такая модель укладывается примерно в 48 ГБ). Обучение при этом идёт заметно медленнее, чем на серверных GPU.
- Обучение сотрудников. Каждому инженеру можно дать собственный стенд с полноценным стеком NVIDIA.
- Офис без серверной. 240 Вт и корпус размером с книгу не требуют отдельного помещения.
Кому DGX Spark не подойдёт: тем, кому нужен сервис на модели 70B для отдела с десятками пользователей, и тем, кто обучает крупные модели с нуля. Для этого нужны карты с быстрой памятью или сервер.
DGX Spark для LLM: что помещается и как быстро
Скорость генерации оценим по формуле «скорость памяти ÷ объём весов, читаемых на токен». Это теоретический потолок для одного диалога, реальная скорость ниже. Для моделей MoE в расчёт идут только активные параметры.
| Модель | Формат | Веса | Помещается | Потолок, токенов в секунду |
|---|---|---|---|---|
| Qwen3 8B | FP8 | ~8 ГБ | да | ~34 |
| Qwen3 30B-A3B (MoE, 3B активных) | FP8 | ~30 ГБ | да | ~90 |
| Qwen3 32B | FP8 | ~32 ГБ | да | ~8 |
| Qwen3 32B | 4 бита | ~18 ГБ | да | ~15 |
| Llama 3.3 70B | 4 бита | ~40 ГБ | да | ~7 |
| Llama 3.3 70B | FP8 | ~70 ГБ | да | ~4 |
| gpt-oss-120b (MoE, 5,1B активных) | MXFP4 | ~61 ГБ | да | в разы выше, чем у 70B |
| Qwen3 235B-A22B | 4 бита | ~125 ГБ | только в связке из двух | — |
| DeepSeek V3 / R1 | 4 бита | ~380 ГБ | нет | — |
Вывод из таблицы простой. На DGX Spark лучше всего работают модели MoE с малым числом активных параметров: Qwen3 30B-A3B и gpt-oss-120b. Плотная 70B помещается даже в FP8 вместе с кешем, но генерирует медленно. Для разработки и проверки идей этого хватает, для живого чата с длинными ответами уже нет.
Обработка длинного промпта упирается не в память, а в вычисления, и здесь DGX Spark заметно опережает Mac Studio с тем же объёмом памяти. Подробное сравнение с Mac Studio и RTX 5090, включая длинные промпты, мы привели в статье «DGX Spark, Mac Studio или RTX 5090».
Ограничения: скорость памяти и процессор Arm
- Скорость памяти. 273 ГБ/с в шесть с половиной раз меньше, чем у RTX PRO 6000, и почти в 18 раз меньше, чем у H200 NVL. По теоретическому потолку плотная модель на DGX Spark генерирует текст во столько же раз медленнее, чем на этих картах.
- Не сервер. Система рассчитана на одного разработчика. С ростом числа пользователей и длины контекста кеш быстро съедает свободную память, а скорость ответа каждому падает.
- Архитектура Arm. Основной стек NVIDIA для Arm доступен, но отдельные пакеты и бинарные сборки, выпущенные только под x86, придётся собирать самостоятельно или заменять. Программы для Windows не запустятся: DGX OS построена на Linux.
Связка из двух DGX Spark
Две системы соединяются через сетевой интерфейс ConnectX-7 на 200 Гбит/с. Вместе они дают 256 ГБ памяти и, по данным NVIDIA, запускают модели до 405B параметров. В такую пару, например, помещается Qwen3 235B-A22B в 4 битах.
Связка нужна, чтобы запустить модель крупнее, а не чтобы ускорить ту, что уже помещается в одну систему. Модель делится между двумя машинами, и обмен данными по сети добавляет свои задержки. Если же вам нужна скорость на модели 70B, логичнее смотреть на карту с быстрой памятью.
Альтернативы DGX Spark
- ПК с GeForce RTX 5090. Память 1,79 ТБ/с, в шесть с половиной раз быстрее, но только 32 ГБ: модели примерно до 32B в 4 битах.
- Станция с RTX PRO 6000 Blackwell. 96 ГБ GDDR7 с ECC и 1,79 ТБ/с, разделение на четыре экземпляра через MIG. Llama 3.3 70B в 4 битах с теоретическим потолком около 45 токенов в секунду. Потребление 600 Вт, у версии Max-Q 300 Вт.
- DGX Station GB300. 748 ГБ общей памяти, из них 252 ГБ HBM3e на 7,1 ТБ/с, до 20 ПФЛОПС в FP4 и сеть до 800 Гбит/с. Это обучение и тяжёлый инференс в офисе, при потреблении 1 600 Вт.
- Mac Studio. Больше памяти и выше её скорость, но без CUDA и с медленной обработкой длинных промптов.
Как решить, хватит ли рабочей станции или пора ставить сервер, мы разобрали в статье «Рабочая станция для ИИ».
Коротко
- DGX Spark: суперчип GB10 Grace Blackwell, 128 ГБ общей памяти, до 1 ПФЛОПС в FP4, 240 Вт, 1,2 кг.
- Вмещает модели до 200B, связка из двух систем до 405B.
- Память 273 ГБ/с: плотная 70B в 4 битах генерирует с теоретическим потолком около 7 токенов в секунду, модели MoE заметно быстрее.
- Лучшее применение: разработка и прототипы на стеке NVIDIA с последующим переносом в дата-центр. Для сервиса на много пользователей нужен сервер.
Если DGX Spark нужен вашей команде разработчиков или вы выбираете между ним и станцией с RTX PRO 6000, оставьте заявку: поможем определиться, а цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
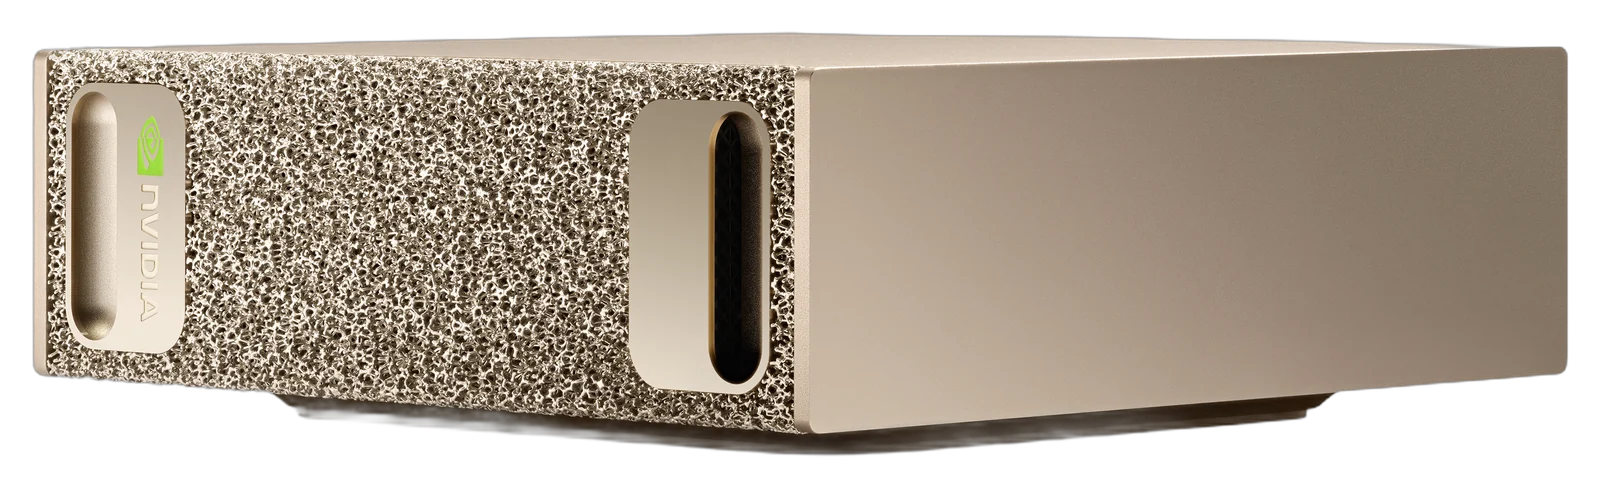
NVIDIA Популярное
DGX Spark
Суперкомпьютер размером с книгу: модели до 200B на столе.
- Общая память
- 128ГБ
- ИИ, FP4
- 1ПФЛОПС
- Вес
- 1,2кг
от 990 000 ₽
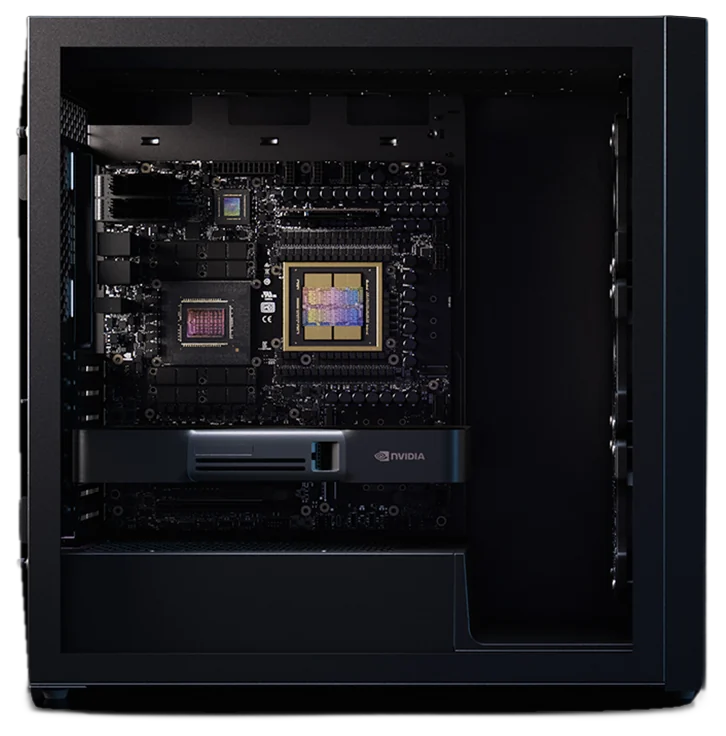
NVIDIA Новинка
DGX Station GB300
Мощность серверной стойки в корпусе рабочей станции.
- Общая память
- 748ГБ
- ИИ, FP4
- 20ПФЛОПС
- Сеть
- 800Гбит/с
Цена по запросу
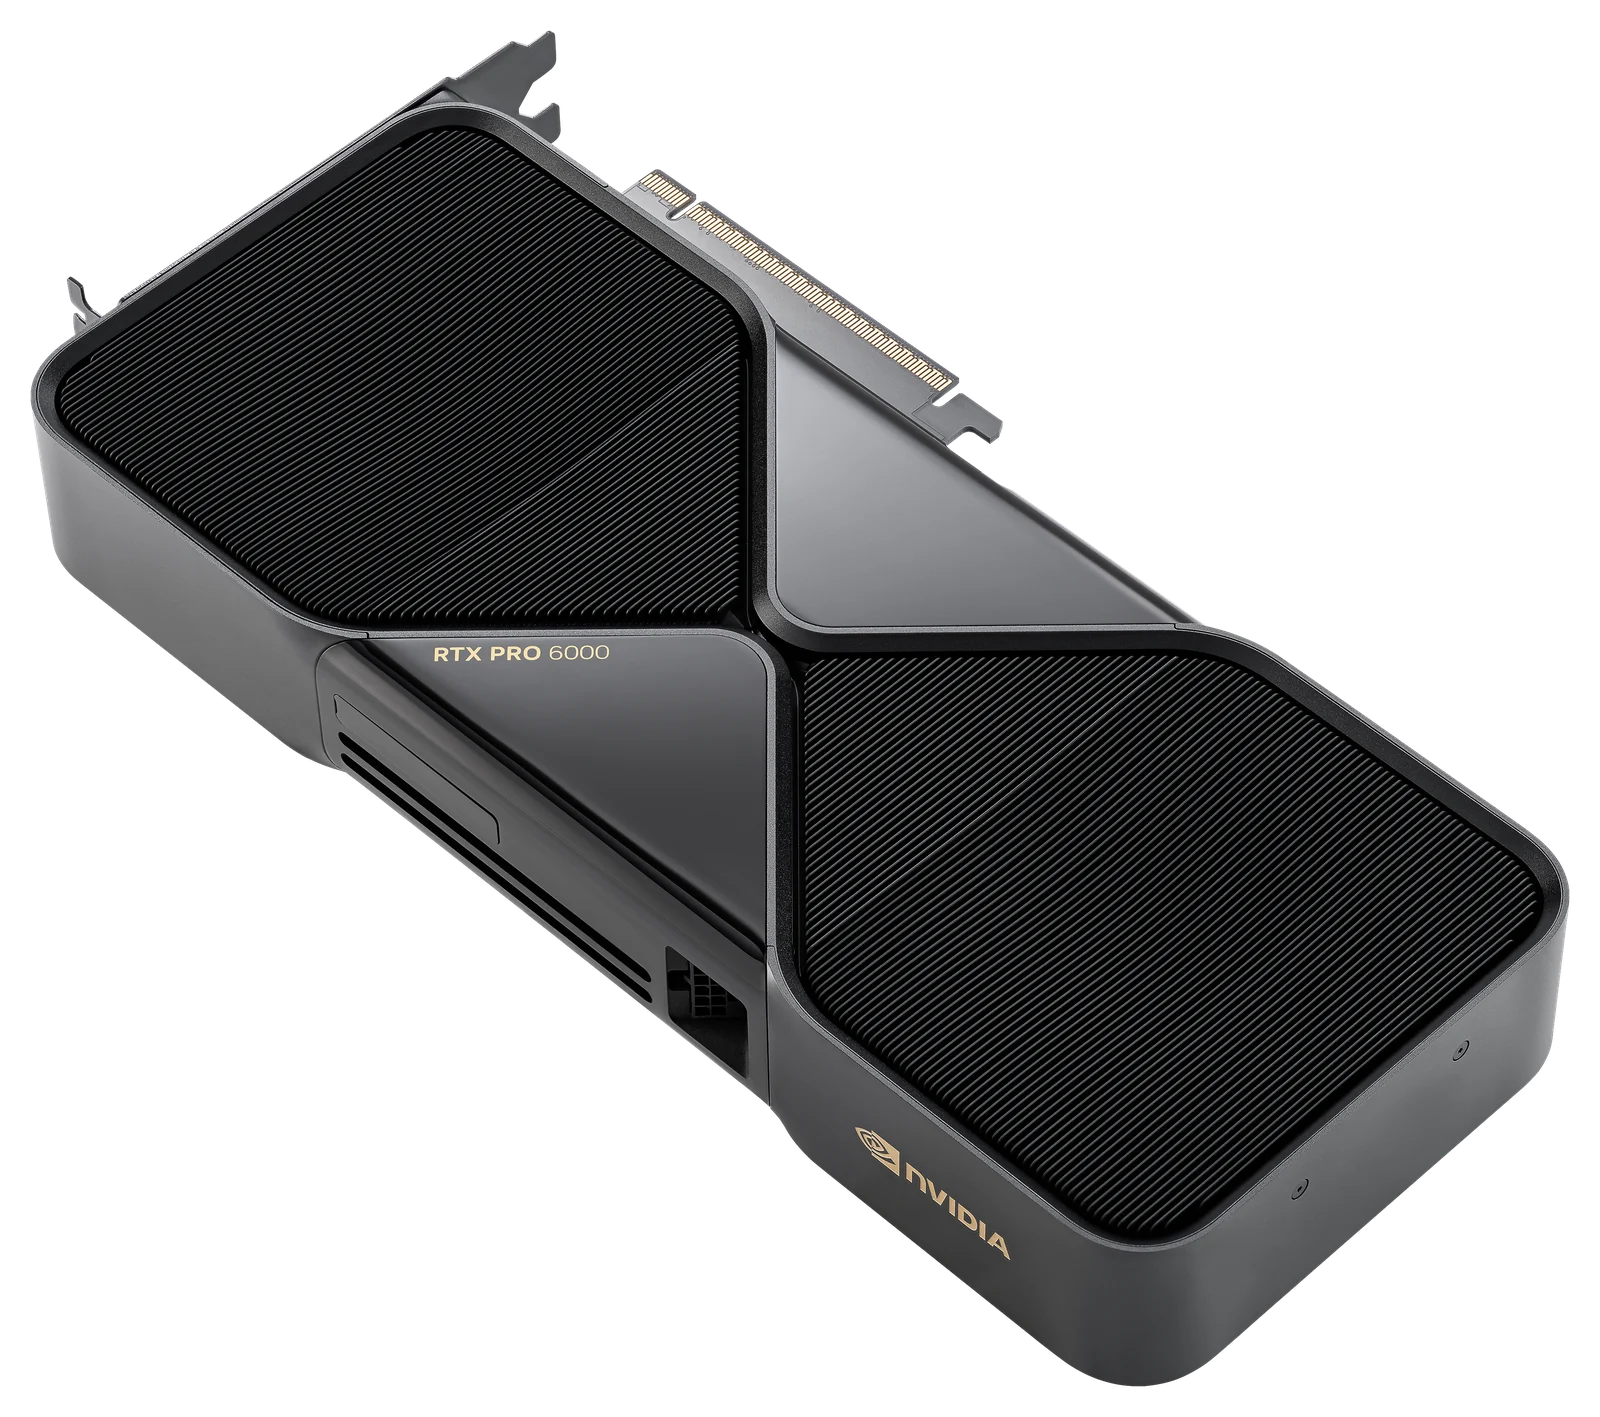
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
Читайте также
DGX Spark, Mac Studio или RTX 5090: что выбрать для локальных LLM
DGX Spark vs Mac Studio и RTX 5090 для локальных LLM: объём и скорость памяти, CUDA, длинные промпты и теоретический потолок генерации. Кому что подходит.
Рабочая станция для ИИ: DGX Spark, DGX Station или ПК с RTX
Рабочая станция для ИИ: сравниваем ПК с RTX 5090, станцию на RTX PRO 6000, DGX Spark и DGX Station GB300 по памяти, скорости и потреблению и разбираем ограничения офиса.
Аренда GPU-сервера или свой сервер: что выгоднее для компании
Аренда GPU-сервера или покупка своего: формула сравнения, точка безубыточности по загрузке, скрытые расходы, данные и доступность GPU. Когда выгоден гибрид.