Запуск моделей
Корпоративный ИИ-ассистент и RAG: какое железо нужно компании
Какое железо нужно корпоративному ИИ-ассистенту на базе RAG: из чего состоит система, что потребляет память GPU и расчёт на 50, 300 и 1 000 сотрудников.
Содержание
Корпоративный ИИ-ассистент на базе RAG почти всю видеопамять тратит на языковую модель и KV-кеш длинных запросов, а поиск по документам требует в разы меньше ресурсов. С моделью класса 70B в FP8 компании на 50 сотрудников хватает одной карты на 96–141 ГБ, на 300 сотрудников нужны две карты, на 1 000 уже сервер на восемь GPU. Ниже разбираем, из чего состоит такая система, и показываем расчёт, в который можно подставить свои цифры.
RAG простыми словами
RAG (Retrieval-Augmented Generation, генерация с поиском) работает как сотрудник со справочником. Прежде чем ответить, он находит в базе нужные страницы, читает их и отвечает своими словами со ссылкой на источник.
Технически RAG-система делает это в два этапа:
- Индексация: один раз и при обновлениях. Документы режутся на фрагменты по несколько абзацев. Каждый фрагмент превращается в вектор, набор чисел, описывающий смысл, и сохраняется в векторную базу.
- Ответ: на каждый вопрос. Вопрос тоже превращается в вектор, база находит самые близкие по смыслу фрагменты, реранкер отбирает лучшие, и языковая модель получает их вместе с вопросом. Ответ строится по найденному тексту, а не по памяти модели.
Поэтому нейросеть для базы знаний компании не нужно обучать на ваших документах. Документ обновили и переиндексировали, и ассистент сразу отвечает по новой версии.
Из чего состоит локальный ChatGPT для компании
То, что часто называют локальным ChatGPT для компании, состоит из пяти частей. Нагрузка на железо у них очень разная.
| Компонент | Что делает | Нагрузка | Где работает |
|---|---|---|---|
| Языковая модель (LLM) | пишет ответ по найденным фрагментам | основная: веса и KV-кеш | GPU с большой и быстрой памятью |
| Модель эмбеддингов | превращает текст в векторы | пик при первой индексации архива | GPU, можно общий с LLM |
| Реранкер | отбирает лучшие фрагменты из найденных | небольшая на каждый запрос | GPU |
| Векторная база | хранит векторы и ищет похожие | процессор, ОЗУ, диски | сервер без GPU |
| Распознавание документов | достаёт текст из сканов, PDF и таблиц | пик при загрузке архива | GPU или процессор |
Модели эмбеддингов и реранкеры обычно небольшие: от сотен миллионов до нескольких миллиардов параметров, то есть от 1 до 16 ГБ в BF16. Векторной базе GPU не нужен: миллион фрагментов при размерности вектора 1 024 занимает около 4 ГБ (1 000 000 × 1 024 × 4 байта), плюс индекс для быстрого поиска. Распознавание сканов нагружает железо в основном на старте, когда загружается весь архив. Дальше новых документов приходит немного.
Главный потребитель памяти: модель и длинный контекст
Языковой модели нужна память под веса и под KV-кеш. В обычном чате вопрос короткий, а в RAG к каждому вопросу добавляются найденные фрагменты, системная инструкция и история диалога. Запрос легко вырастает до нескольких тысяч токенов, и кеш растёт вместе с ним.
Посчитаем для модели класса 70B, например Llama 3.3 70B:
- веса в FP8: около 70 ГБ, со служебными буферами 77–84 ГБ;
- KV-кеш в FP16: около 0,31 МБ на токен;
- запрос в 8 тысяч токенов (наше допущение для RAG): около 2,5 ГБ кеша.
Каждый одновременный запрос добавляет ещё около 2,5 ГБ. Сколько памяти нужно сверх весов, определяет число одновременных запросов, а не число сотрудников. Формулы подробнее разобраны в статье о видеопамяти для LLM.
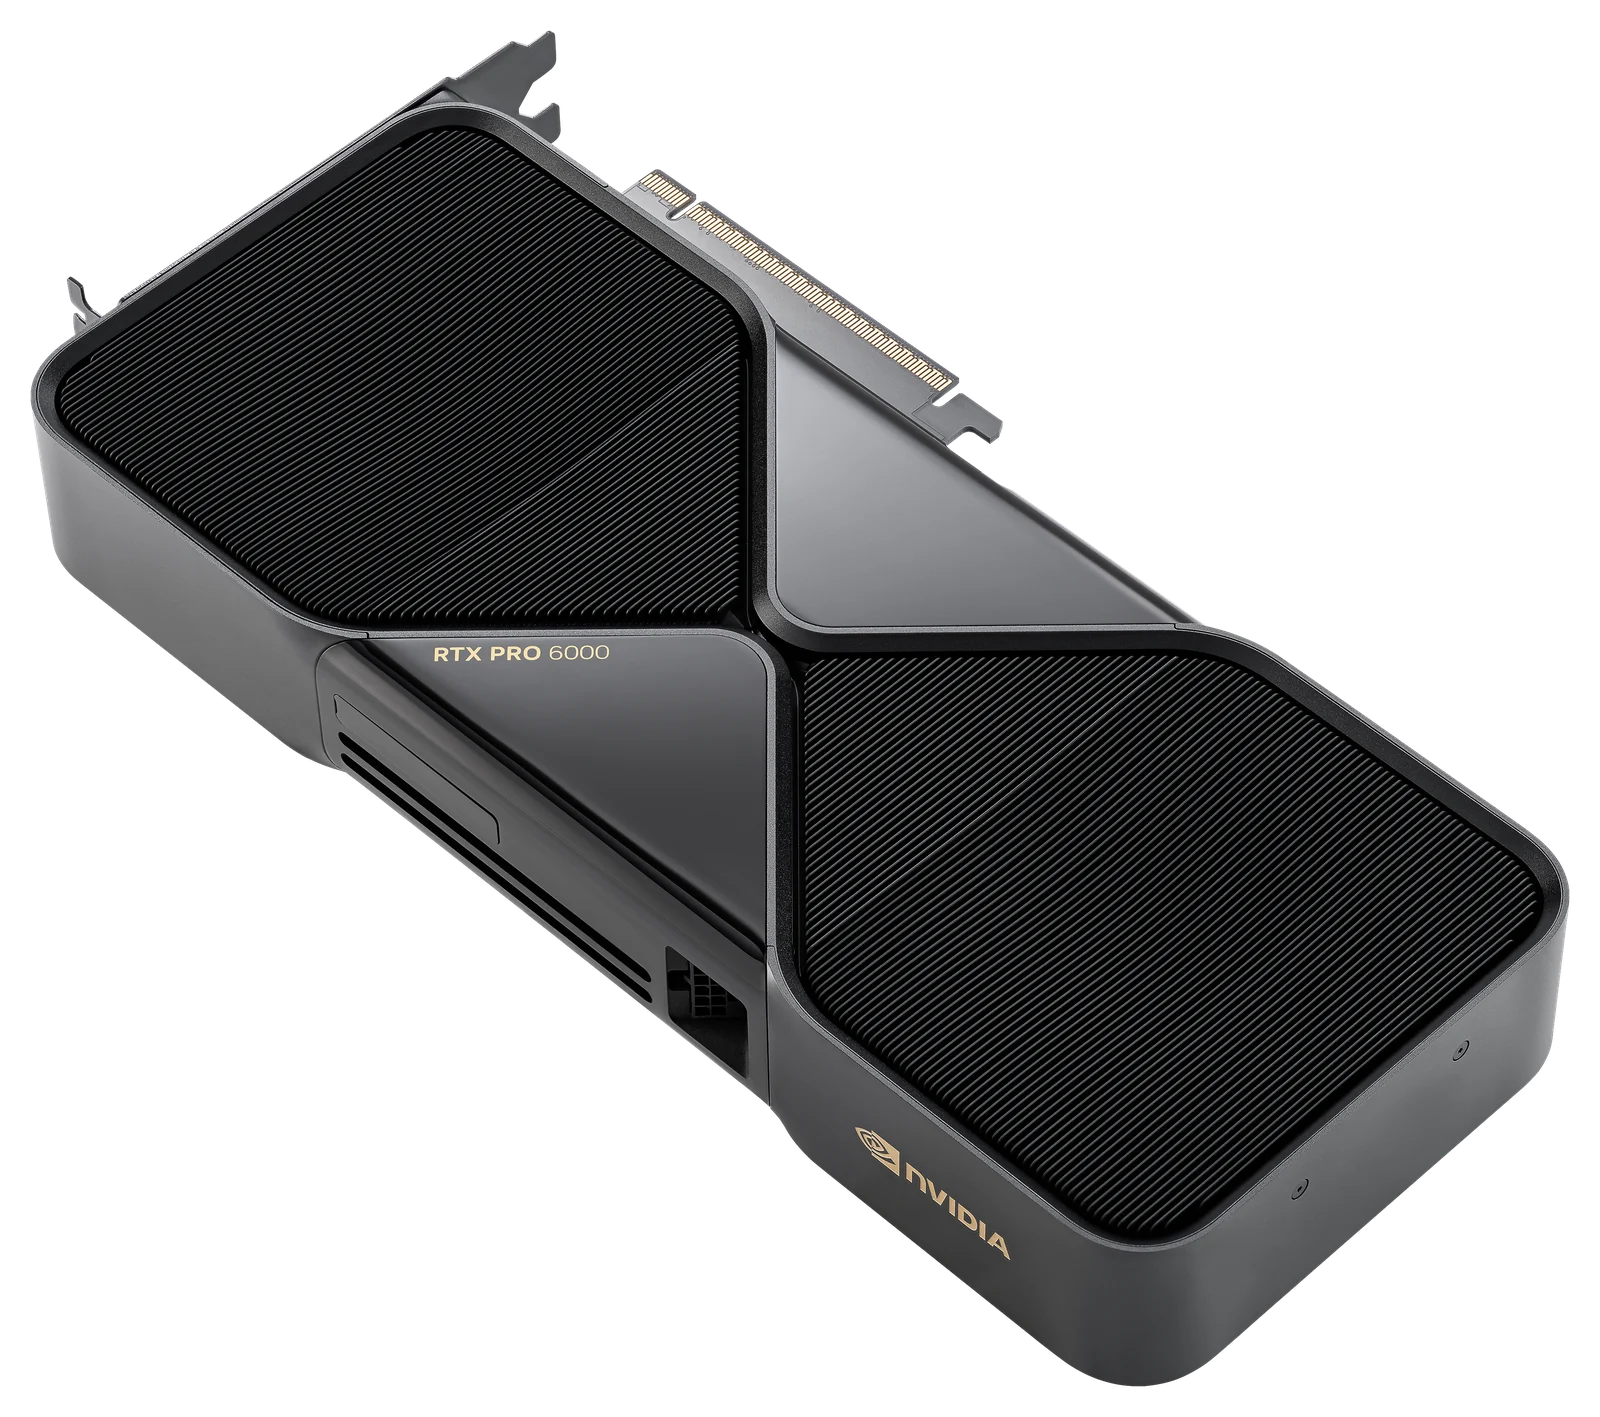
Кроме объёма важна скорость памяти. Теоретический потолок генерации для модели 70B в FP8 на одной RTX PRO 6000 (1,79 ТБ/с) около 25 токенов в секунду на диалог, на H200 NVL (4,8 ТБ/с) около 69. На практике выходит меньше, а под нагрузкой скорость на одного пользователя падает ещё сильнее.
Расчёт для корпоративного ИИ-ассистента на 50, 300 и 1 000 сотрудников
Сотрудники пишут ассистенту не одновременно: кто-то читает ответ, кто-то на встрече. Для расчёта примем допущение, что в пиковую минуту модель одновременно отвечает 5–10% штата. Это ориентир, а не правило: после пилота лучше измерить реальную нагрузку и пересчитать.
| Сотрудников | Одновременных запросов | KV-кеш при 8 тысячах токенов | Веса 70B FP8 и кеш | Вариант железа |
|---|---|---|---|---|
| 50 | 3–5 | 8–13 ГБ | 85–97 ГБ | 1 × H200 NVL или 1 × RTX PRO 6000 с моделью поменьше |
| 300 | 15–30 | 38–75 ГБ | 115–160 ГБ | 2 × RTX PRO 6000 или 2 × H200 NVL |
| 1 000 | 50–100 | 125–250 ГБ | 200–335 ГБ | сервер на 8 × RTX PRO 6000, несколько копий модели |
Что стоит за цифрами:
- 50 сотрудников. Одна RTX PRO 6000 со 96 ГБ для модели 70B в FP8 работает впритык. Запас даёт H200 NVL со 141 ГБ. Другой путь: оставить RTX PRO 6000 и взять модель поменьше, например Qwen3 32B в FP8, или 70B в 4 битах.
- 300 сотрудников. Две карты дают 192 или 282 ГБ. Пара H200 NVL соединяется NVLink-мостом и отвечает быстрее за счёт HBM3e, пара RTX PRO 6000 обойдётся заметно дешевле.
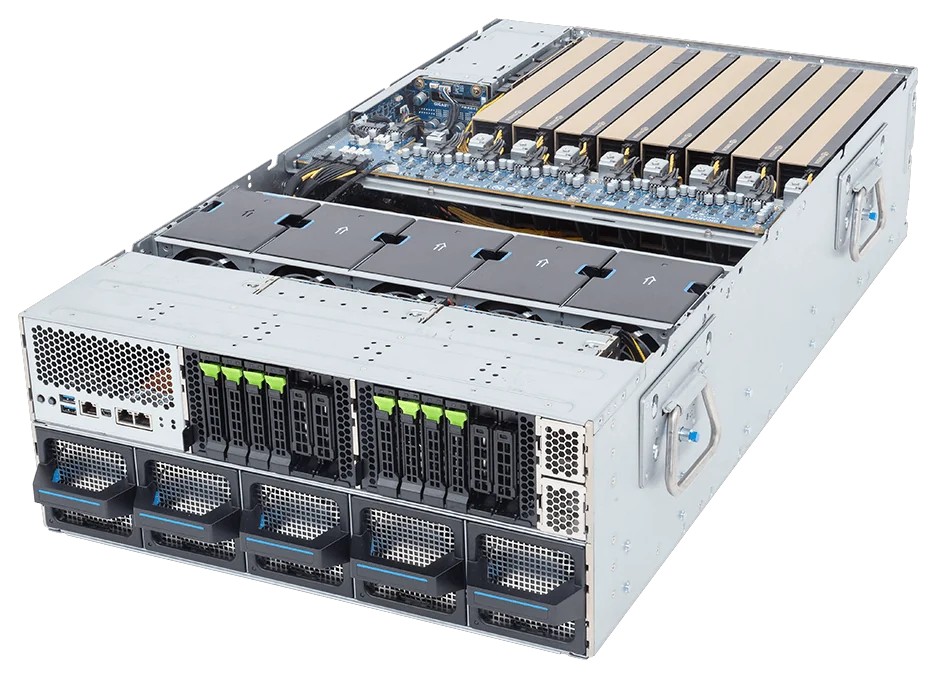
- 1 000 сотрудников. Здесь важна ещё и отказоустойчивость, поэтому модель лучше запускать в нескольких копиях. На сервере Gigabyte с восемью RTX PRO 6000 и 768 ГБ памяти помещаются, например, четыре копии по две карты. Если одна копия перезапускается, остальные продолжают отвечать.
Типовые конфигурации
- Пилот и небольшая компания. Одна RTX PRO 6000 в рабочей станции или сервере. С моделью 32B на той же карте остаётся место для эмбеддингов и реранкера.
- Компания на сотни сотрудников. Две H200 NVL с NVLink-мостом или две RTX PRO 6000 в сервере, вспомогательные модели на отдельной карте.
- Крупная компания. Сервер Gigabyte XL44-SX2: восемь RTX PRO 6000 Server Edition, 768 ГБ памяти GPU в корпусе 4U. Хватает на несколько копий основной модели, эмбеддинги и реранкер.
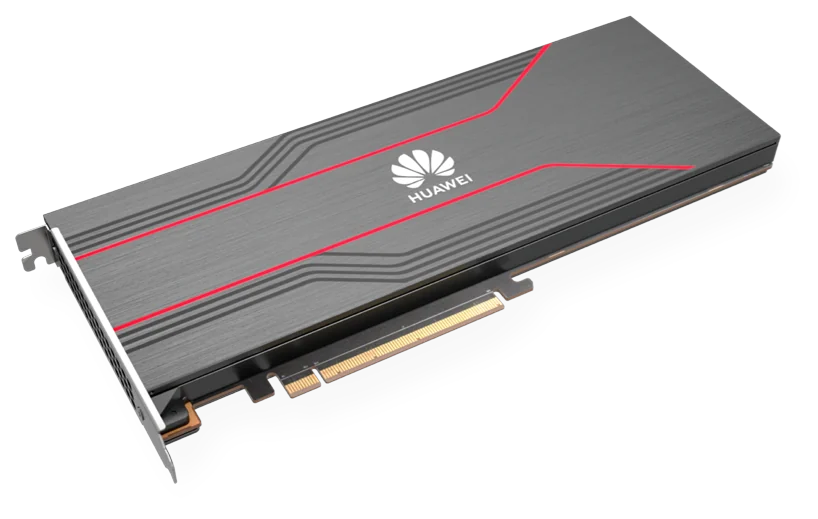
- Вспомогательные модели отдельно. Atlas 300I Duo: 96 ГБ памяти при 150 Вт в одном слоте. Подходит для распознавания документов, эмбеддингов или пилота с небольшой моделью. Память у неё медленнее (408 ГБ/с), поэтому основную модель на сотни пользователей лучше держать на GPU с GDDR7 или HBM. Перед выбором проверьте, что нужные модели поддерживаются стеком Huawei.
- Полностью на Huawei. Atlas 800I A2: восемь Ascend 910B и 512 ГБ HBM, инференс моделей до 235B.
Для многопользовательского сервиса нужен движок с непрерывным батчингом: vLLM или SGLang, а не Ollama. Почему, объясняем в статье о выборе между vLLM, Ollama и SGLang. Процессор, оперативную память и диски под векторную базу подбирают по тем же правилам, что для любого сервера с локальной LLM.
Безопасность данных
Главная причина ставить ассистента на свой сервер: документы, вопросы и ответы не покидают вашу инфраструктуру и не передаются внешнему сервису. Но железо решает только половину задачи.
- Права доступа на этапе поиска. У каждого фрагмента в индексе должна быть метка с правами исходного документа, и поиск должен возвращать только то, что сотрудник может открыть сам. Иначе ассистент перескажет документ, к которому у человека нет доступа.
- Актуальность индекса. Изменённые и удалённые документы нужно переиндексировать, иначе ассистент будет цитировать старые версии.
- Журнал запросов. Логи вопросов, найденных фрагментов и ответов помогают разбирать ошибки и проводить аудит.
- Ссылки на источники. Ответ с указанием документа сотрудник может быстро проверить.
- Лицензия модели. Qwen3 и gpt-oss выпущены под Apache 2.0, DeepSeek V3 и R1 под MIT: их можно использовать в коммерческих продуктах.
Коротко
- RAG находит фрагменты документов и передаёт их модели, обучать модель на ваших данных не нужно.
- Основную память занимает языковая модель: веса плюс KV-кеш длинных запросов с найденными фрагментами.
- Эмбеддинги, реранкер и векторная база требуют в разы меньше ресурсов, базе GPU не нужен.
- Память считают по одновременным запросам: при допущении 5–10% от штата это одна карта на 50 человек, две на 300 и сервер на восемь GPU на 1 000.
- Права доступа проверяются на этапе поиска, иначе ассистент покажет лишнее.
Если вы планируете корпоративного ИИ-ассистента, пришлите число сотрудников, объём документов и желаемую модель: оставьте заявку, и мы предложим конфигурацию с расчётом. Цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
Gigabyte
Gigabyte XL44-SX2
Восемь RTX PRO 6000 в одном сервере: 768 ГБ памяти GPU.
- RTX PRO 6000
- 8GPU
- Память GPU
- 768ГБ
- Высота
- 4U
Цена по запросу
Huawei
Atlas 300I Duo
Самый доступный вход в инференс: два чипа Ascend и 96 ГБ памяти.
- LPDDR4X
- 96ГБ
- INT8
- 280TOPS
- Потребление
- 150Вт
от 230 000 ₽
Читайте также
Сервер для локальной LLM в компании: как подобрать конфигурацию
Как подобрать сервер для LLM в компании: расчёт памяти под модель и пользователей, KV-кеш, три типовые конфигурации от отдела до крупного сервиса и софт для запуска.
vLLM, Ollama или SGLang: чем запускать LLM на сервере
vLLM или Ollama, SGLang или TensorRT-LLM: чем отличаются движки для запуска LLM, что выбрать для сервиса на компанию и как движок влияет на выбор GPU.
Qwen3 локально: какие GPU нужны для моделей 8B, 32B и 235B
Как запустить Qwen3 локально или на своём сервере: сколько памяти нужно моделям от 8B до 235B в BF16, FP8 и 4 битах и какие GPU и серверы под них подойдут.