Выбор оборудования
Как выбрать видеокарту для нейросетей: память, скорость, бюджет
Как выбрать видеокарту для нейросетей: какие параметры важнее, чем игровые карты отличаются от серверных, сколько нужно памяти и какая карта подойдёт под вашу задачу.
Содержание
Видеокарта для нейросетей выбирается по четырём параметрам, и порядок здесь важен: сначала объём памяти, потом её скорость, затем поддержка форматов FP8 и FP4 и только после этого софт и бюджет. Для моделей до 32B в 4 битах хватает 32 ГБ (GeForce RTX 5090), для Llama 3.3 70B в FP8 и gpt-oss-120b нужна карта на 96 ГБ (RTX PRO 6000), а для сервиса на много пользователей лучше подходит H200 NVL со 141 ГБ быстрой памяти HBM3e. Ниже разберём каждый параметр, отличия игровых карт от серверных и типовые сценарии.
Видеокарта для нейросетей: четыре параметра по важности
1. Объём памяти
Это главный параметр. Если модель вместе с контекстом не помещается в память карты, она либо не запустится, либо часть данных уйдёт в оперативную память компьютера, и работа замедлится в десятки раз.
Объём под веса считается просто: миллиарды параметров × байт на параметр (2 для FP16 и BF16, 1 для FP8, 0,5 для 4 бит) плюс 10–20% служебного. Сверху добавляется KV-кеш под контекст: для Llama 3 70B это около 10 ГБ на один диалог длиной 32 тысячи токенов. Подробный расчёт с таблицей популярных моделей есть в статье «Сколько видеопамяти нужно для LLM».
2. Скорость памяти
Когда видеокарта для LLM генерирует текст, на каждый новый токен она читает из памяти все веса модели (у MoE-моделей только активные). Поэтому скорость ответа упирается в пропускную способность памяти, а не в вычисления. Теоретический потолок для одного диалога: скорость памяти ÷ объём весов.
Пример для Qwen3 32B в 4 битах, это около 18 ГБ весов:
| Карта | Скорость памяти | Теоретический потолок, токенов в секунду |
|---|---|---|
| Atlas 300I Duo | 408 ГБ/с | ~23 |
| GeForce RTX 5090 | 1,79 ТБ/с | ~100 |
| RTX PRO 6000 Blackwell | 1,79 ТБ/с | ~100 |
| H200 NVL | 4,8 ТБ/с | ~265 |
На практике скорость ниже, но соотношение между картами честное. Обратите внимание: если модель помещается в память, RTX 5090 и RTX PRO 6000 дают одинаковый потолок генерации, потому что скорость памяти у них одна. Разница между ними в объёме, а не в скорости ответа.
3. Форматы FP8 и FP4
Чем меньше байт на параметр, тем меньше памяти занимает модель и тем быстрее она генерирует. Прирост вычислительной мощности даёт только аппаратная поддержка формата:
- FP8 аппаратно поддерживают Hopper (H100, H200) и Blackwell.
- FP4 (NVFP4) аппаратно есть только в Blackwell: RTX 5090, RTX PRO 6000, B200.
- У Atlas 300I Duo в характеристиках указаны INT8 и FP16. Первая карта Huawei с поддержкой FP4 это Atlas 350.
Квантованную модель можно запустить и без аппаратной поддержки формата, например 4-битную на H200. Выигрыш в памяти и скорости чтения весов сохранится, но вычисления пойдут в более широком формате.
4. Софт
Почти всё в машинном обучении пишется и проверяется в первую очередь на CUDA: PyTorch, vLLM, TensorRT-LLM, библиотеки для дообучения. Если вы подбираете GPU для машинного обучения, где будет собственный обучающий код и эксперименты, NVIDIA снимает вопрос совместимости.
У Huawei свой стек: CANN, MindSpore, MindIE, vLLM Ascend и PyTorch через torch_npu. Популярные открытые модели, такие как DeepSeek и Qwen, на нём запускаются. Перенос собственного кода и нишевых библиотек потребует времени инженеров, это стоит заложить в план.
Игровые, профессиональные и серверные карты: в чём разница
У RTX 5090 и RTX PRO 6000 одна архитектура Blackwell и одинаковая скорость памяти 1,79 ТБ/с. Отличаются они тем, что вокруг чипа: объёмом памяти, охлаждением, драйвером и функциями для многопользовательской работы.
| Игровые (GeForce) | Профессиональные (RTX PRO) | Серверные (H200 NVL, Atlas) | |
|---|---|---|---|
| Память | 32 ГБ у RTX 5090 | 96 ГБ с ECC | 141 ГБ HBM3e у H200 NVL |
| Охлаждение | открытые вентиляторы | активное, у Server Edition пассивное | пассивное, продувает сервер |
| Лицензия драйвера | не предусматривает дата-центры | станции и серверы | серверы |
| Разделение GPU (MIG) | нет | до 4 экземпляров | до 7 у H200 NVL |
| Где ставить | ПК, рабочая станция | станция или сервер | сервер в серверной |
Что из этого важно на практике:
- ECC. Коррекция ошибок памяти защищает от редких, но неприятных сбоев в обучении, которое идёт сутками, и в сервисе, который работает круглосуточно. У RTX PRO 6000 и карт Huawei память с ECC указана в характеристиках.
- Охлаждение. Игровая карта с открытыми вентиляторами выдувает горячий воздух внутрь корпуса. Для одной карты это нормально, для четырёх рядом уже проблема. Серверные карты делают пассивными: радиатор продувают вентиляторы сервера. Версия RTX PRO 6000 Max-Q на 300 Вт задумана для станций с несколькими картами.
- Драйвер. Лицензия драйвера GeForce не предусматривает установку в дата-центрах (кроме обработки блокчейна). Для серверов NVIDIA предлагает профессиональные и серверные карты, поэтому в серверы ставят RTX PRO 6000 Server Edition, H200 NVL и старшие модели.
- Форм-фактор. Atlas 300I Duo занимает один слот полной высоты и длины, такие карты удобно ставить по несколько штук в обычный сервер.
Подробное сравнение двух карт на Blackwell мы разобрали в статье «RTX 5090 или RTX PRO 6000».
Энергопотребление и блок питания
Потребление карт из каталога:
- RTX 5090: 575 Вт, разъём питания 16-pin 12V-2x6.
- RTX PRO 6000: 600 Вт, в версии Max-Q 300 Вт.
- H200 NVL: до 600 Вт.
- Atlas 300I Duo: 150 Вт.
Блок питания считают так: сумма потребления карт плюс процессор, память и диски, и сверху запас. Две RTX PRO 6000 в полной версии забирают 1 200 Вт только на карты, а две Max-Q дают те же 192 ГБ памяти при 600 Вт. Для станции на несколько карт это часто решающий довод: проще уложиться в один блок питания и одну линию электросети.
Всё потребление превращается в тепло. Станция на полтора киловатта греет комнату как бытовой обогреватель, который работает без перерыва, и это стоит учесть до покупки.
Сравнение карт: от 32 до 141 ГБ
| Карта | Память | Скорость памяти | Аппаратный FP4 | Потребление | Интерфейс |
|---|---|---|---|---|---|
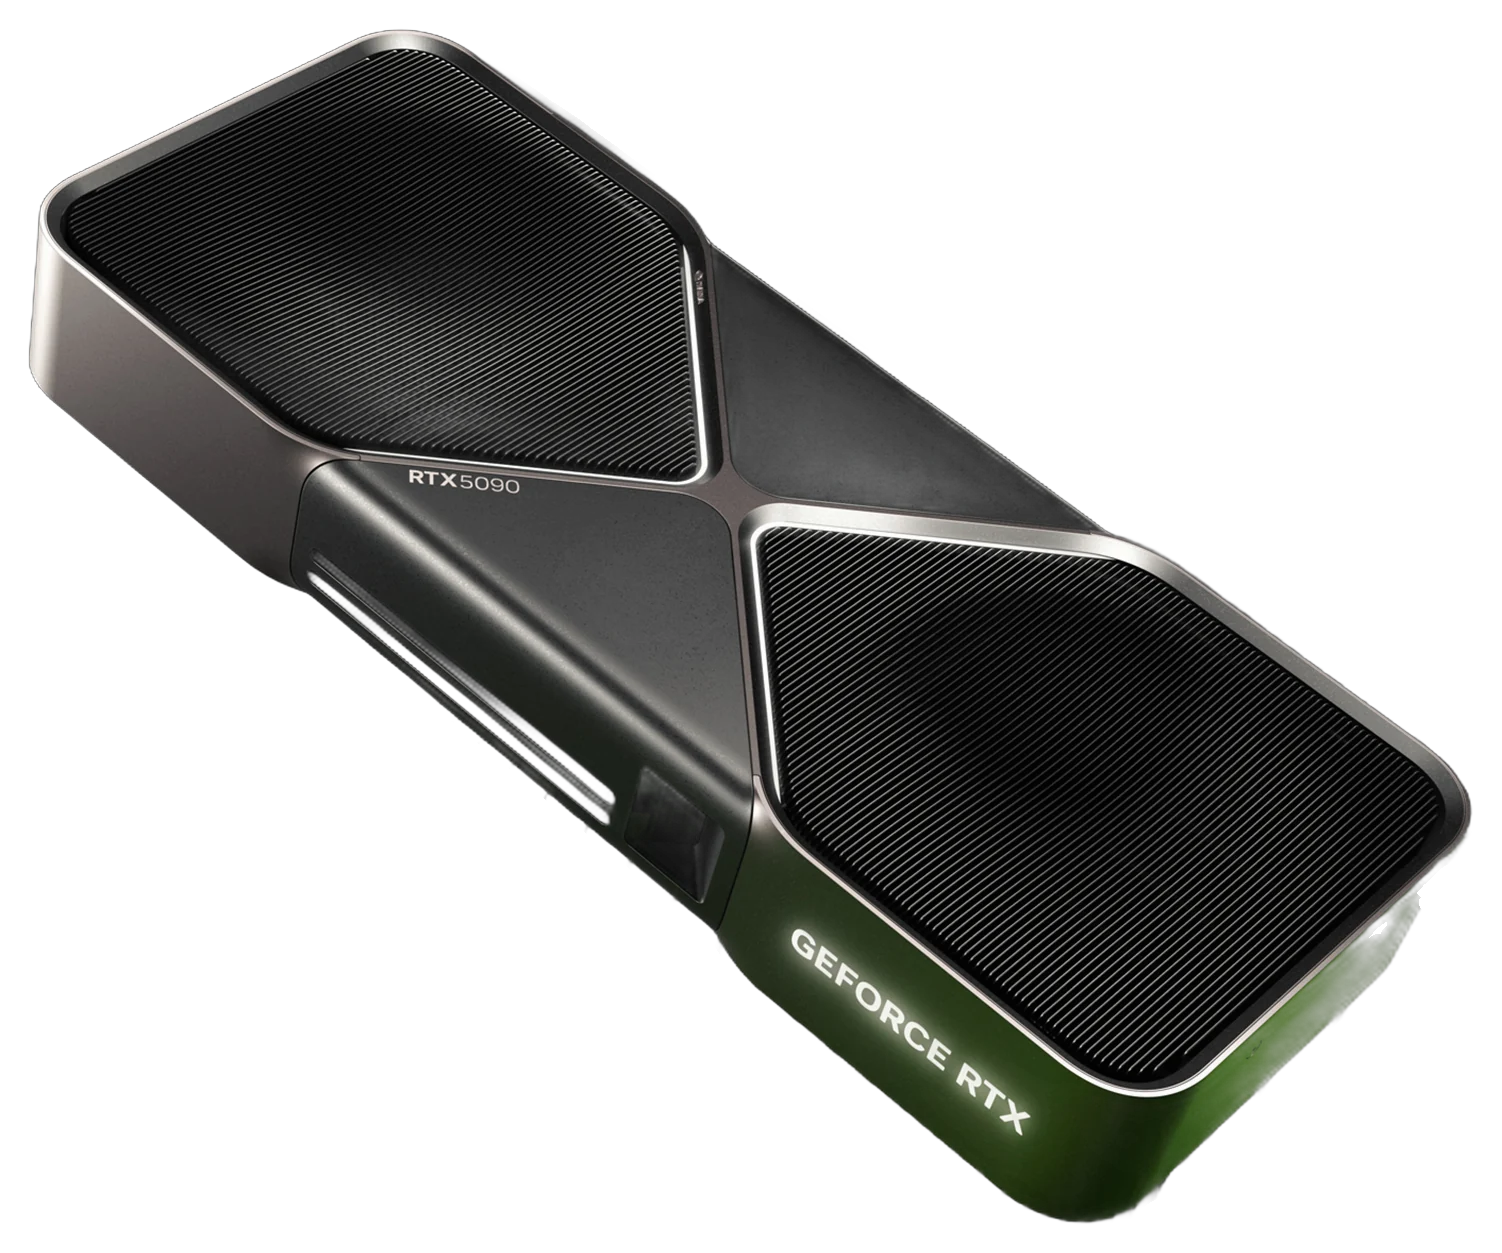
| GeForce RTX 5090 | 32 ГБ GDDR7 | 1,79 ТБ/с | да, 3 352 TOPS | 575 Вт | PCIe 5.0 x16 |
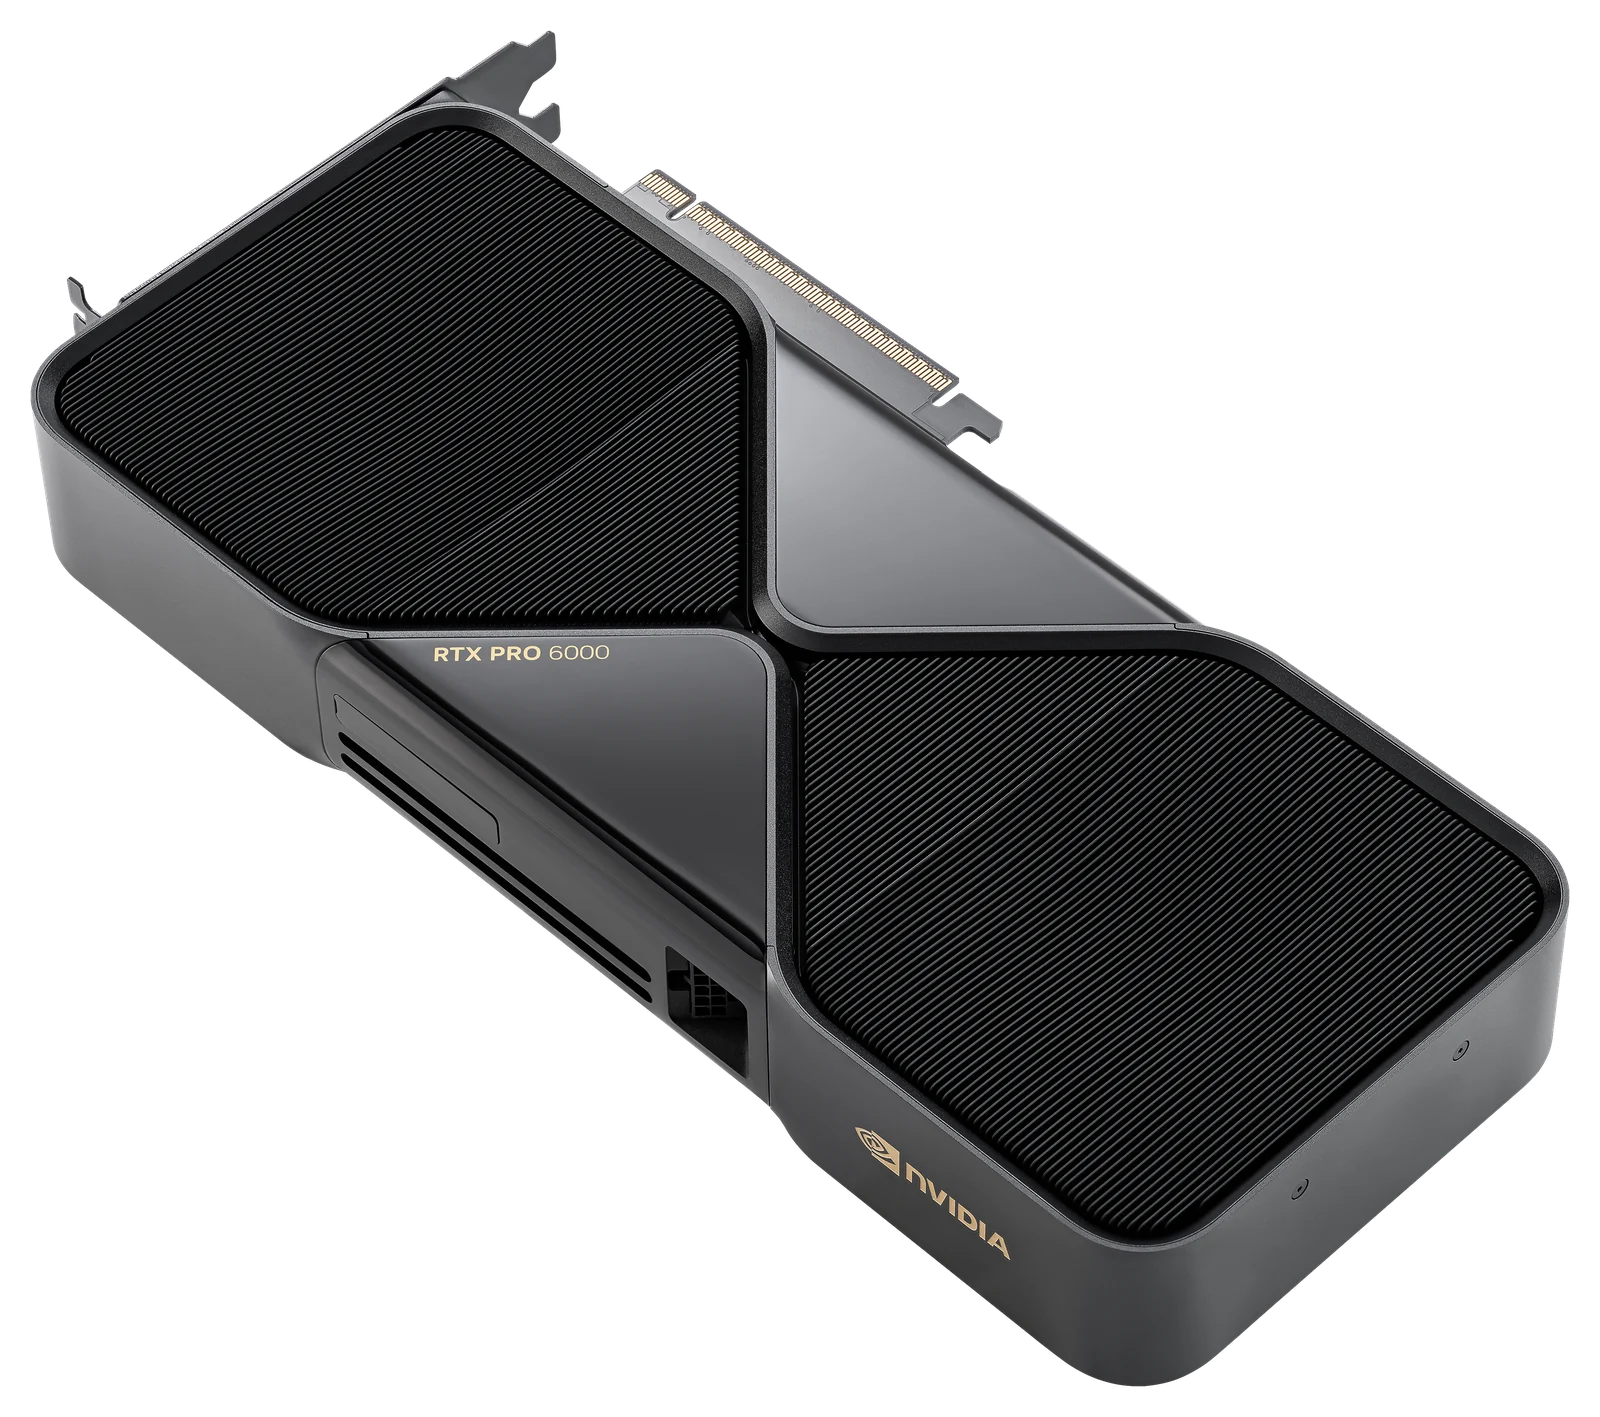
| RTX PRO 6000 Blackwell | 96 ГБ GDDR7 с ECC | 1,79 ТБ/с | да, 4 000 TOPS | 600 Вт, Max-Q 300 Вт | PCIe 5.0 x16 |
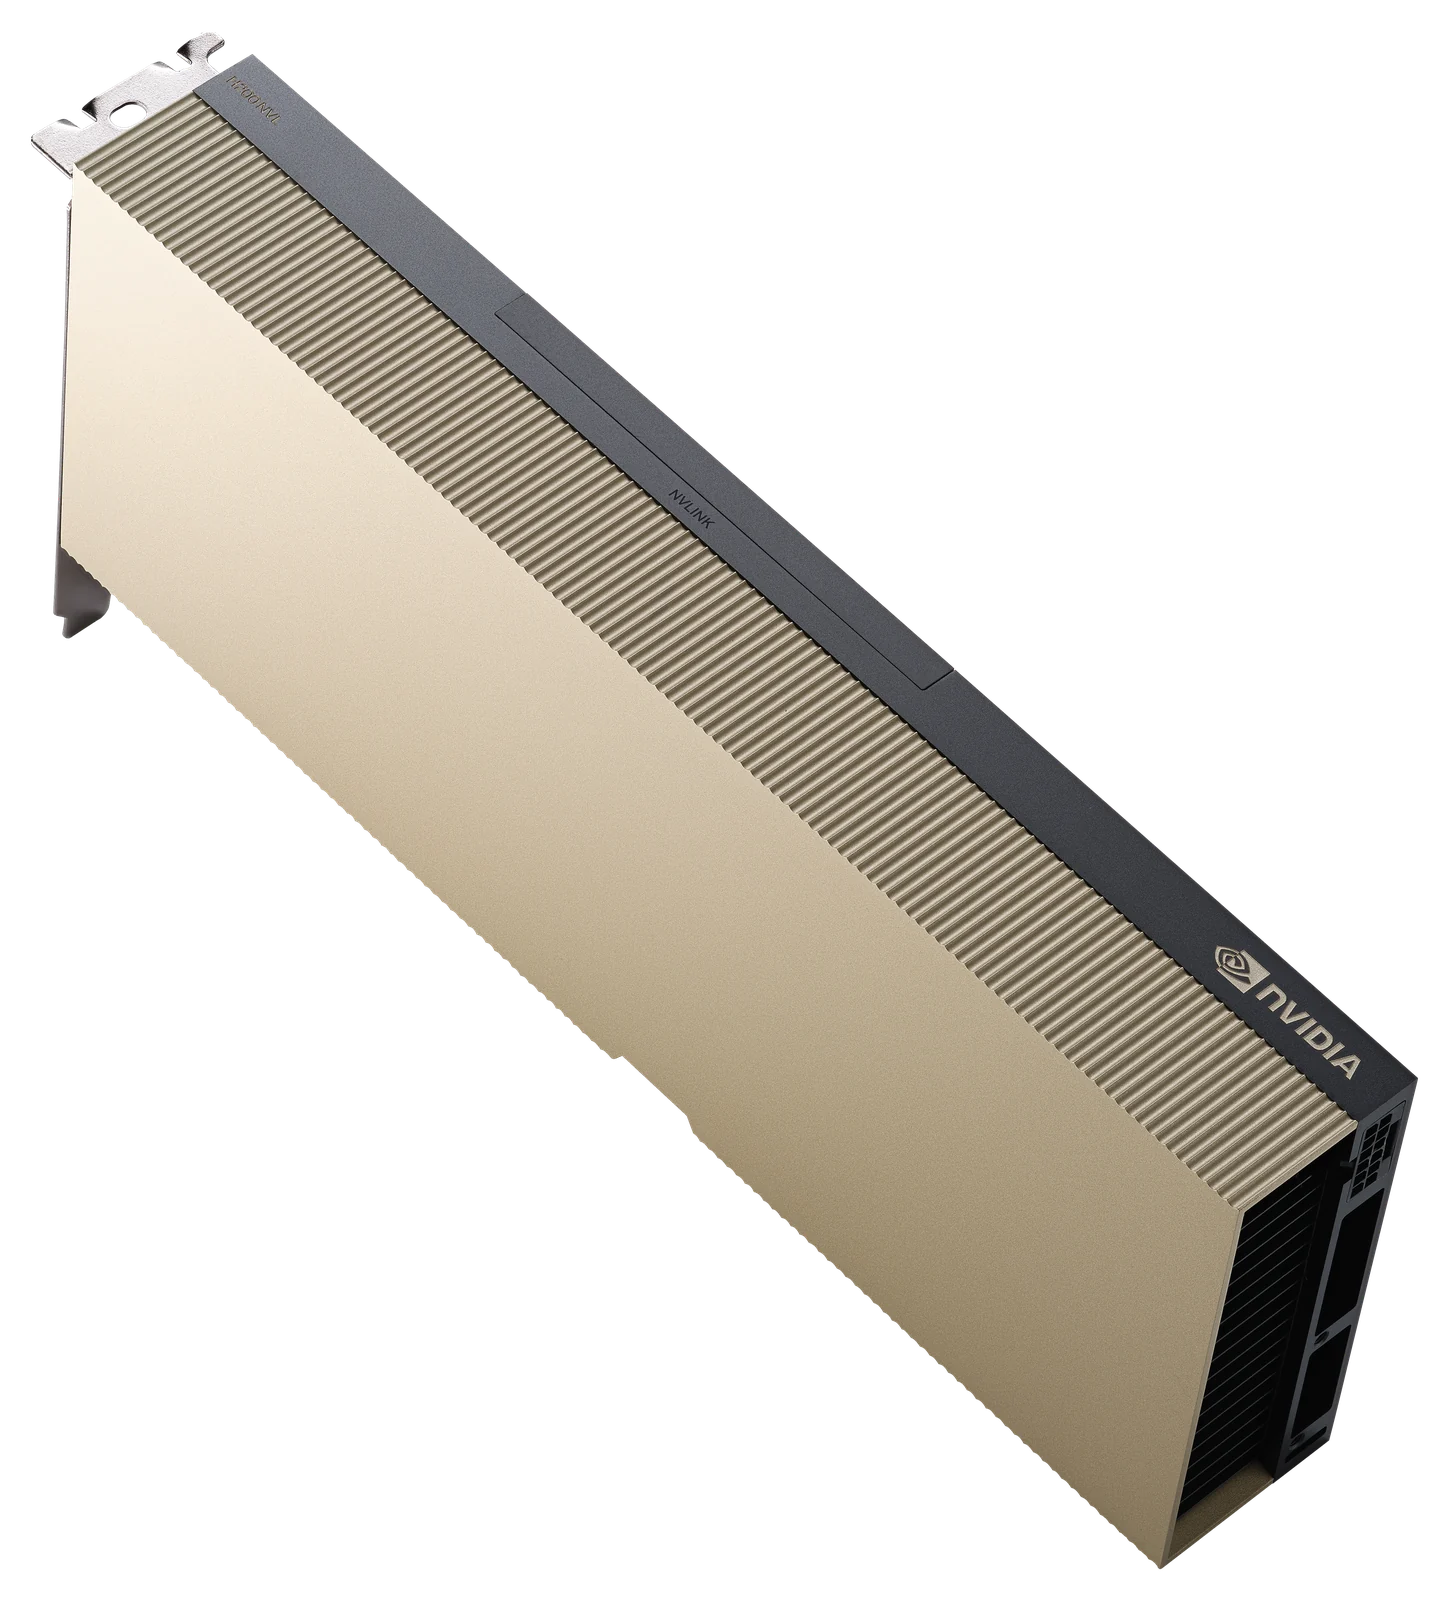
| H200 NVL | 141 ГБ HBM3e | 4,8 ТБ/с | нет, FP8 3 341 TFLOPS | до 600 Вт | PCIe 5.0 x16, мост NVLink |
| Atlas 300I Duo | 96 ГБ LPDDR4X с ECC | 408 ГБ/с | нет, INT8 280 TOPS | 150 Вт | PCIe 4.0 x16 |
H200 NVL выигрывает не вычислениями в FP4, а памятью: её в полтора раза больше, чем у RTX PRO 6000, и она в 2,7 раза быстрее. Atlas 300I Duo по объёму равен RTX PRO 6000, но память у него в четыре с лишним раза медленнее, зато потребление в четыре раза ниже.
Как выбрать видеокарту для ИИ под задачу
- Один разработчик, эксперименты, генерация изображений, модели до 32B в 4 битах. GeForce RTX 5090: 32 ГБ быстрой памяти и аппаратный FP4. Хороший выбор для рабочей станции, но не для серверной из-за лицензии драйвера.
- Модели 70–120B на одной карте, несколько пользователей через MIG, дообучение. RTX PRO 6000 Blackwell: Llama 3.3 70B в FP8 (около 70 ГБ весов) и gpt-oss-120b (около 61 ГБ) помещаются вместе с кешем на несколько диалогов. Если нужно больше, восемь таких карт собраны в сервере Gigabyte XL44-SX2 с 768 ГБ памяти GPU.
- Сервис на десятки пользователей, длинный контекст. H200 NVL: 141 ГБ HBM3e и 4,8 ТБ/с. Модель 70B в FP8 помещается с большим запасом под кеш, а две или четыре карты связываются мостом NVLink на 900 ГБ/с, если модель крупнее.
- Инференс небольших и средних моделей, видеоаналитика, стек Huawei. Atlas 300I Duo: 96 ГБ при 150 Вт и декодирование 256 видеопотоков 1080p. Генерация медленнее из-за памяти LPDDR4X, но карта занимает один слот и не требует мощного питания.
- Обучение моделей и полное дообучение крупных. Одной карты здесь мало: полное обучение требует около 16–18 байт на параметр, и модели 70B нужно больше 1 ТБ памяти GPU. Это задача для сервера на восемь GPU, о нём отдельная статья про сервер для обучения нейросетей.
Коротко
- Порядок выбора: объём памяти, скорость памяти, поддержка FP8 и FP4, софт.
- Объём решает, поместится ли модель с контекстом, а скорость памяти решает, как быстро она ответит.
- RTX 5090 и RTX PRO 6000 одинаково быстро генерируют на моделях, которые помещаются в 32 ГБ. RTX PRO 6000 берут за 96 ГБ, ECC, MIG и серверную версию.
- H200 NVL нужна для многопользовательского сервиса: памяти больше и она в 2,7 раза быстрее.
- Atlas 300I Duo даёт 96 ГБ при 150 Вт для инференса и видеоаналитики, когда скорость генерации не главное.
Если сомневаетесь, какая карта подойдёт под вашу модель и нагрузку, оставьте заявку: подберём варианты на NVIDIA и Huawei, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
NVIDIA
GeForce RTX 5090
Самая мощная потребительская карта: модели до 32B, генерация изображений и видео.
- GDDR7
- 32ГБ
- ИИ, FP4
- 3352TOPS
- Потребление
- 575Вт
от 350 000 ₽
NVIDIA
H200 NVL
Больше всего памяти в формате PCIe: 141 ГБ HBM3e на карту.
- HBM3e
- 141ГБ
- Скорость памяти
- 4,8ТБ/с
- FP8
- 3341TFLOPS
Цена по запросу
Читайте также
Сколько видеопамяти нужно для LLM: расчёт для моделей от 8B до 671B
Простая формула, сколько видеопамяти нужно языковой модели: веса, KV-кеш и запас. Таблица для Qwen3, Llama 70B, gpt-oss и DeepSeek и подбор GPU под объём.
RTX 5090 vs RTX PRO 6000 Blackwell: что взять для ИИ
RTX 5090 vs RTX PRO 6000: одна архитектура и одинаковая скорость памяти, но 32 ГБ против 96 ГБ. Разбираем ECC, MIG, лицензию драйвера и кому какая карта подходит.
Видеокарта для Stable Diffusion, Flux и Wan: изображения и видео
Видеокарта для Stable Diffusion, FLUX и Wan: сколько памяти занимают модели, когда хватит RTX 5090, зачем 96 ГБ, что дают FP8 и FP4 и как устроить студийную очередь.