Обзоры
NVIDIA DGX B300: обзор флагманской системы на Blackwell Ultra
Обзор NVIDIA DGX B300: характеристики, чем система на Blackwell Ultra отличается от DGX B200, для каких задач она нужна и что подготовить под питание и сеть.
Содержание
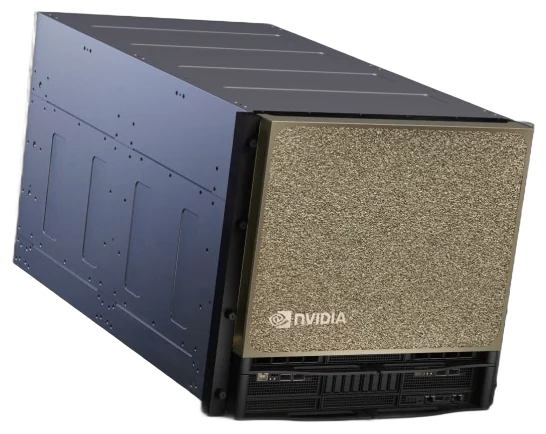
NVIDIA DGX B300 это сервер высотой 10U на восьми GPU Blackwell Ultra: 2,1 ТБ памяти HBM3e, сеть ConnectX-8 до 800 Гбит/с и потребление около 14 кВт. Пиковая производительность по каталогу такая же, как у DGX B200 (72 ПФЛОПС в FP8 и 144 ПФЛОПС в FP4), а памяти почти в полтора раза больше. Система нужна там, где 1,44 ТБ уже тесно: обучение крупных моделей, рассуждающие модели с длинным контекстом, сервисы с большим числом одновременных пользователей.
Характеристики NVIDIA DGX B300
Цифры из карточки DGX B300 в нашем каталоге:
- GPU: 8 × B300 Blackwell Ultra;
- память GPU: 2,1 ТБ HBM3e;
- производительность: 72 ПФЛОПС в FP8 для обучения, 144 ПФЛОПС в FP4 для инференса;
- процессоры: 2 × Intel Xeon 6776P;
- сеть: ConnectX-8, до 800 Гбит/с;
- высота: 10U;
- энергопотребление: около 14 кВт.
Blackwell Ultra это обновлённая версия архитектуры Blackwell, на которой построены B200. Поколение одно, поэтому программный стек общий: CUDA, TensorRT-LLM, NIM, NVIDIA AI Enterprise. FP8 и FP4 (NVFP4) поддерживаются аппаратно, а GPU внутри системы связаны через NVLink 5 со скоростью 1,8 ТБ/с на каждый.
Как и другие DGX, B300 поставляется готовой системой NVIDIA. Конфигурация фиксирована, софт и референсные архитектуры для сборки кластеров идут от производителя. Это упрощает запуск, но не оставляет свободы в выборе процессоров, дисков и сети.
B300 или B200: что изменилось
Если положить рядом карточки DGX B300 и DGX B200, отличий окажется меньше, чем ждёшь от нового флагмана.
- Память: 2,1 ТБ против 1 440 ГБ, примерно на 46% больше. Это главное отличие.
- Сеть: ConnectX-8 до 800 Гбит/с. Для сравнения, в DGX H200 по каталогу стоят адаптеры ConnectX-7 на 400 Гбит/с.
- Процессоры: Intel Xeon 6776P вместо Xeon Platinum 8570.
Высота 10U и пиковые 72 ПФЛОПС в FP8 и 144 ПФЛОПС в FP4 (с разреженностью) у обеих систем одинаковые. Разница видна в плотном FP4, без разреженности: по данным NVIDIA, 108 ПФЛОПС у DGX B300 против 72 у DGX B200. Потребление почти совпадает: около 14 кВт против до 14,3 кВт. Выходит, B300 выбирают ради памяти, сети и инференса в FP4, а не ради обучения в FP8.
Почему память так важна? Чем её больше, тем больше запросов помещается в один батч, тем больше места под кеш длинных диалогов и тем реже модель приходится делить между серверами. На реальной нагрузке это часто значит больше, чем пиковые терафлопсы.
| Параметр | DGX B300 | DGX B200 | Supermicro HGX B200 |
|---|---|---|---|
| GPU | 8 × B300 Blackwell Ultra | 8 × B200 | 8 × B200 по 180 ГБ |
| Память GPU | 2,1 ТБ HBM3e | 1 440 ГБ HBM3e | 1 440 ГБ HBM3e |
| FP8, обучение | 72 ПФЛОПС | 72 ПФЛОПС | как у DGX B200 |
| FP4, инференс | 144 ПФЛОПС | 144 ПФЛОПС | как у DGX B200 |
| Процессоры | 2 × Xeon 6776P | 2 × Xeon Platinum 8570 | 2 × Xeon 6900 |
| Оперативная память | — | до 4 ТБ | до 6 ТБ DDR5 |
| Сеть | ConnectX-8, до 800 Гбит/с | — | на выбор: 10 слотов PCIe 5.0 x16 LP и 2 FHHL |
| Высота | 10U | 10U | 10U |
| Питание | около 14 кВт | до 14,3 кВт | 6 блоков по 5 250 Вт с резервированием |
Прочерк значит, что в карточке каталога параметр не указан. Его уточняем по спецификации под конкретный заказ.
Для каких задач нужна DGX B300
Обучение крупных моделей
Полное обучение со смешанной точностью и оптимизатором Adam требует около 16–18 байт на параметр: веса, градиенты и состояние оптимизатора. Для модели 70B это 1,1–1,3 ТБ ещё до активаций. В DGX B200 после этого остаётся 180–320 ГБ, в DGX B300 уже 840–980 ГБ. Это больший размер батча и более длинные последовательности в пределах одной системы.
Для моделей крупнее всё равно понадобится кластер. Но и там система с большей памятью сокращает число узлов, которые нужны под ту же модель.
Рассуждающие модели и длинный контекст
Рассуждающие модели вроде DeepSeek R1 сначала пишут длинную цепочку рассуждений и только потом ответ. Каждый токен этой цепочки хранится в KV-кеше. Для плотной модели уровня Llama 3 70B кеш занимает около 0,31 МБ на токен в FP16: это около 10 ГБ на диалог в 32 тысячи токенов и около 40 ГБ на 128 тысяч.
Теперь сама DeepSeek R1. Веса в родном FP8 занимают около 700 ГБ. В DGX B200 под кеш и служебные данные остаётся около 740 ГБ, в DGX B300 около 1,4 ТБ. Места под одновременные длинные диалоги почти вдвое больше, а от него зависит, сколько пользователей система обслужит без очереди.
Модели на триллион параметров
Kimi K2 содержит 1T параметров, из них 32B активных на токен. В 8-битном формате это по формуле около 1 ТБ только под веса, плюс 10–20% служебного, то есть 1,1–1,2 ТБ. В DGX H200 с её 1 128 ГБ такая модель помещается разве что впритык, без места под кеш. В DGX B200 под кеш останется 240–340 ГБ, в DGX B300 уже 900–1 000 ГБ.
Генерация у MoE-моделей быстрая, потому что на каждый токен читаются только активные веса. Но держать в памяти приходится все.
Питание, охлаждение и сеть
Около 14 кВт потребления с одной системы означают и около 14 кВт тепла: тепловыделение сервера практически равно его потреблению. В пересчёте это примерно 47 800 BTU/ч, которые кондиционеры должны отводить круглосуточно.
- Питание. У серверов такого класса несколько блоков питания с резервированием. Их подключают к двум независимым линиям, а ИБП рассчитывают на полную нагрузку с запасом.
- Охлаждение. Обычная серверная и стандартная стойка в офисном здании редко рассчитаны на такую плотность. Нужны холодные и горячие коридоры с достаточной холодопроизводительностью или размещение в ЦОД со стойками высокой плотности.
- Шум и место. Система на восемь GPU шумит как промышленное оборудование, рядом с рабочими местами её не поставить. Она займёт 10U, но в одну стойку обычно ставят одну-две такие системы: ограничение в киловаттах, а не в юнитах.
- Сеть. Для одного сервера инференса хватит обычной сети до пользователей. Быстрый ConnectX-8 нужен при объединении нескольких систем: в обучающем кластере на каждый GPU обычно выделяют свой сетевой порт, плюс отдельные сети для хранилища и управления.
Подробнее о подготовке площадки мы написали в статье про питание и охлаждение GPU-сервера. Выбор между InfiniBand XDR (800 Гбит/с на порт) и Ethernet с RoCE или Spectrum-X разобран в материале InfiniBand или Ethernet. Для кластера пригодится и GPUDirect RDMA: GPU разных серверов обмениваются данными по сети напрямую, минуя CPU.
Когда хватит DGX B200 или HGX-сервера
Флагман нужен не всем. Если ваши модели помещаются в 1,44 ТБ с запасом под кеш, B300 даст мало пользы за большие деньги.
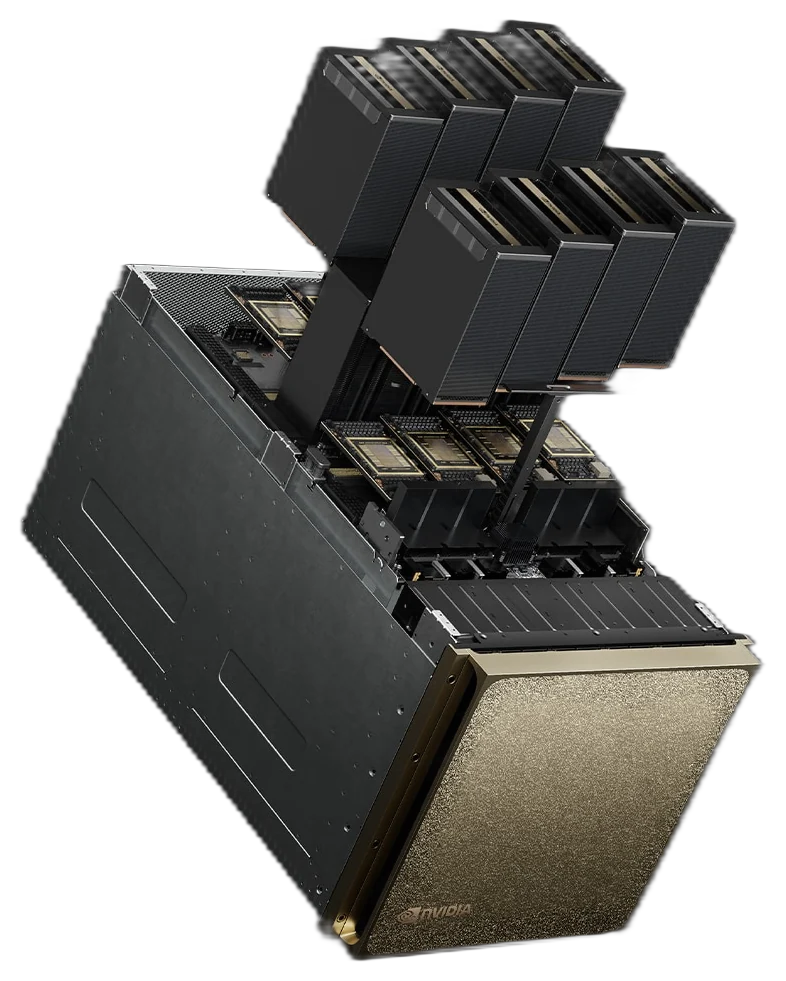
- DGX B200. Те же пиковые 72 и 144 ПФЛОПС, то же потребление, 1 440 ГБ памяти. Хватает для DeepSeek V3 и R1 в родном FP8 при умеренной нагрузке, для Qwen3 235B-A22B и для моделей в FP4.
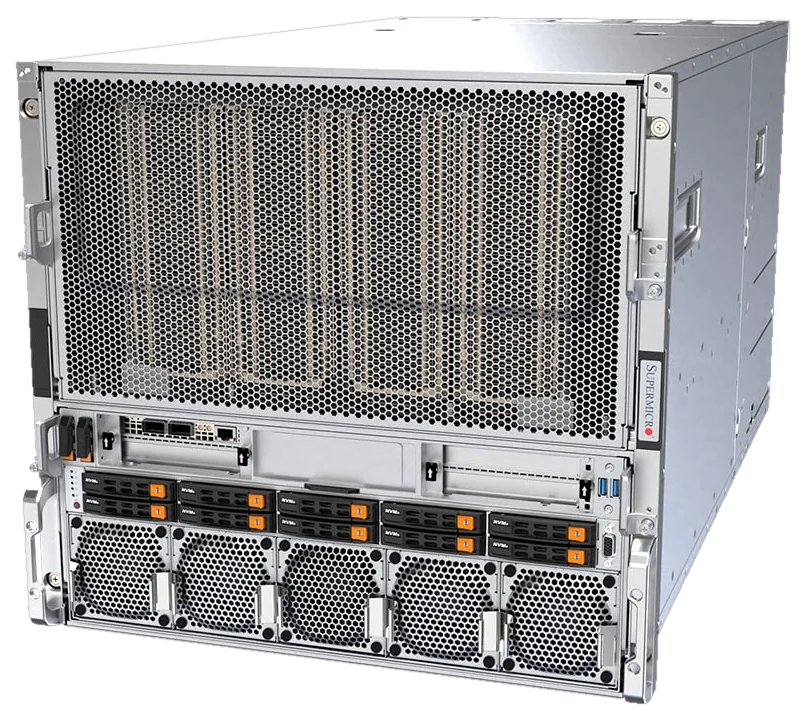
- Supermicro HGX B200. Те же восемь B200 на платформе HGX и производительность DGX B200, но конфигурация гибкая: 2 × Xeon 6900, до 6 ТБ DDR5, 10 накопителей NVMe U.2, сеть на ваш выбор. Обычно выходит дешевле DGX и подходит, если у вас свои требования к процессорам, дискам и сети.
- DGX H200. Подходит, если мощность стойки ограничена примерно 10 кВт и FP4 не нужен: 1 128 ГБ памяти при потреблении до 10,2 кВт.
Как выбрать между поколениями Hopper и Blackwell, мы разобрали в статье «H200 или B200».
Коротко
- NVIDIA DGX B300: 8 × B300 Blackwell Ultra, 2,1 ТБ HBM3e, ConnectX-8 до 800 Гбит/с, около 14 кВт, 10U.
- От DGX B200 отличается прежде всего памятью (почти в полтора раза больше) и сетью. Пиковые FP8 и FP4 в каталоге одинаковые.
- Брать стоит, когда упираетесь в память: полное обучение моделей от 70B, рассуждающие модели с длинным контекстом, модели на 1T параметров.
- Если модель с запасом помещается в 1,44 ТБ, хватит DGX B200 или HGX-сервера на B200.
Если выбираете между DGX B300, DGX B200 и HGX-сервером, оставьте заявку: опишите модели, число пользователей и возможности площадки. Предложим конфигурацию, а цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA Флагман
DGX B300
Текущий флагман: Blackwell Ultra и 2,1 ТБ памяти GPU.
- Blackwell Ultra
- 8GPU
- Память GPU
- 2,1ТБ
- FP4
- 144ПФЛОПС
Цена по запросу
NVIDIA
DGX B200
Blackwell для обучения и инференса: 1,44 ТБ памяти GPU.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- FP4
- 144ПФЛОПС
Цена по запросу
Supermicro
Supermicro SYS-A22GA-NBRT
Сервер на HGX B200: Blackwell без переплаты за бренд DGX.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- Высота
- 10U
Цена по запросу
Читайте также
H200 vs B200: сравнение NVIDIA Hopper и Blackwell
H200 vs B200: память, скорость, FP4, NVLink 5 и потребление. Сравниваем DGX H200 и DGX B200 и объясняем, когда хватит Hopper, а когда нужен Blackwell.
InfiniBand или Ethernet: какая сеть нужна для GPU-кластера
InfiniBand или Ethernet с RoCE для GPU-кластера: когда сеть между серверами критична, чем отличаются технологии и что заложить при покупке первого сервера.
Сервер для обучения нейросетей: что важно кроме GPU
Сервер для обучения нейросетей: сколько памяти GPU нужно на параметр, зачем NVLink и быстрая сеть, какое хранилище и питание заложить и когда хватит одной карты.