Выбор оборудования
Сервер для локальной LLM в компании: как подобрать конфигурацию
Как подобрать сервер для LLM в компании: расчёт памяти под модель и пользователей, KV-кеш, три типовые конфигурации от отдела до крупного сервиса и софт для запуска.
Содержание
Сервер для LLM подбирают не по числу сотрудников, а по модели и числу одновременных запросов. Отделу на несколько десятков человек обычно хватает одной-двух карт RTX PRO 6000 по 96 ГБ, компании на сотни сотрудников нужен сервер на восемь GPU с 512–768 ГБ памяти, а сервису на модели уровня DeepSeek 671B требуется восемь H200 с 1 128 ГБ. Ниже порядок расчёта, три типовые конфигурации и софт, на котором всё это работает.
Зачем компании своя модель
Локальная LLM для компании (on-premise LLM) работает на вашем оборудовании, внутри вашего контура. Обычно так делают по трём причинам.
- Данные остаются внутри. Договоры, переписка, исходный код и коммерческая тайна не уходят во внешний сервис. Часто это требование службы безопасности, а не пожелание.
- Нет лимитов внешнего API. Ни ограничений на число запросов, ни очередей у провайдера в часы пик, ни внезапной смены условий. Модель и её версия под вашим контролем.
- Предсказуемые расходы. Вы платите за оборудование и электричество, а не за каждый токен. При постоянной нагрузке такие расходы проще планировать в бюджете.
Есть и четвёртая причина, менее очевидная: свою модель можно дообучить на внутренних данных и встроить в любые системы без согласования с внешним поставщиком.
Как рассчитать сервер для LLM: пять шагов
- Выберите модель. От неё зависит всё остальное. Многим внутренним задачам хватает моделей 30–70B, для сложных задач с рассуждениями берут MoE-модели на сотни миллиардов параметров: Qwen3 235B-A22B, gpt-oss-120b, DeepSeek V3 и R1.
- Посчитайте память под веса. Миллиарды параметров × байт на параметр плюс 10–20% служебного. Llama 3.3 70B в FP8 занимает около 70 ГБ, Qwen3 235B-A22B в FP8 около 235 ГБ, DeepSeek R1 в родном FP8 около 700 ГБ. Подробнее о расчёте в статье «Сколько видеопамяти нужно для LLM».
- Оцените одновременные запросы. Не число сотрудников, а число ответов, которые модель генерирует в один и тот же момент.
- Добавьте KV-кеш. Для Llama 3 70B это около 0,31 МБ на токен в FP16: диалог на 8 тысяч токенов занимает около 2,5 ГБ, на 32 тысячи около 10 ГБ. Умножьте на число одновременных запросов.
- Подберите конфигурацию с запасом 30–50% на рост: модели становятся крупнее, а пользователей со временем больше.
Одновременных запросов намного меньше, чем сотрудников
Сотрудник открывает ассистента несколько раз в день, читает ответ, думает, правит документ. Генерация занимает секунды, а между запросами проходят минуты. Поэтому даже в большой компании модель в каждый момент отвечает лишь небольшой части пользователей.
Пример с явными допущениями. Допустим, ассистентом пользуются 300 из 500 сотрудников, а в пиковый момент генерация идёт одновременно для 5% из них, то есть для 15 человек. Если средний диалог вместе с найденными документами занимает 8 тысяч токенов, кеш для Llama 3 70B потребует 15 × 2,5 ГБ, около 40 ГБ. Вместе с весами в FP8 и служебной памятью выходит около 120 ГБ: это две RTX PRO 6000 с запасом или одна H200 NVL без большого запаса.
Доля одновременных запросов здесь условная, её лучше измерить на пилоте. Но порядок цифр верный: сервер считают под десятки параллельных диалогов, а не под сотни сотрудников.
Три типовых уровня: отдел, компания, крупный сервис
| Уровень | Конфигурация | Память GPU | Какие модели |
|---|---|---|---|
| Отдел, пилот | 1–2 × RTX PRO 6000 | 96–192 ГБ | Qwen3 32B, Llama 3.3 70B в FP8, gpt-oss-120b |
| Компания, сотни сотрудников | 8 × RTX PRO 6000 или 8 × Ascend 910B | 768 или 512 ГБ | Qwen3 235B-A22B, несколько моделей одновременно |
| Крупный сервис | 8 × H200 SXM | 1 128 ГБ | DeepSeek V3 и R1 в родном FP8, длинный контекст |
Отдел: одна или две RTX PRO 6000
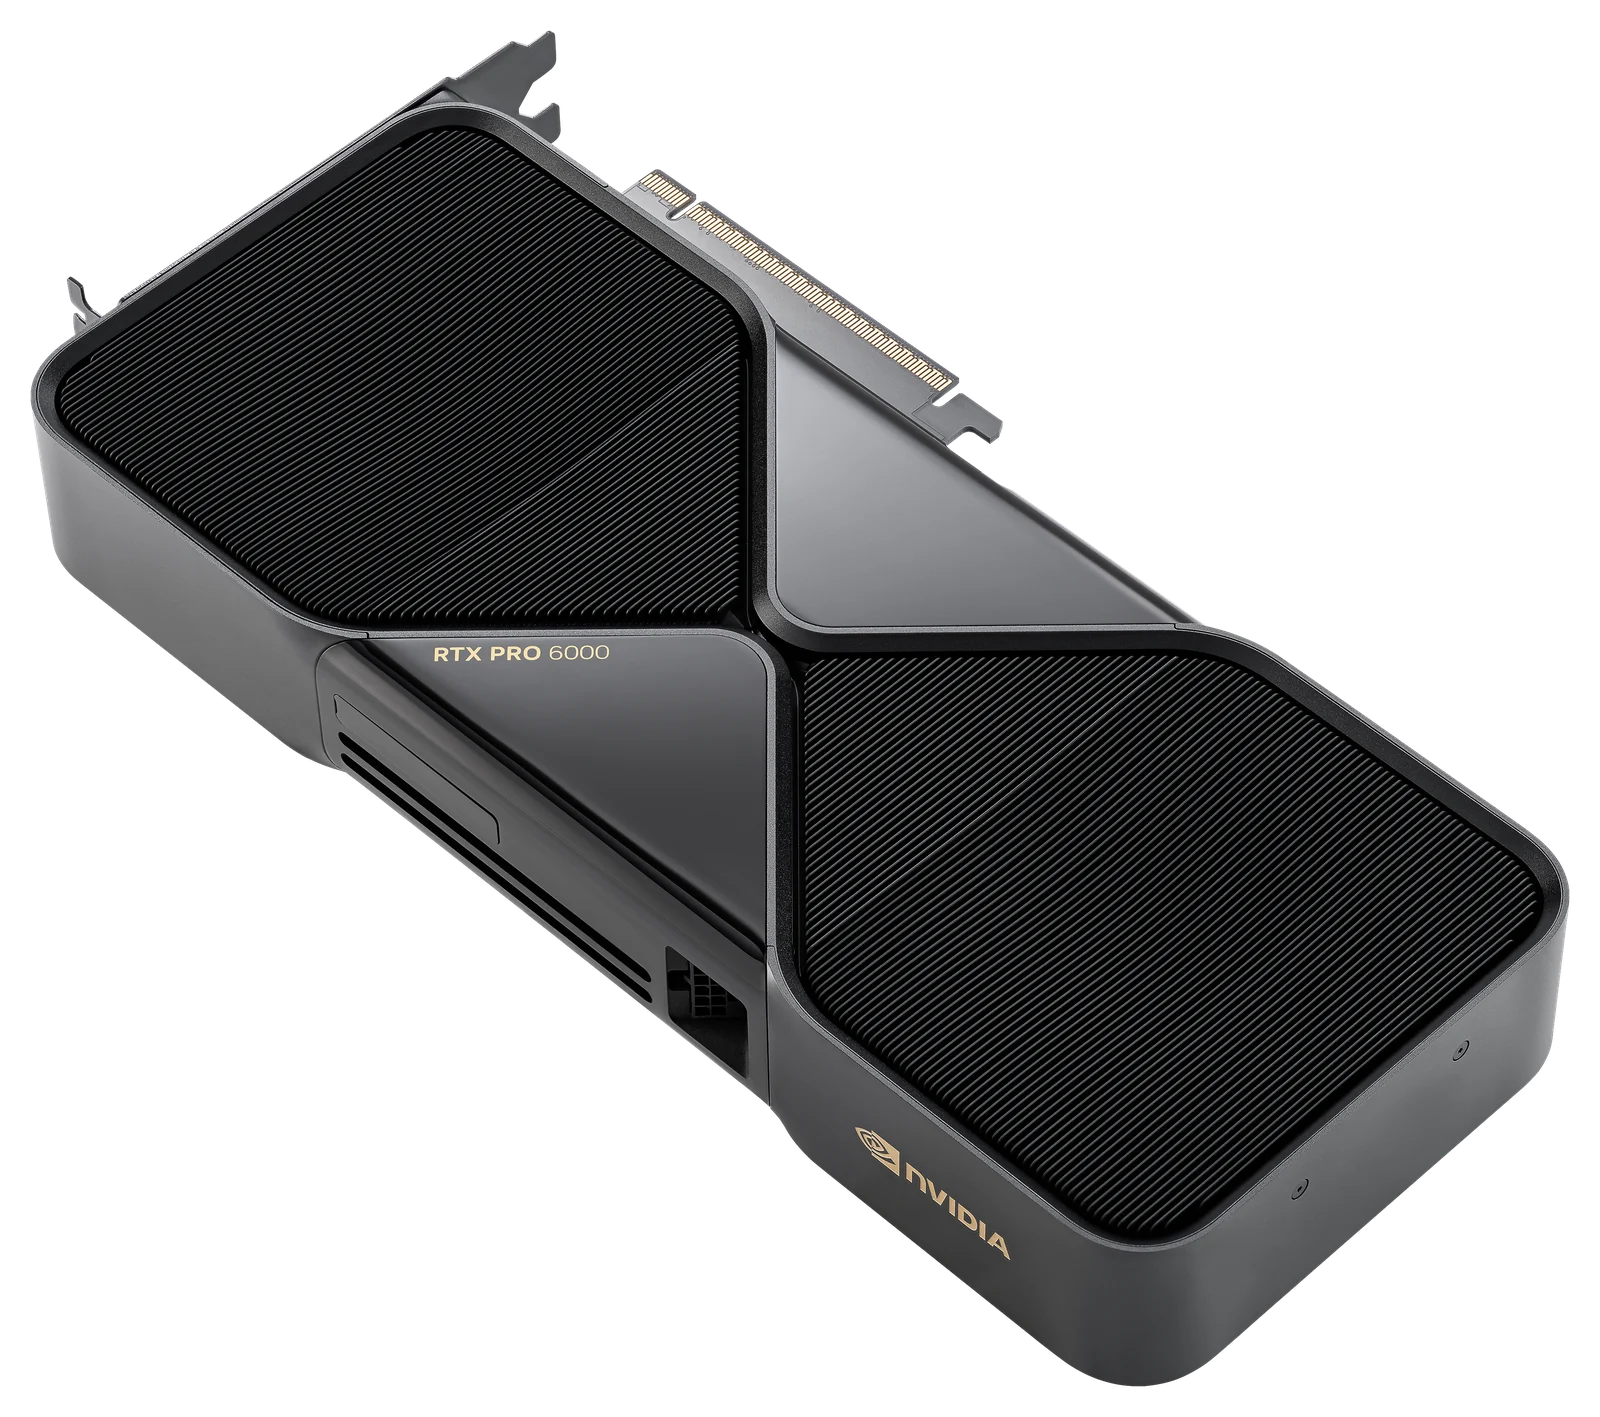
RTX PRO 6000 Blackwell даёт 96 ГБ памяти с ECC на одну карту. Этого хватает для Llama 3.3 70B в FP8 или gpt-oss-120b (около 61 ГБ весов в родном MXFP4) вместе с кешем на несколько диалогов. Через MIG карту можно разделить максимум на четыре изолированных экземпляра, например под разные небольшие модели или команды. Две карты помещаются в рабочую станцию или обычный сервер.
Компания: сервер на восемь GPU
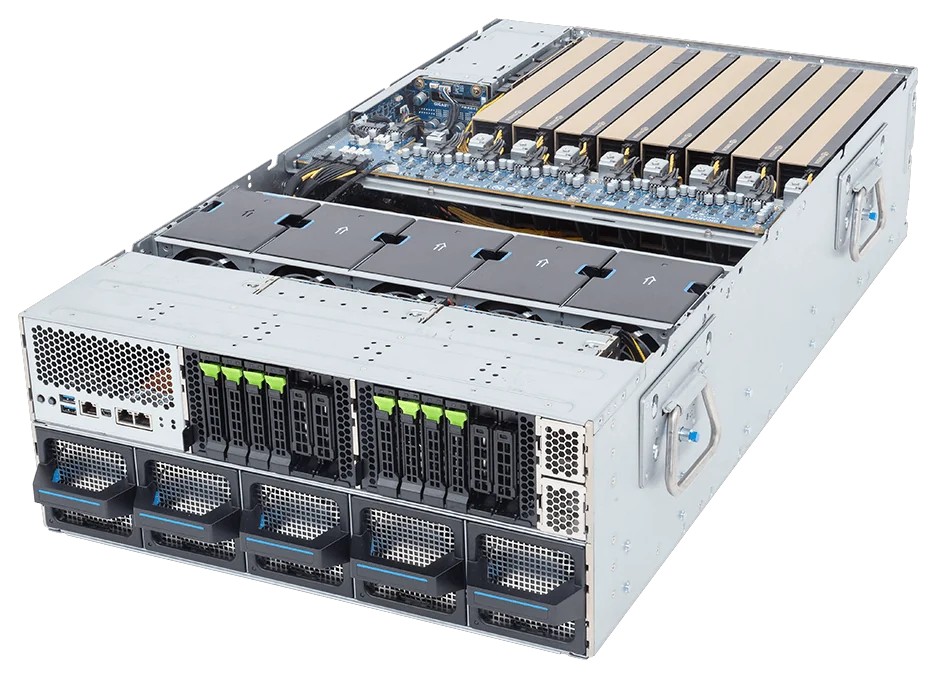
Gigabyte XL44-SX2 несёт восемь RTX PRO 6000 Server Edition и 768 ГБ памяти GPU в корпусе 4U. Этого достаточно для Qwen3 235B-A22B в FP8 (около 235 ГБ весов) с большим запасом под пользователей или для нескольких моделей сразу: основной LLM, модели эмбеддингов, распознавания речи. Карты связаны через PCIe, а не NVLink: для инференса это приемлемо, для обучения крупных моделей уже ограничение.
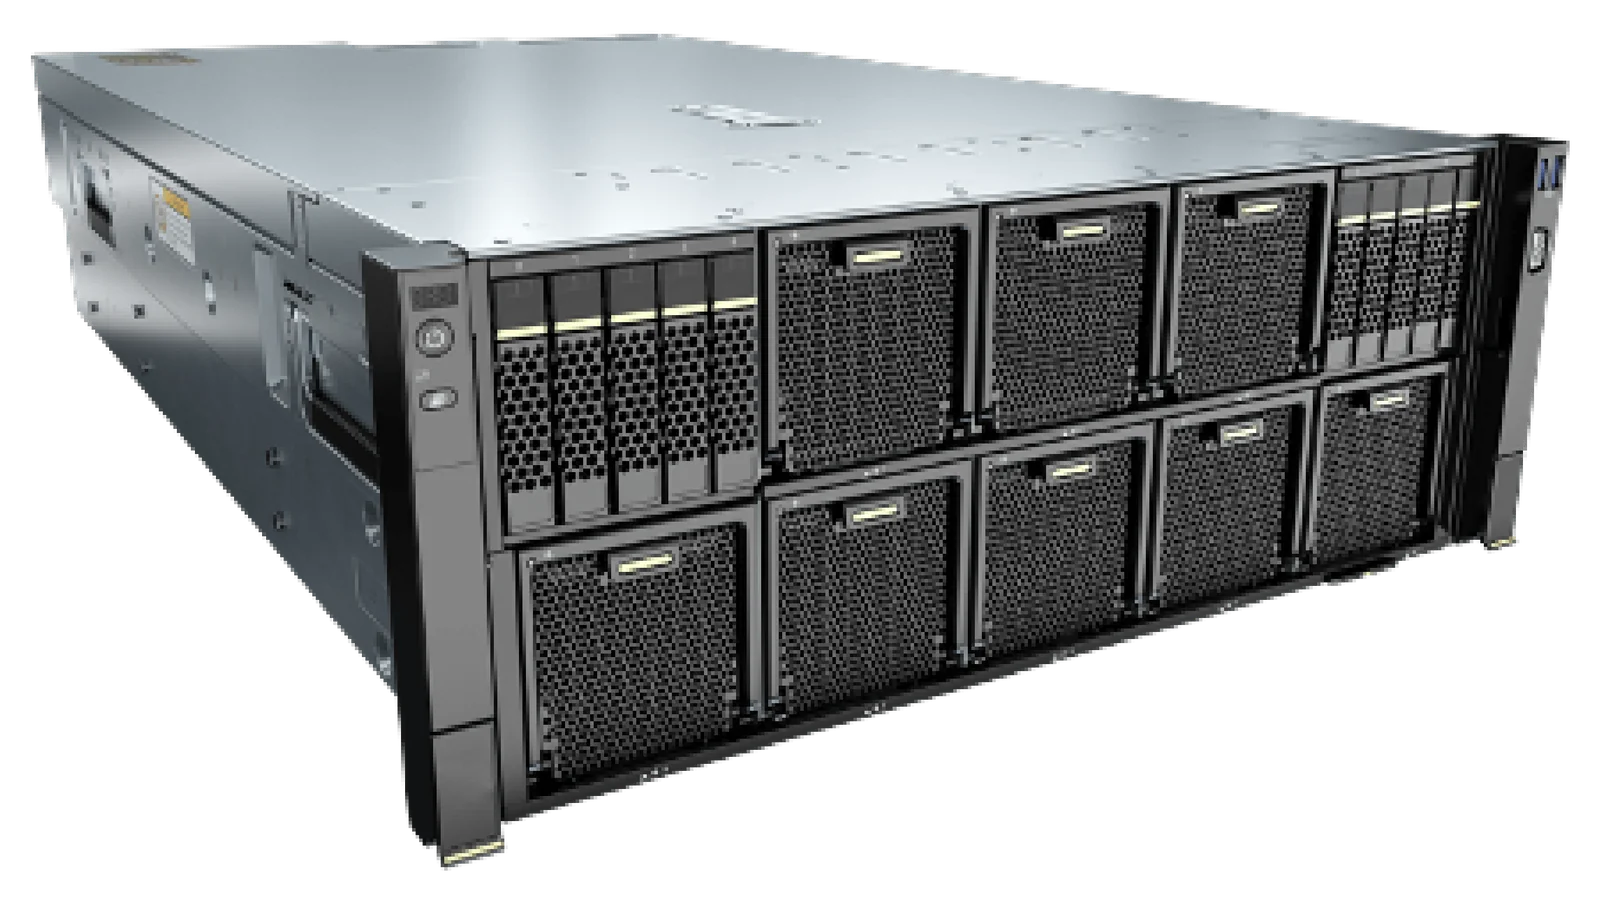
Huawei Atlas 800I A2 решает ту же задачу на стеке Huawei: восемь Ascend 910B по 64 ГБ HBM (всего 512 ГБ), связь между NPU по схеме full-mesh на 392 ГБ/с, четыре процессора Kunpeng 920. Модели запускают через MindIE или vLLM Ascend, в каталоге сервер указан для моделей до 235B.
Крупный сервис: восемь H200
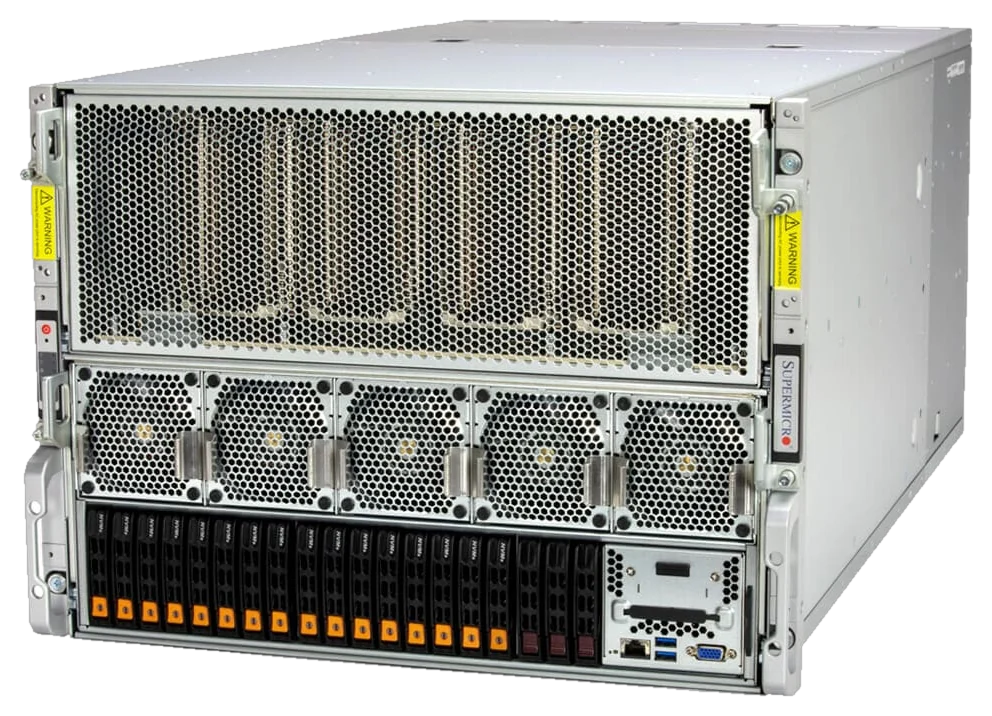
Supermicro SYS-821GE-TNHR построен на той же платформе HGX H200, что и DGX H200: восемь GPU по 141 ГБ, всего 1 128 ГБ, NVLink 900 ГБ/с на GPU. Сюда помещается DeepSeek V3 или R1 в родном FP8 (около 700 ГБ) с запасом под кеш, а быстрая связь между GPU позволяет эффективно делить одну модель на все восемь карт.
Скорость у таких моделей выше, чем можно ожидать от их размера. У MoE на каждый токен читаются только активные параметры, у DeepSeek это 37B из 671B, поэтому модель генерирует быстрее плотной модели того же объёма.
Процессор, оперативная память, диски и сеть
Для инференса главное GPU, но остальные компоненты не должны его тормозить.
- Процессор. Генерация его почти не нагружает, но CPU принимает запросы, токенизирует текст, разбирает документы для поиска. Процессоров в серверах каталога для этого хватает: в Gigabyte XL44-SX2 стоят два Intel Xeon 6, в Atlas 800I A2 четыре Kunpeng 920.
- Оперативная память. Удобный ориентир: не меньше суммарной памяти GPU, чтобы быстро загружать и переключать модели. В DGX H200, например, 2 ТБ ОЗУ при 1 128 ГБ памяти GPU, а в сервер Supermicro на HGX H200 можно поставить до 8 ТБ.
- Диски. Веса крупных моделей занимают сотни гигабайт, а хранить обычно нужно несколько версий и моделей. Берите быстрые NVMe: в Gigabyte XL44-SX2 восемь накопителей NVMe Gen5.
- Сеть. Одному серверу инференса хватит обычной сети: текстовые запросы и ответы весят мало. Быстрые порты нужны, если вы объединяете серверы под одну модель или планируете расширение. В Gigabyte XL44-SX2 уже стоит ConnectX-8 с 8 × 400 Гбит/с, в Atlas 800I A2 восемь портов 200GE RoCE.
Софт: как развернуть нейросеть на своём сервере
Сервер без движка инференса остаётся просто железом. Движок выбирают по сценарию:
- Ollama и llama.cpp. Простой запуск моделей в формате GGUF, удобно для пилота и одного пользователя.
- vLLM. Стандарт для многопользовательского сервиса. PagedAttention выделяет память под кеш по мере роста диалога, непрерывный батчинг объединяет запросы разных пользователей, есть OpenAI-совместимый API.
- SGLang. Переиспользует общий префикс запросов (RadixAttention), это полезно, когда у всех запросов один длинный системный промпт. Сильная поддержка DeepSeek.
- TensorRT-LLM. Максимум скорости на NVIDIA, но сложнее в настройке.
- На Huawei: MindIE и vLLM Ascend.
OpenAI-совместимый API означает, что приложения, написанные под API OpenAI, переключаются на ваш сервер сменой адреса и ключа. Корпоративный чат, внутренние боты и многие плагины для разработчиков продолжают работать, а данные не покидают контур. Чем движки отличаются и что выбрать, мы разобрали в статье «vLLM, Ollama или SGLang».
Коротко
- Сервер для LLM считают от модели и числа одновременных запросов, а не от численности компании.
- Память: веса + KV-кеш на каждый одновременный диалог + 10–20% служебного + 30–50% запаса на рост.
- Отдел: одна-две RTX PRO 6000. Компания: восемь GPU и 512–768 ГБ. Крупный сервис: восемь H200 и 1 128 ГБ.
- Для многопользовательского сервиса берите vLLM или SGLang с OpenAI-совместимым API, на Huawei MindIE или vLLM Ascend.
Пришлите модель, число пользователей и типичный объём документов, и мы рассчитаем конфигурацию на NVIDIA или Huawei: оставьте заявку, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
Gigabyte
Gigabyte XL44-SX2
Восемь RTX PRO 6000 в одном сервере: 768 ГБ памяти GPU.
- RTX PRO 6000
- 8GPU
- Память GPU
- 768ГБ
- Высота
- 4U
Цена по запросу
Supermicro
Supermicro SYS-821GE-TNHR
Сервер на HGX H200: те же 8 GPU, что в DGX H200.
- H200 SXM
- 8GPU
- Память GPU
- 1128ГБ
- Высота
- 8U
Цена по запросу
Huawei
Atlas 800I A2
Сервер инференса на восьми Ascend 910B.
- Ascend 910B
- 8NPU
- Память HBM
- 512ГБ
- FP16
- 2,24ПФЛОПС
Цена по запросу
Читайте также
Сколько видеопамяти нужно для LLM: расчёт для моделей от 8B до 671B
Простая формула, сколько видеопамяти нужно языковой модели: веса, KV-кеш и запас. Таблица для Qwen3, Llama 70B, gpt-oss и DeepSeek и подбор GPU под объём.
vLLM, Ollama или SGLang: чем запускать LLM на сервере
vLLM или Ollama, SGLang или TensorRT-LLM: чем отличаются движки для запуска LLM, что выбрать для сервиса на компанию и как движок влияет на выбор GPU.
Аренда GPU-сервера или свой сервер: что выгоднее для компании
Аренда GPU-сервера или покупка своего: формула сравнения, точка безубыточности по загрузке, скрытые расходы, данные и доступность GPU. Когда выгоден гибрид.