Инфраструктура
InfiniBand или Ethernet: какая сеть нужна для GPU-кластера
InfiniBand или Ethernet с RoCE для GPU-кластера: когда сеть между серверами критична, чем отличаются технологии и что заложить при покупке первого сервера.
Содержание
Вопрос «InfiniBand или Ethernet» встаёт, когда GPU-серверов несколько и они работают над одной задачей: обучают модель или вместе держат модель, которая не помещается в один узел. В таком кластере обычно ставят по сетевому порту 400 Гбит/с на каждый GPU, и обе технологии её обеспечивают: у InfiniBand NDR это 400 Гбит/с на порт, у XDR 800 Гбит/с, Ethernet с RoCE работает на тех же скоростях. Разница не в цифре на порту, а в том, как сеть ведёт себя под нагрузкой и сколько сил уходит на её настройку. Одному серверу инференса специальная сеть не нужна вовсе.
Когда сеть между серверами важна, а когда нет
Внутри сервера на 8 GPU все карты связаны NVLink, и обмен между ними не выходит за пределы корпуса. Если модель помещается в один сервер, внешняя сеть нужна только для запросов пользователей и загрузки данных. Например, DGX H200 с 1 128 ГБ памяти GPU держит DeepSeek 671B в родном FP8 целиком, а запросы к нему весят килобайты.
Сеть становится частью вычислений в двух случаях:
- Обучение на нескольких серверах. На каждом шаге GPU обмениваются градиентами, а их объём сравним с размером модели: у модели 70B в BF16 это около 140 ГБ. Медленная сеть означает, что дорогие GPU простаивают в ожидании обмена.
- Модель не помещается в один узел. Kimi K2 с 1T параметров в FP8 занимает около 1 ТБ только под веса. В 1 128 ГБ сервера на восьми H200 не останется места под кеш и служебные буферы, поэтому модель разносят на два узла или берут систему с большей памятью, например DGX B300 с 2,1 ТБ.
А вот несколько серверов инференса, каждый со своей копией модели, кластером в сетевом смысле не являются. Запросы между ними распределяет балансировщик, а друг с другом серверы почти не общаются. Здесь хватит обычной сети дата-центра. Остальные требования обучения к железу мы разобрали в статье о сервере для обучения нейросетей.
NVLink внутри сервера и сеть между серверами
Сеть не заменяет NVLink. Она связывает между собой «острова» NVLink, и разница в скорости между ними большая:
| Связь | Где работает | Скорость на GPU |
|---|---|---|
| PCIe 5.0 x16 | GPU с процессором и сетевой картой | около 64 ГБ/с в каждую сторону |
| NVLink 4 (Hopper) | между GPU внутри сервера H200 | 900 ГБ/с |
| NVLink 5 (Blackwell) | между GPU внутри сервера B200 | 1,8 ТБ/с |
| Сетевой порт 400 Гбит/с | между серверами | около 50 ГБ/с |
| Сетевой порт 800 Гбит/с | между серверами | около 100 ГБ/с |
NVIDIA указывает для NVLink суммарную скорость в обе стороны, но даже с поправкой на это связь между серверами медленнее в 9–18 раз, то есть примерно на порядок. В DGX B200 восемь GPU связаны NVLink 5 с суммарной пропускной способностью 14,4 ТБ/с, и ни одна сеть между серверами к таким цифрам не приближается.
Поэтому задачу делят так, чтобы самый интенсивный обмен оставался внутри сервера. Тензорный параллелизм, когда каждый слой модели делится между GPU, держат в пределах NVLink. Между серверами модель делят по слоям (конвейерный параллелизм) или копируют целиком и обмениваются только градиентами (параллелизм по данным). От сети требуется не догнать NVLink, а не тормозить эти обмены.
InfiniBand или Ethernet с RoCE: в чём разница
Обе технологии поддерживают RDMA: один сервер пишет данные прямо в память другого, не отвлекая его процессор. Отличаются они устройством и тем, как их обслуживать.
InfiniBand
InfiniBand изначально создавали для суперкомпьютеров. Сеть работает без потерь по своему устройству: отправитель передаёт данные, только когда у получателя есть свободный буфер. Маршруты строит менеджер подсети, вручную настраивать управление перегрузкой не нужно. Коммутаторы NVIDIA Quantum умеют выполнять часть операций сведения данных прямо в сети (технология SHARP), что сокращает трафик при обмене градиентами.
Минус в том, что это отдельный мир: свои коммутаторы, свои инструменты, нужны свои специалисты. К остальной сети компании серверы подключают отдельными Ethernet-портами.
Ethernet с RoCE
RoCE (RDMA over Converged Ethernet) переносит тот же механизм RDMA на Ethernet. Плюсы понятны: технология знакома сетевым инженерам, коммутаторы можно выбирать у разных производителей, сеть кластера легко связать с остальным дата-центром.
Сложность в том, что классический Ethernet при перегрузке отбрасывает пакеты, а RDMA к потерям очень чувствителен. Чтобы RoCE работал стабильно, на коммутаторах и картах настраивают управление потоком и перегрузкой (PFC, ECN). Хорошо настроенная сеть работает ровно, настроенная кое-как даёт просадки скорости, которые трудно отловить.
На RoCE построены и серверы Huawei: у Atlas 800T A2 восемь портов 200GE RoCE для объединения в кластер, у Atlas 800T A3 восемь портов 400GE.
Spectrum-X
Spectrum-X это платформа NVIDIA для ИИ-нагрузки на Ethernet: коммутаторы Spectrum работают в паре с сетевыми картами SuperNIC и вместе распределяют трафик по маршрутам и управляют перегрузкой. Идея в том, чтобы получить предсказуемость, близкую к InfiniBand, и при этом остаться в Ethernet.
| InfiniBand | Ethernet с RoCE | Spectrum-X | |
|---|---|---|---|
| Скорость порта | NDR 400 Гбит/с, XDR 800 Гбит/с | 400 и 800 Гбит/с | 400 и 800 Гбит/с |
| Потери пакетов | нет по устройству сети | нужна настройка PFC и ECN | управление перегрузкой в связке коммутатора и карты |
| RDMA и GPUDirect | да | да | да |
| Коммутаторы | NVIDIA Quantum | разных производителей | NVIDIA Spectrum |
| Связь с остальной сетью | отдельная фабрика | общая сеть с дата-центром | общая сеть с дата-центром |
| Обслуживание | нужны специалисты по InfiniBand | привычно сетевым инженерам | Ethernet со своей спецификой |
| Где чаще встречается | крупные обучающие кластеры | инференс, смешанные дата-центры, Huawei Atlas | крупные ИИ-кластеры на Ethernet |
Если коротко: InfiniBand для ИИ выбирают, когда важнее всего предсказуемая скорость обучения на многих узлах, а Ethernet, когда важнее совместимость с существующей сетью и опытом команды. У NVIDIA есть референсные архитектуры кластеров на обоих вариантах.
Порт на каждый GPU и отдельная сеть хранилища
В обучающем кластере каждому GPU обычно выделяют свой сетевой порт 400G. Так каждая карта обменивается данными с картами других серверов, не деля канал с соседями. В DGX H200 это восемь портов 400 Гбит/с ConnectX-7, в DGX B300 стоят карты ConnectX-8 со скоростью до 800 Гбит/с.
Порты собирают в вычислительную сеть по так называемой rail-схеме: первый порт каждого сервера идёт в один коммутатор, второй в другой и так далее. Тогда GPU с одинаковыми номерами в разных серверах связаны через один коммутатор, и большая часть трафика обходится без лишних переходов.
Кроме вычислительной, в кластере есть ещё две сети:
- сеть хранилища для датасетов, чекпоинтов и логов. Её отделяют, чтобы запись чекпоинта не мешала обмену градиентами;
- сеть управления и доступа: удалённое управление серверами, мониторинг, работа администраторов и пользователей.
Итого на сервер с восемью GPU приходится восемь портов в вычислительную сеть плюс порты для хранилища и управления. В серверах HGX под это предусмотрены слоты: в Supermicro SYS-A22GA-NBRT на HGX B200 десять слотов PCIe 5.0 x16 низкого профиля и два FHHL, так что карты можно поставить и под каждый GPU, и под хранилище.
GPUDirect RDMA: обмен без участия процессора
Без GPUDirect данные из памяти GPU сначала копируются в оперативную память сервера, и только потом сетевая карта отправляет их дальше. На приёмной стороне всё повторяется в обратном порядке. Лишние копии добавляют задержку и нагружают процессор.
GPUDirect RDMA позволяет сетевой карте читать и писать память GPU напрямую, минуя CPU. Его поддерживают и InfiniBand, и RoCE. Библиотека NCCL, через которую PyTorch и другие фреймворки обмениваются данными между GPU, использует GPUDirect автоматически, если железо и драйверы это позволяют.
Чтобы прямой путь был коротким, сетевую карту ставят рядом с её GPU, под один PCIe-коммутатор. В серверах DGX и HGX это заложено в конструкцию, а при сборке сервера на PCIe-картах расположение слотов стоит проверить. По тому же принципу работает GPUDirect Storage: данные с хранилища попадают в память GPU без промежуточной копии в оперативной памяти.
Что заложить при покупке первого сервера
Даже если сейчас сервер один, решения на этапе покупки определяют, насколько легко будет расширяться.
- Определите сценарий. Если это сервер инференса и модель в него помещается, переплачивать за вычислительную сеть не нужно. Если в планах обучение на нескольких узлах, сеть закладывайте сразу.
- Берите сервер с портом на каждый GPU или со слотами под них. DGX поставляется с сетью в комплекте, в HGX-сервере карты выбирают при заказе. Подробнее о разнице в статье DGX или HGX-сервер.
- Выберите тип сети до покупки коммутаторов. Сетевые карты ConnectX-7 и ConnectX-8 выпускаются в вариантах с поддержкой обоих протоколов, но коммутаторы, кабели и навыки команды у InfiniBand и Ethernet разные.
- Заложите отдельную сеть хранилища. Обучение на нескольких серверах может упереться и в скорость чтения данных, и в запись чекпоинтов.
- Посчитайте место и питание. Коммутаторам нужно место в стойке, а сами серверы потребляют много: DGX B200 до 14,3 кВт, DGX B300 около 14 кВт. Об этом в статье о питании и охлаждении GPU-сервера.
- После монтажа проверьте сеть тестами NCCL (nccl-tests). Они показывают, какую скорость обмена между GPU кластер даёт на самом деле, и сразу выявляют ошибки настройки.
Коротко
- Одному серверу инференса специальная сеть не нужна: GPU связаны NVLink внутри корпуса.
- Сеть для GPU-кластера важна при обучении на нескольких узлах и для моделей, которые не помещаются в один сервер. Типовая схема: порт 400 Гбит/с на каждый GPU плюс отдельная сеть хранилища.
- InfiniBand работает без потерь по устройству и проще выходит на стабильную скорость. Ethernet с RoCE или Spectrum-X легче вписать в существующую инфраструктуру, но его нужно тщательно настроить.
- GPUDirect RDMA есть в обоих вариантах и убирает лишние копии данных через процессор.
- При покупке первого сервера заложите порты или слоты под каждый GPU, даже если кластер появится позже.
Если вы планируете кластер или первый сервер с прицелом на расширение, мы подберём конфигурацию вместе с сетевыми картами под выбранный тип сети: оставьте заявку, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
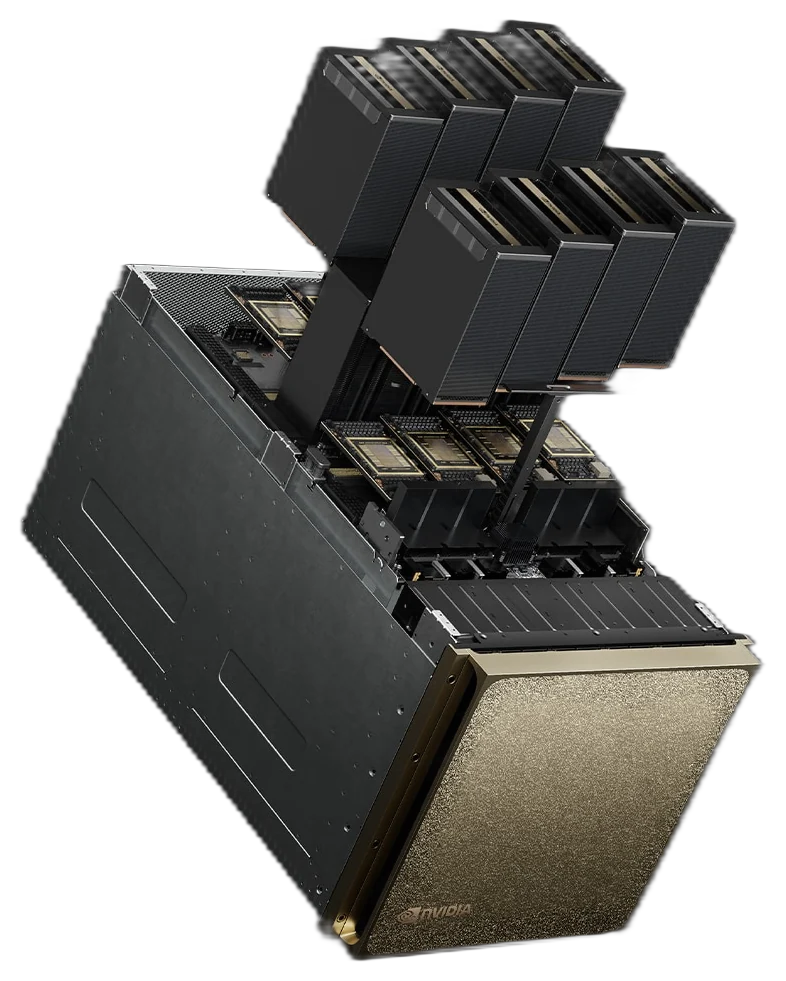
NVIDIA
DGX B200
Blackwell для обучения и инференса: 1,44 ТБ памяти GPU.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- FP4
- 144ПФЛОПС
Цена по запросу
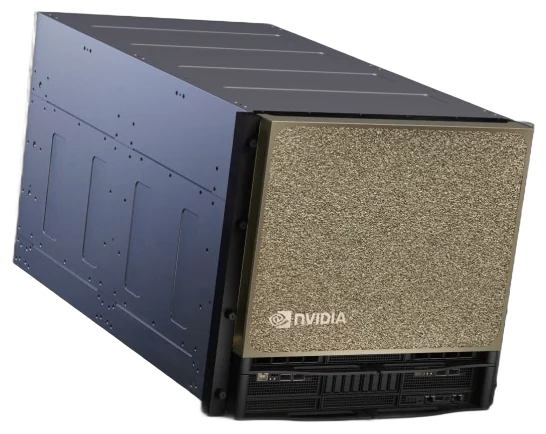
NVIDIA Флагман
DGX B300
Текущий флагман: Blackwell Ultra и 2,1 ТБ памяти GPU.
- Blackwell Ultra
- 8GPU
- Память GPU
- 2,1ТБ
- FP4
- 144ПФЛОПС
Цена по запросу
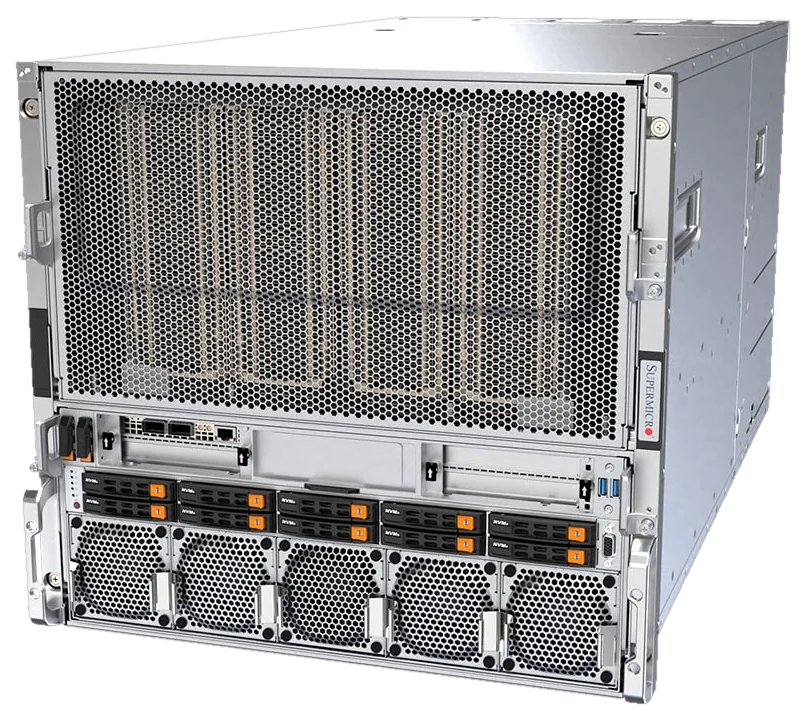
Supermicro
Supermicro SYS-A22GA-NBRT
Сервер на HGX B200: Blackwell без переплаты за бренд DGX.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- Высота
- 10U
Цена по запросу
Читайте также
Сервер для обучения нейросетей: что важно кроме GPU
Сервер для обучения нейросетей: сколько памяти GPU нужно на параметр, зачем NVLink и быстрая сеть, какое хранилище и питание заложить и когда хватит одной карты.
DGX или HGX: NVIDIA DGX или сервер Supermicro на тех же GPU
DGX или HGX: чем готовая система NVIDIA отличается от сервера Supermicro на той же плате с восемью GPU. Сравниваем DGX B200, DGX H200 и HGX-серверы, кому что подходит.
H200 vs B200: сравнение NVIDIA Hopper и Blackwell
H200 vs B200: память, скорость, FP4, NVLink 5 и потребление. Сравниваем DGX H200 и DGX B200 и объясняем, когда хватит Hopper, а когда нужен Blackwell.