Обзоры
RTX PRO 6000 Blackwell: обзор карты на 96 ГБ для ИИ
Обзор RTX PRO 6000 Blackwell: характеристики, версии Workstation, Max-Q и Server Edition, какие LLM помещаются в 96 ГБ и чем карта отличается от RTX 5090 и H200 NVL.
Содержание
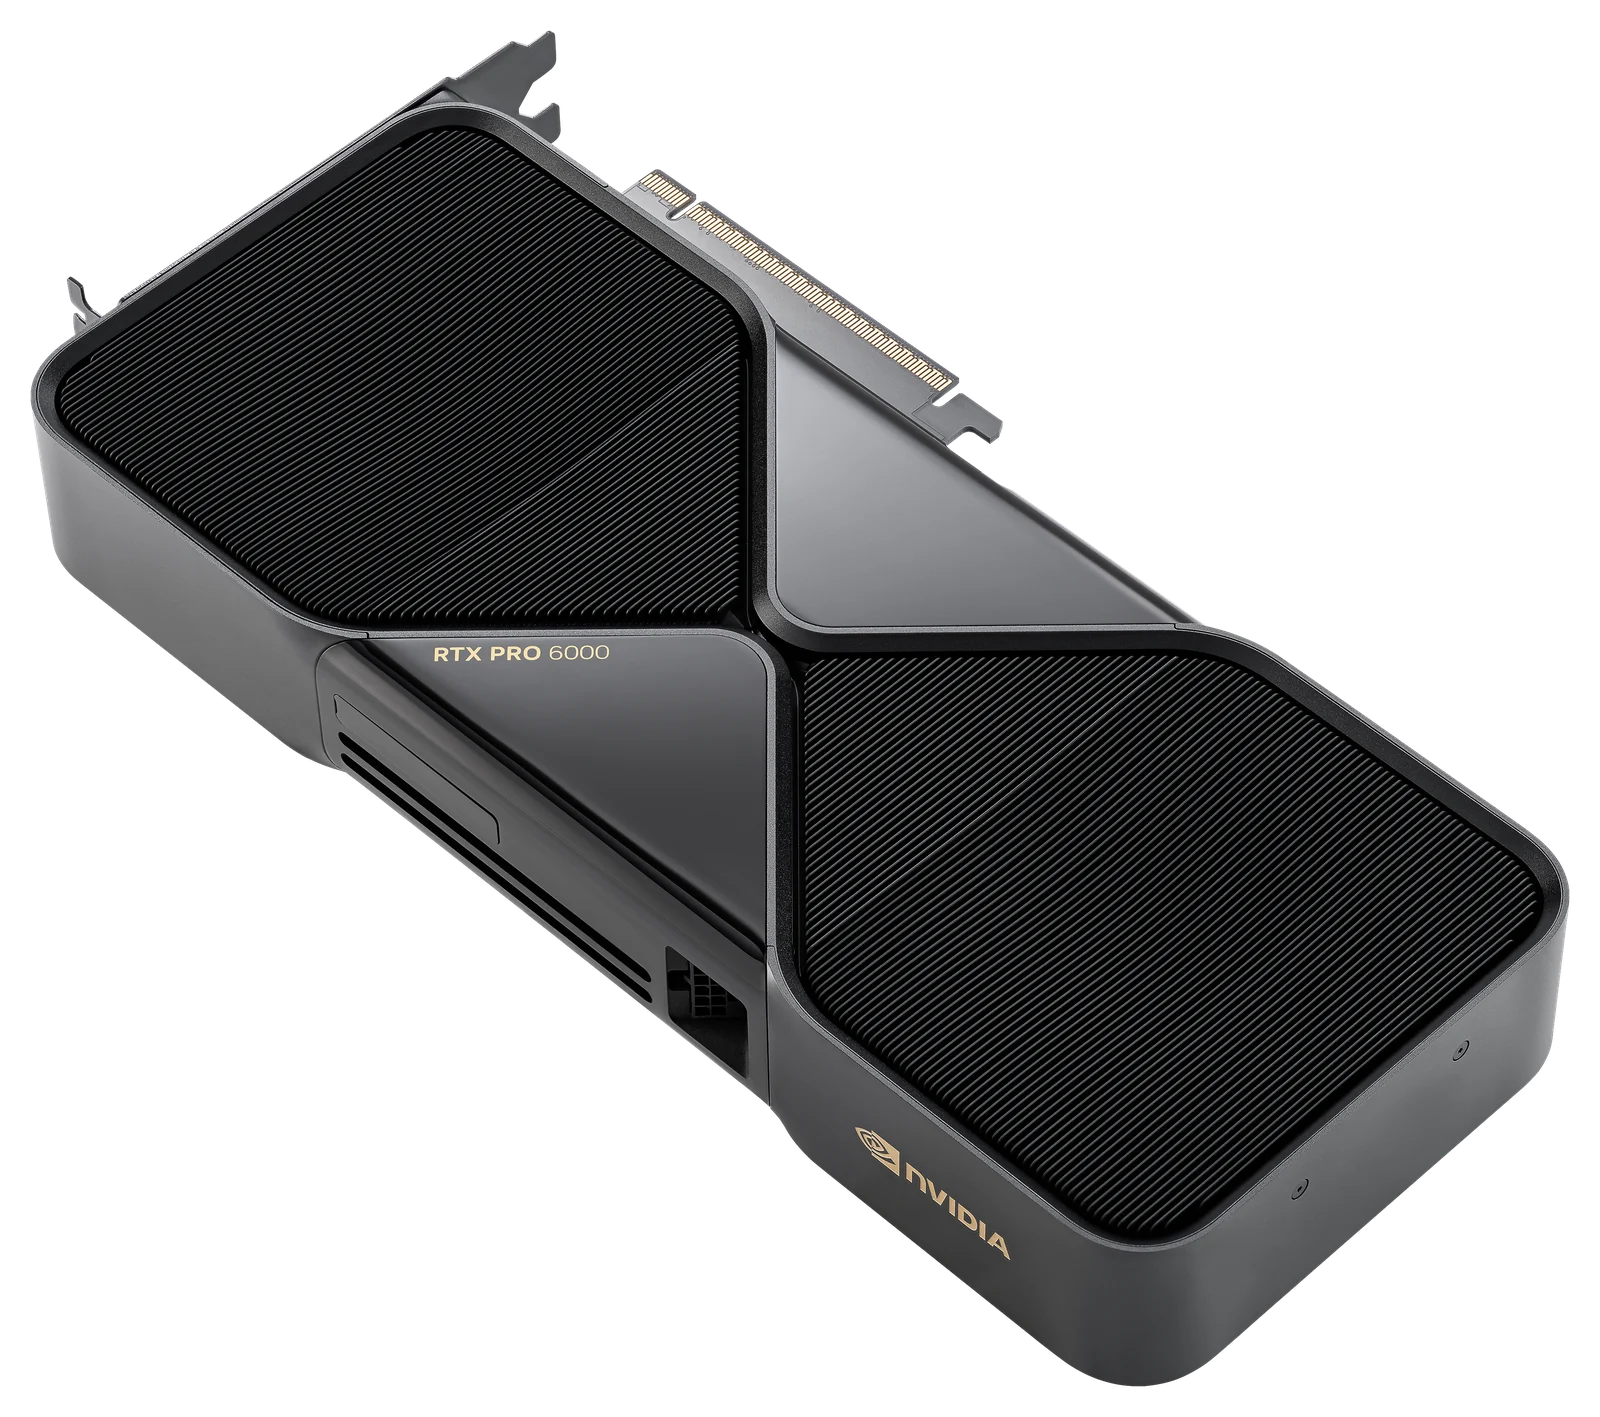
RTX PRO 6000 Blackwell это профессиональная карта NVIDIA с 96 ГБ памяти GDDR7 с ECC, пропускной способностью 1,79 ТБ/с и производительностью 4 000 TOPS в FP4. Она целиком вмещает Llama 3.3 70B в FP8 или gpt-oss-120b в родном формате MXFP4 и ставится в обычный слот PCIe 5.0. Главное в карте: модель класса 70–120B помещается в одну карту, которую можно поставить и в рабочую станцию, и в сервер. Ниже разбираем характеристики, три версии, что помещается в 96 ГБ и где у карты пределы.
Характеристики RTX PRO 6000 Blackwell
| Параметр | Значение |
|---|---|
| Архитектура | Blackwell |
| Память | 96 ГБ GDDR7 с ECC |
| Шина памяти | 512 бит |
| Пропускная способность | 1,79 ТБ/с |
| Ядра CUDA | 24 064 |
| ИИ-производительность | 4 000 TOPS (FP4) |
| Разделение GPU (MIG) | до 4 экземпляров |
| Интерфейс | PCIe 5.0 x16 |
| Энергопотребление | 600 Вт, у Max-Q 300 Вт |
| Версии | Workstation, Max-Q, Server Edition |
По сравнению с RTX 5090 на той же архитектуре у неё втрое больше памяти, та же скорость памяти и больше ядер CUDA: 24 064 против 21 760. ECC исправляет единичные ошибки в памяти, что важно для долгих задач вроде обучения и сервисов, которые работают круглосуточно. Как и другие карты Blackwell, RTX PRO 6000 аппаратно поддерживает FP8 и FP4 (NVFP4).
MIG: одна карта на несколько задач
MIG (Multi-Instance GPU) делит карту на изолированные части со своей памятью и вычислительными блоками. RTX PRO 6000 делится на четыре экземпляра, примерно по 24 ГБ каждый. Например, на одной карте одновременно работают модель эмбеддингов, небольшая LLM для отдела и среда для экспериментов, и они не мешают друг другу. Для сравнения: H200 NVL делится на семь экземпляров, а у RTX 5090 MIG нет.
Три версии: Workstation, Max-Q и Server Edition
Все три версии построены на одном чипе и несут 96 ГБ памяти. Различаются они охлаждением, потреблением и тем, куда их ставить.
| Версия | Потребление | Охлаждение | Куда ставить |
|---|---|---|---|
| Workstation | 600 Вт | собственные вентиляторы | рабочая станция с одной картой |
| Max-Q | 300 Вт | турбина, горячий воздух уходит наружу корпуса | рабочая станция с несколькими картами |
| Server Edition | до 600 Вт | пассивное, обдув вентиляторами сервера | GPU-сервер в стойке |
- Workstation даёт полную производительность, но 600 Вт на карту требуют мощного блока питания и хорошего продува корпуса. Две такие карты рядом заметно греют друг друга.
- Max-Q при вдвое меньшем потреблении сохраняет все 96 ГБ, а вычислительная производительность у неё ниже. Турбина выдувает воздух через заднюю панель, поэтому несколько карт можно ставить вплотную. Для инференса LLM это разумный компромисс: генерация текста упирается прежде всего в память, а не в вычисления, и память у Max-Q та же.
- Server Edition не имеет своих вентиляторов, её охлаждает поток воздуха серверного корпуса. Именно такие карты стоят в серверах на восемь GPU.
Что помещается в 96 ГБ: RTX PRO 6000 для LLM
Объём весов считается просто: число параметров × байт на параметр. Сверху нужно место под KV-кеш и 10–20% служебного.
| Модель | Формат | Веса | Одна карта на 96 ГБ |
|---|---|---|---|
| Qwen3 32B | BF16 | 64 ГБ | да, с запасом под контекст |
| Qwen3 30B-A3B | BF16 | ~60 ГБ | да, отвечает быстро: 3B активных |
| Llama 3.3 70B | FP8 | ~70 ГБ | да, кеш на 1–2 длинных диалога |
| Llama 3.3 70B | BF16 | 140 ГБ | нет, нужны две карты |
| gpt-oss-120b | MXFP4 | ~61 ГБ | да, с запасом под контекст |
| Llama 4 Scout | 4 бита | ~55 ГБ | да |
| GLM-4.5-Air | 4 бита | ~53 ГБ | да |
| Qwen3 235B-A22B | 4 бита | ~125 ГБ | нет, нужны две карты |
| DeepSeek V3 / R1 | 4 бита | ~380 ГБ | нет, нужен сервер на 8 карт |
| FLUX.1 [dev] | BF16 | 24 ГБ | да, остаётся место для энкодеров и LoRA |
Отдельно стоит сказать про модели MoE, такие как gpt-oss-120b и Qwen3 30B-A3B. В памяти лежат все веса, но на каждый токен читается только активная часть: 5,1B у gpt-oss-120b и 3B у Qwen3 30B-A3B. Поэтому на той же RTX PRO 6000 на 96 ГБ они отвечают в разы быстрее плотной 70B. Подробнее о запуске открытых моделей OpenAI читайте в статье о железе для gpt-oss.
Восемь карт в одном сервере
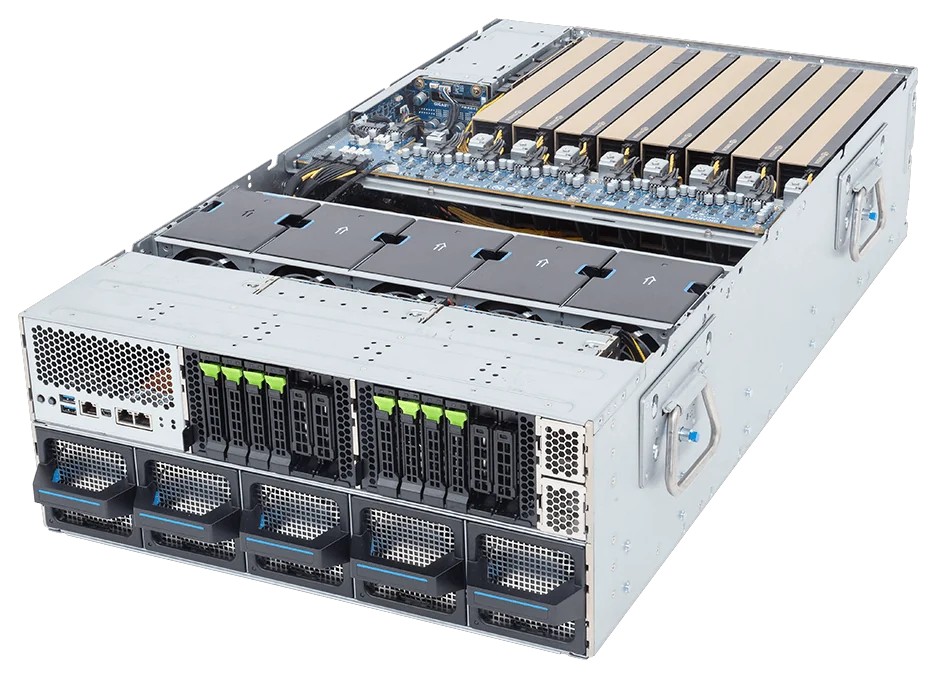
Gigabyte XL44-SX2 это сервер 4U на платформе NVIDIA MGX с восемью RTX PRO 6000 Server Edition:
- 768 ГБ GDDR7 с ECC суммарно;
- два процессора Intel Xeon 6, 32 слота DDR5, восемь накопителей NVMe Gen5;
- сеть ConnectX-8 SuperNIC 8 × 400 Гбит/с и BlueField-3;
- питание 4 × 3 200 Вт с резервированием.
В 768 ГБ помещаются Qwen3 235B в FP8, DeepSeek V3 и R1 в 4 битах и другие модели до 400B. Второй сценарий: несколько независимых копий модели 70B или 120B, по одной на карту, между которыми распределяются запросы сотрудников. Карты при этом не обмениваются данными, и отсутствие NVLink не мешает.
Один только набор карт потребляет до 4,8 кВт, и столько же тепла нужно отвести. Такой сервер ставят в серверную с подходящими линиями питания и охлаждением, а не в офис.
Ограничения: PCIe вместо NVLink и память не HBM
- Нет NVLink. Карты связываются через PCIe 5.0 x16, это около 64 ГБ/с в каждую сторону. NVLink-мост у H200 NVL даёт 900 ГБ/с, а NVLink 5 в системах на B200 1,8 ТБ/с на GPU. Когда модель режется на несколько RTX PRO 6000, обмен данными между картами замедляет ответ, а при обучении медленнее идёт синхронизация градиентов.
- Память GDDR7, а не HBM. 1,79 ТБ/с это много для карты PCIe, но у H200 NVL 4,8 ТБ/с. Генерация упирается в чтение весов, поэтому на одной и той же модели H200 NVL отвечает быстрее. Теоретический потолок для Llama 3.3 70B в FP8 (около 70 ГБ весов): примерно 25 токенов в секунду на диалог у RTX PRO 6000 и около 69 у H200 NVL. Реальная скорость ниже.
- Потребление. 600 Вт на карту у Workstation и Server Edition: станции нужен блок питания с запасом, а серверной продуманные питание и охлаждение.
Сравнение с RTX 5090 и H200 NVL
| Параметр | RTX 5090 | RTX PRO 6000 | H200 NVL |
|---|---|---|---|
| Архитектура | Blackwell | Blackwell | Hopper |
| Память | 32 ГБ GDDR7 | 96 ГБ GDDR7 с ECC | 141 ГБ HBM3e |
| Скорость памяти | 1,79 ТБ/с | 1,79 ТБ/с | 4,8 ТБ/с |
| ИИ-производительность | 3 352 TOPS (FP4) | 4 000 TOPS (FP4) | 3 341 TFLOPS (FP8) |
| Аппаратный FP4 | да | да | нет |
| MIG | нет | до 4 экземпляров | до 7 экземпляров |
| Связь между картами | PCIe 5.0 | PCIe 5.0 | NVLink-мост 900 ГБ/с на 2 или 4 карты |
| Потребление | 575 Вт | 600 Вт, у Max-Q 300 Вт | до 600 Вт |
Кому что подходит:
- RTX 5090: рабочее место разработчика, модели до 32B, генерация изображений. Лицензия драйвера GeForce не предусматривает установку в дата-центрах, для серверов NVIDIA предлагает профессиональные и серверные карты.
- RTX PRO 6000: модели 70–120B на одной карте, ECC, MIG и серверная версия. Разумный выбор по объёму памяти на карту для рабочих станций и серверов инференса.
- H200 NVL: когда важны скорость генерации и много пользователей, а также модель 70B в FP8 с большим запасом под контекст и связь карт через NVLink. Обойдётся заметно дороже.
Подробное сравнение двух карт Blackwell есть в статье RTX 5090 или RTX PRO 6000.
Коротко
- 96 ГБ GDDR7 с ECC, 1,79 ТБ/с, 24 064 ядра CUDA, 4 000 TOPS в FP4, PCIe 5.0.
- Три версии: Workstation на 600 Вт, Max-Q на 300 Вт для нескольких карт в станции и Server Edition для серверов.
- В одну карту помещаются Llama 3.3 70B в FP8, gpt-oss-120b и Qwen3 32B в BF16, восемь карт в сервере дают 768 ГБ.
- Ограничения: нет NVLink, память медленнее HBM. Для максимальной скорости и многих пользователей смотрите на H200 NVL.
Подберём версию RTX PRO 6000 под вашу задачу, от одной карты в рабочую станцию до сервера на восемь GPU: оставьте заявку, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
Gigabyte
Gigabyte XL44-SX2
Восемь RTX PRO 6000 в одном сервере: 768 ГБ памяти GPU.
- RTX PRO 6000
- 8GPU
- Память GPU
- 768ГБ
- Высота
- 4U
Цена по запросу
NVIDIA
GeForce RTX 5090
Самая мощная потребительская карта: модели до 32B, генерация изображений и видео.
- GDDR7
- 32ГБ
- ИИ, FP4
- 3352TOPS
- Потребление
- 575Вт
от 350 000 ₽
Читайте также
RTX 5090 vs RTX PRO 6000 Blackwell: что взять для ИИ
RTX 5090 vs RTX PRO 6000: одна архитектура и одинаковая скорость памяти, но 32 ГБ против 96 ГБ. Разбираем ECC, MIG, лицензию драйвера и кому какая карта подходит.
gpt-oss-120b и gpt-oss-20b: на каком железе запускать
Сколько памяти нужно gpt-oss-120b и gpt-oss-20b, открытым моделям OpenAI: веса в MXFP4, какие GPU подходят, сколько пользователей потянет карта и чем запускать.
Видеокарта для Stable Diffusion, Flux и Wan: изображения и видео
Видеокарта для Stable Diffusion, FLUX и Wan: сколько памяти занимают модели, когда хватит RTX 5090, зачем 96 ГБ, что дают FP8 и FP4 и как устроить студийную очередь.