Сравнения
Huawei Ascend или NVIDIA: что выбрать для ИИ в России
Huawei Ascend или NVIDIA для ИИ: сравниваем чипы 910B, 910C и 950PR с H200 по памяти и связи, софт CANN против CUDA и разбираем, кому какая платформа подходит.
Содержание
Huawei Ascend или NVIDIA: ответ зависит от задачи. Для инференса популярных открытых моделей Ascend подходит: сервер Atlas 800 A3 на восьми Ascend 910C несёт 1 ТБ памяти HBM, почти как 1 128 ГБ у DGX H200, и запускает DeepSeek и Qwen. Для обучения собственных моделей и исследований надёжнее NVIDIA: память у H200 быстрее, а под CUDA написана большая часть библиотек для машинного обучения. Ниже сравним железо, программный стек и сценарии.
Две платформы в двух словах
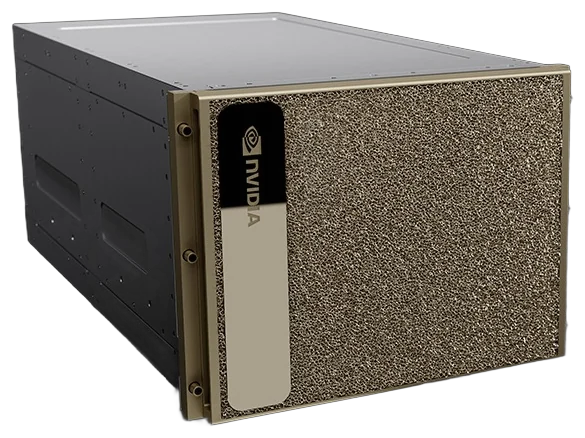
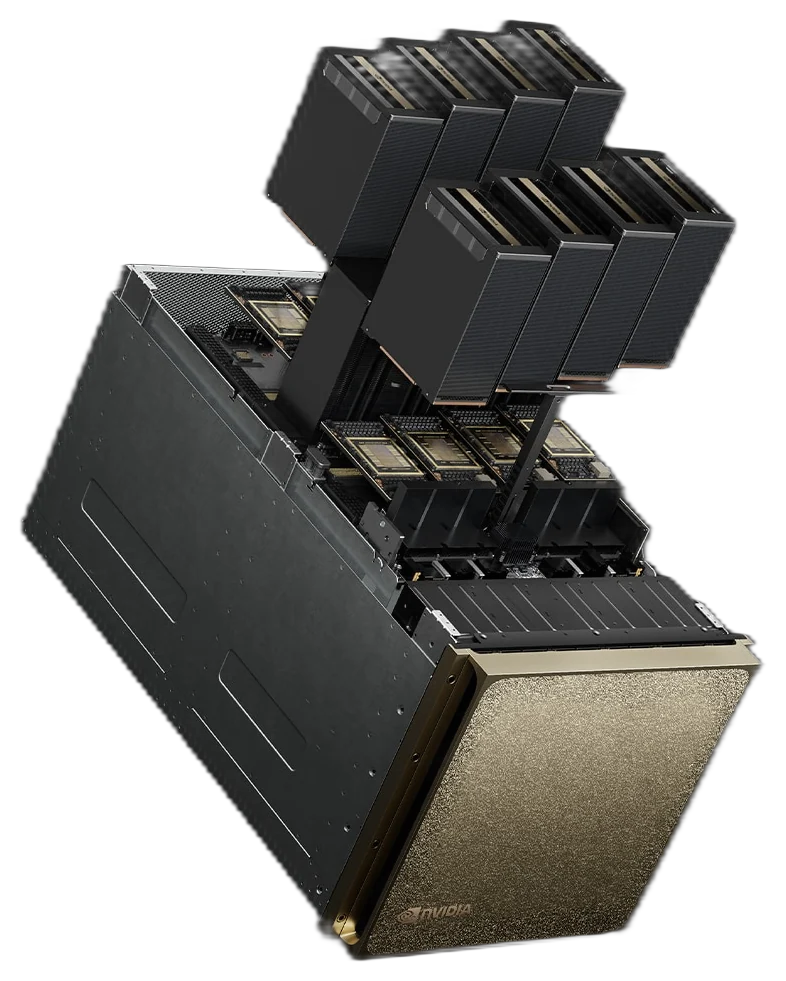
NVIDIA выпускает GPU и программную платформу CUDA, на которой построено большинство фреймворков для ИИ. В нашем каталоге это карты RTX и H200 NVL, системы DGX и серверы на платформе HGX.
Huawei выпускает NPU Ascend, специализированные процессоры для нейросетей, и собственный программный стек CANN. На их основе собраны карты и серверы Atlas. Названия 910B и 910C Huawei официально не публикует, но они общеприняты в отрасли, поэтому дальше мы указываем и чип, и модель сервера.
Если вы ищете альтернативу NVIDIA для ИИ, серверы Huawei Atlas в каталоге выглядят так:
- Atlas 800I A2 и 800T A2: восемь Huawei Ascend 910B, 512 ГБ HBM, высота 4U. Первый рассчитан на инференс, второй на обучение.
- Atlas 800T A3 / 800I A3: восемь Ascend 910C, 1 ТБ HBM, 10U. Текущий флагман Huawei.
- Atlas 350: карта PCIe на новом Ascend 950PR со 112 ГБ HBM, представлена в марте 2026 года. Доступность поставок уточняйте отдельно.
Железо: Ascend 910B, 910C и 950PR против H200
Сравним чипы Huawei с H200, который стоит в DGX H200 и серверах на HGX H200.
| Ascend 910B | Ascend 910C | Ascend 950PR | NVIDIA H200 | |
|---|---|---|---|---|
| Где стоит | Atlas 800I A2, 800T A2 | Atlas 800 A3 | Atlas 350 | DGX H200, HGX H200 |
| Память на чип | 64 ГБ HBM | 128 ГБ HBM | 112 ГБ HBM | 141 ГБ HBM3e |
| Скорость памяти | 1,6 ТБ/с | 3,2 ТБ/с | 1,4 ТБ/с | 4,8 ТБ/с |
| Связь между чипами | 392 ГБ/с | 784 ГБ/с | до 424 ГБ/с | 900 ГБ/с (NVLink) |
| FP4 | нет | нет | есть | нет |
| Память системы на 8 чипов | 512 ГБ | 1 ТБ | — | 1 128 ГБ |
| Высота системы | 4U | 10U | карта PCIe | 8U |
| Потребление системы | до 5,8 кВт (800T A2) | до 14,6 кВт | до 600 Вт на карту | до 10,2 кВт |
Скорость памяти 910B указана по карте Atlas 300I A2 на том же чипе с 64 ГБ. Связь между чипами для 910B и 910C взята из спецификаций серверов (у Huawei это шина HCCS), для 950PR это связь между картами.
Что видно из таблицы:
- По объёму памяти флагманы сопоставимы. И Atlas 800 A3, и DGX H200 вмещают DeepSeek V3 или R1 в 8-битном формате (около 700 ГБ) с запасом под кеш.
- По скорости памяти впереди H200. Теоретический потолок скорости генерации пропорционален ей: на одной и той же модели у H200 он в полтора раза выше, чем у 910C, и втрое выше, чем у 910B. Реальная скорость ниже и сильно зависит от софта.
- NVLink быстрее связи между чипами Ascend. Это важно, когда модель разрезана на восемь чипов, а для крупных моделей так всегда.
- FP4 у Huawei появился только в 950PR. У NVIDIA он есть в поколении Blackwell, но не в H200.
- Atlas 800 A3 занимает больше места и потребляет больше электричества, чем DGX H200: 10U и до 14,6 кВт против 8U и до 10,2 кВт.
Заявленную вычислительную мощность (до 6 ПФЛОПС FP16 у Atlas 800T A3, 32 ПФЛОПС FP8 у DGX H200) производители указывают в разных форматах и условиях, поэтому сравнивать эти числа напрямую некорректно. Тем более что инференс LLM чаще упирается в память, чем в вычисления.
Софт: CUDA против CANN
Железо сравнить просто. Решает обычно программный стек.
| Уровень | NVIDIA | Huawei Ascend |
|---|---|---|
| Базовая платформа | CUDA | CANN |
| PyTorch | работает напрямую | через адаптер torch_npu |
| Собственный фреймворк | — | MindSpore |
| Движки инференса | vLLM, SGLang, TensorRT-LLM, NIM | MindIE, vLLM Ascend |
| Открытые модели | практически все | популярные: DeepSeek, Qwen и другие |
| Библиотеки с кодом на CUDA | работают | нужен порт или замена |
У NVIDIA всё начинается с CUDA. Поверх неё работают PyTorch, движки vLLM и SGLang, собственный TensorRT-LLM, готовые микросервисы NIM и корпоративный пакет NVIDIA AI Enterprise. Новые модели и методы оптимизации, как правило, сразу выходят с поддержкой CUDA.
У Huawei роль CUDA выполняет CANN. Над ним работают:
- MindSpore, собственный фреймворк Huawei для обучения и инференса;
- PyTorch через адаптер torch_npu: обычный код на PyTorch переносится сравнительно просто, а всё, что опирается на расширения под CUDA, придётся переписывать;
- MindIE, движок инференса Huawei;
- vLLM Ascend, вариант vLLM для NPU Ascend с тем же OpenAI-совместимым API.
Что запускается без лишней работы
Популярные открытые модели, включая DeepSeek V3 и R1 и линейку Qwen3, работают на Ascend через MindIE и vLLM Ascend. Если ваша задача это корпоративный ассистент, поиск по базе знаний или обработка документов на такой модели, пользователи сервиса заметят разницу с NVIDIA в основном в скорости ответа, а не в возможностях. О запуске полной модели DeepSeek на разном железе мы писали в статье «Сервер для DeepSeek».
Где понадобится работа
- Собственный обучающий код. Скрипты на PyTorch часто переносятся, но свои CUDA-ядра, нестандартные слои и тонкие оптимизации придётся адаптировать и заново проверять.
- Нишевые библиотеки. Всё, что содержит код на CUDA, без отдельной версии для Ascend не заработает.
- Свежие архитектуры. Модель, вышедшая на прошлой неделе, может ещё не поддерживаться в MindIE или vLLM Ascend.
- Опыт команды. Инженеры обычно знают инструменты NVIDIA. На освоение CANN нужно время, а готовых ответов на типичные ошибки в сообществе меньше.
Перенос обучения на Ascend возможен, но это отдельный проект со своим бюджетом времени, а не замена драйвера.
Huawei Ascend или NVIDIA: кому что подходит
Когда выбирать Ascend
- Инференс открытых моделей вроде DeepSeek и Qwen без собственных изменений архитектуры.
- Корпоративный ассистент на крупной модели: Atlas 800I A2 с 512 ГБ рассчитан на модели до 235B, Atlas 800 A3 с 1 ТБ на полный DeepSeek 671B.
- Небольшой инференс и видеоаналитика: карта Atlas 300I Duo на 96 ГБ при 150 Вт, подробности в обзоре Atlas 300I Duo.
- Команда готова освоить стек Huawei или уже с ним работала.
Когда выбирать NVIDIA
- Обучение и дообучение собственных моделей, исследования, эксперименты с новыми архитектурами.
- Код и пайплайны уже написаны под CUDA, и их перенос не окупится.
- Нужна максимальная скорость генерации на пользователя: здесь решает скорость памяти, а у H200 она 4,8 ТБ/с.
- Нужны FP4 и максимальная плотность: поколение Blackwell, например DGX B200 с 1 440 ГБ памяти.
Обе платформы сразу
Платформы не исключают друг друга. Веса открытых моделей не привязаны к железу: модель можно дообучить на NVIDIA, а обслуживать на Ascend, если её архитектура поддерживается в MindIE или vLLM Ascend. Для многих компаний разумный вариант такой: исследования на NVIDIA, типовой инференс там, где удобнее по задаче и бюджету.
Как проверить совместимость до закупки
- Составьте список моделей, которые будете запускать, с точными версиями и форматами (BF16, INT8, 4 бита).
- Проверьте, поддерживает ли их MindIE или vLLM Ascend и в каких форматах.
- Перечислите библиотеки и движки в вашем коде. Отметьте те, что используют CUDA напрямую.
- Оцените нагрузку: сколько одновременных пользователей и какая длина контекста. От этого зависит, хватит ли 512 ГБ или нужен 1 ТБ.
- Если сомневаетесь, начните с одного сервера, проверьте на нём реальные сценарии и только потом масштабируйте.
Коротко
- Для инференса популярных открытых моделей Ascend рабочий вариант: Atlas 800 A3 даёт 1 ТБ памяти, Atlas 800I A2 512 ГБ.
- H200 быстрее по памяти (4,8 ТБ/с против 3,2 ТБ/с у 910C) и по связи между чипами.
- Главная разница в софте: CUDA остаётся стандартом отрасли, а CANN, MindIE и vLLM Ascend закрывают популярные сценарии, но перенос собственного кода требует работы.
- Обучение и исследования надёжнее вести на NVIDIA, инференс известных моделей можно строить на обеих платформах.
Если не уверены, какая платформа подойдёт под ваши модели, опишите задачу: оставьте заявку, и мы предложим конфигурации на NVIDIA и на Huawei. Цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
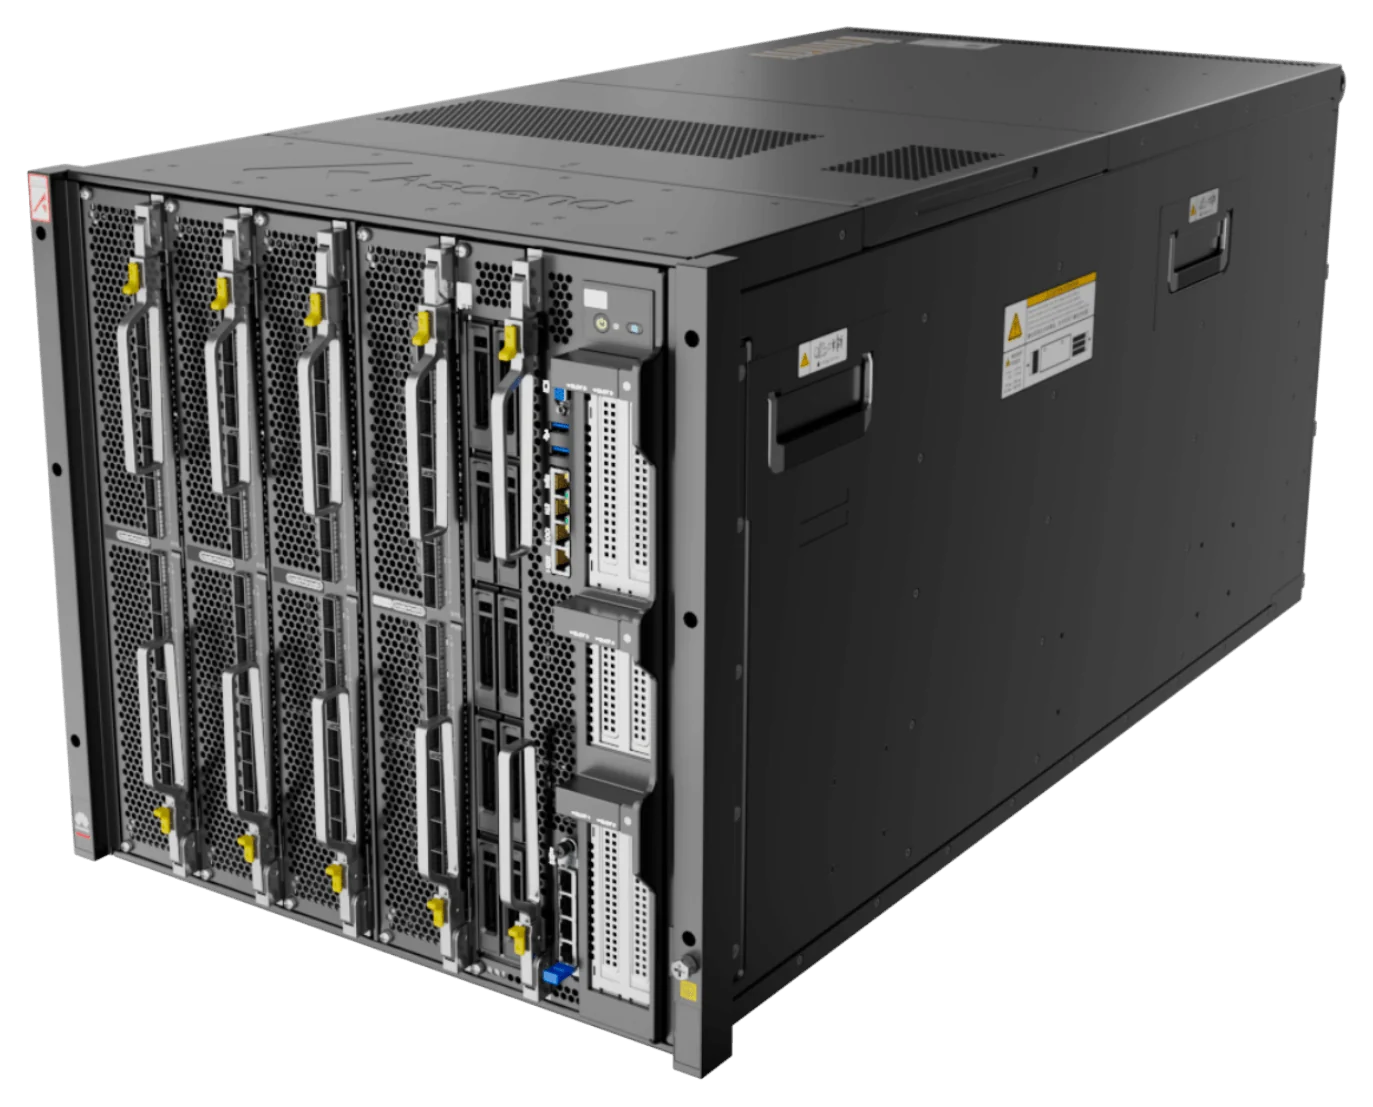
Huawei Флагман
Atlas 800T A3 / 800I A3
Текущий флагман Huawei: восемь Ascend 910C и 1 ТБ HBM.
- Ascend 910C
- 8NPU
- Память HBM
- 1ТБ
- FP16
- 6ПФЛОПС
Цена по запросу
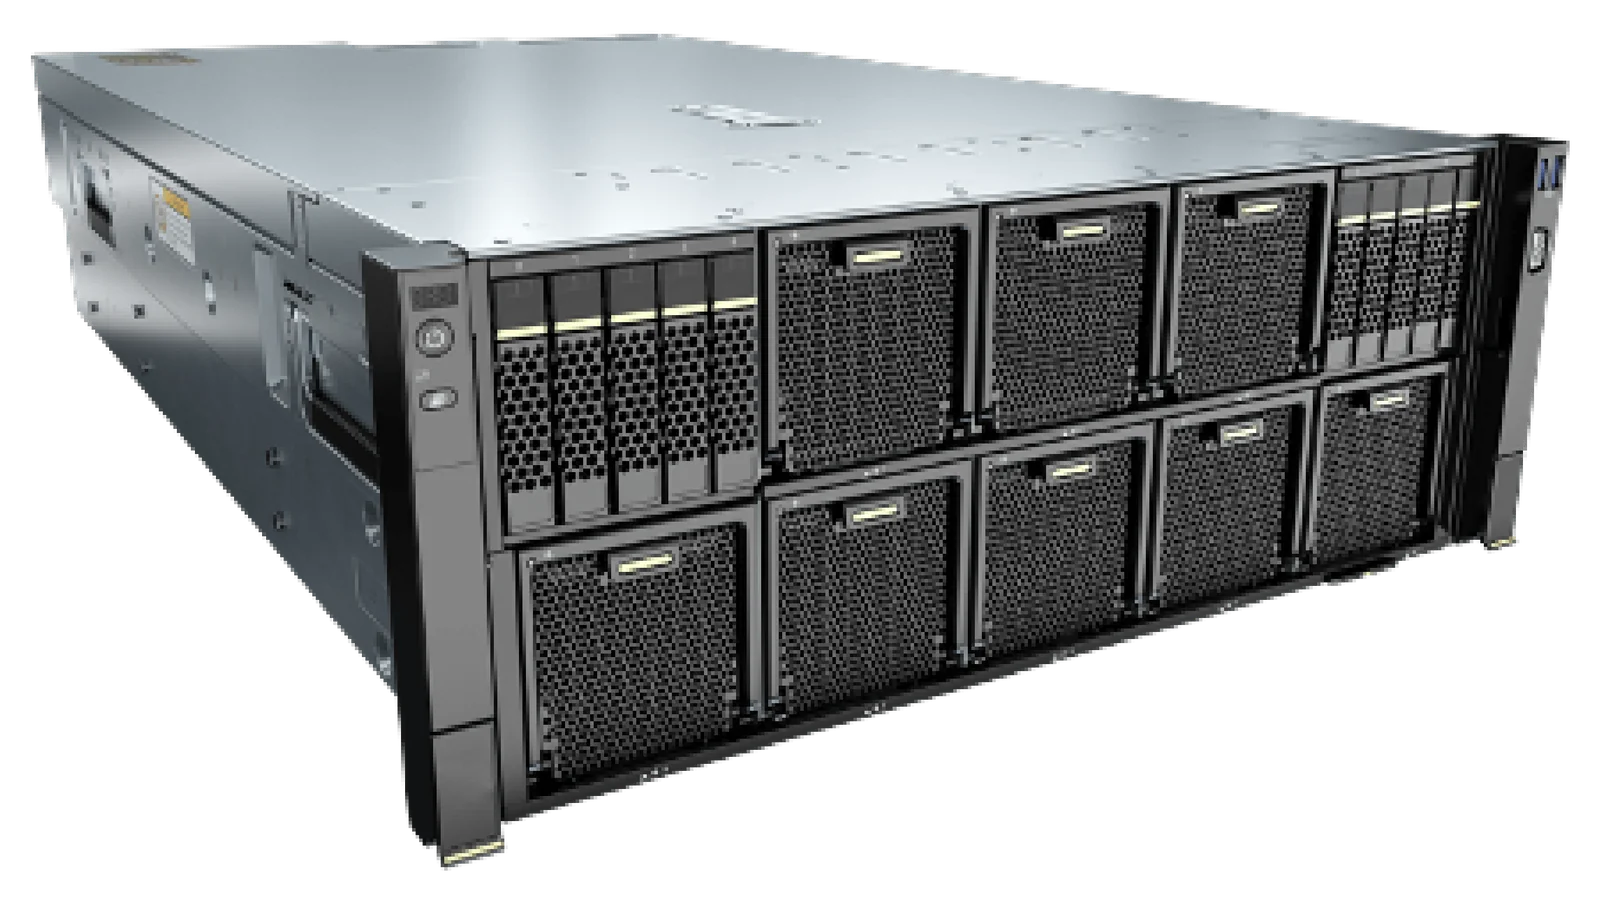
Huawei
Atlas 800I A2
Сервер инференса на восьми Ascend 910B.
- Ascend 910B
- 8NPU
- Память HBM
- 512ГБ
- FP16
- 2,24ПФЛОПС
Цена по запросу
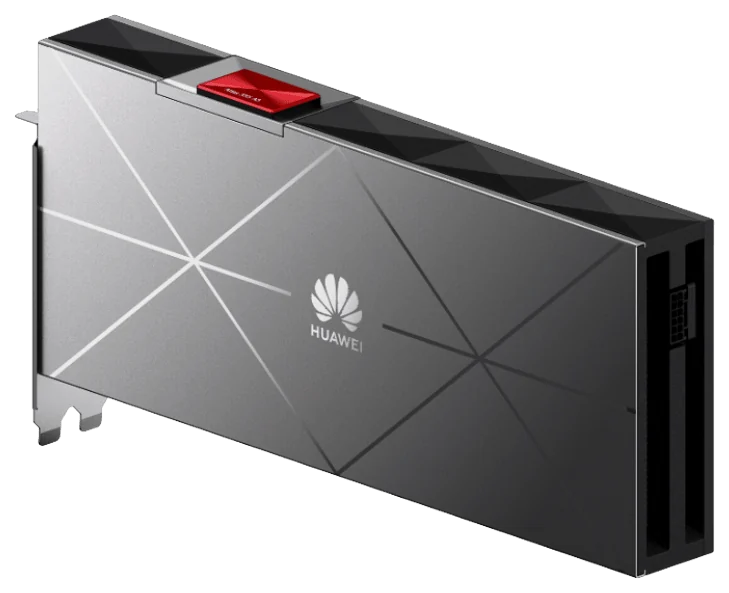
Huawei Новинка
Atlas 350
Новое поколение Ascend 950PR: 112 ГБ HBM и FP4.
- HBM
- 112ГБ
- FP4
- 1,56ПФЛОПС
- Потребление
- 600Вт
Цена по запросу
Читайте также
Huawei Atlas 300I Duo: обзор карты на 96 ГБ для инференса
Обзор Huawei Atlas 300I Duo: характеристики, два чипа Ascend 310P и 96 ГБ памяти при 150 Вт, какие LLM и задачи видеоаналитики потянет и чем уступает картам на HBM.
Сервер для DeepSeek V3 и R1: какое железо нужно для полной модели
Какой сервер для DeepSeek V3 и R1 нужен, чтобы запустить полную модель на 671B: сколько памяти занимают веса и варианты на H200, B200, Ascend и RTX PRO 6000.
DGX или HGX: NVIDIA DGX или сервер Supermicro на тех же GPU
DGX или HGX: чем готовая система NVIDIA отличается от сервера Supermicro на той же плате с восемью GPU. Сравниваем DGX B200, DGX H200 и HGX-серверы, кому что подходит.