Сравнения
NVIDIA H100 vs H200: в чём разница и что выбрать
H100 vs H200: один чип Hopper, но у H200 141 ГБ HBM3e вместо 80 ГБ и 4,8 ТБ/с вместо 3,35. Что это даёт в инференсе LLM, какие есть версии и что выбрать.
Содержание
В паре H100 vs H200 различается только память. Это один и тот же чип Hopper с одинаковой вычислительной мощностью, но у H200 141 ГБ HBM3e против 80 ГБ и скорость памяти 4,8 ТБ/с против 3,35 ТБ/с (если сравнивать SXM-версии). На практике это более крупная модель на одной карте, больше места под контекст пользователей и более быстрая генерация: по данным NVIDIA, в инференсе Llama 2 70B H200 быстрее H100 до 1,9 раза.
Один чип Hopper, разная память
H100 и H200 построены на одном кристалле архитектуры Hopper. Тензорные ядра, аппаратная поддержка FP8 и паспортная вычислительная мощность у SXM-версий одинаковые. Потребление тоже: обе карты в формате SXM рассчитаны на мощность до 700 Вт.
Вся разница в подсистеме памяти:
- Объём: 80 ГБ у H100 SXM против 141 ГБ у H200, то есть в 1,76 раза больше.
- Тип: HBM3 против HBM3e, следующего поколения памяти с более высокой скоростью.
- Пропускная способность: 3,35 ТБ/с против 4,8 ТБ/с, примерно на 43% выше.
Иными словами, NVIDIA взяла ту же вычислительную платформу и дала ей более ёмкую и быструю память. Поэтому H200 выигрывает там, где упор в память (инференс больших языковых моделей), и заметно меньше там, где упор в вычисления.
H100 vs H200: характеристики всех версий
У обоих ускорителей есть версии для серверов на восемь GPU (SXM) и карты для установки в обычный сервер через PCIe. Характеристики H200 и H100 по версиям:
| Версия | Память | Тип памяти | Скорость памяти | Потребление | Формат |
|---|---|---|---|---|---|
| H100 PCIe | 80 ГБ | HBM2e | 2 ТБ/с | 350 Вт | Карта PCIe |
| H100 NVL | 94 ГБ | HBM3 | 3,9 ТБ/с | — | Карта PCIe |
| H100 SXM | 80 ГБ | HBM3 | 3,35 ТБ/с | до 700 Вт | Модуль на плате HGX |
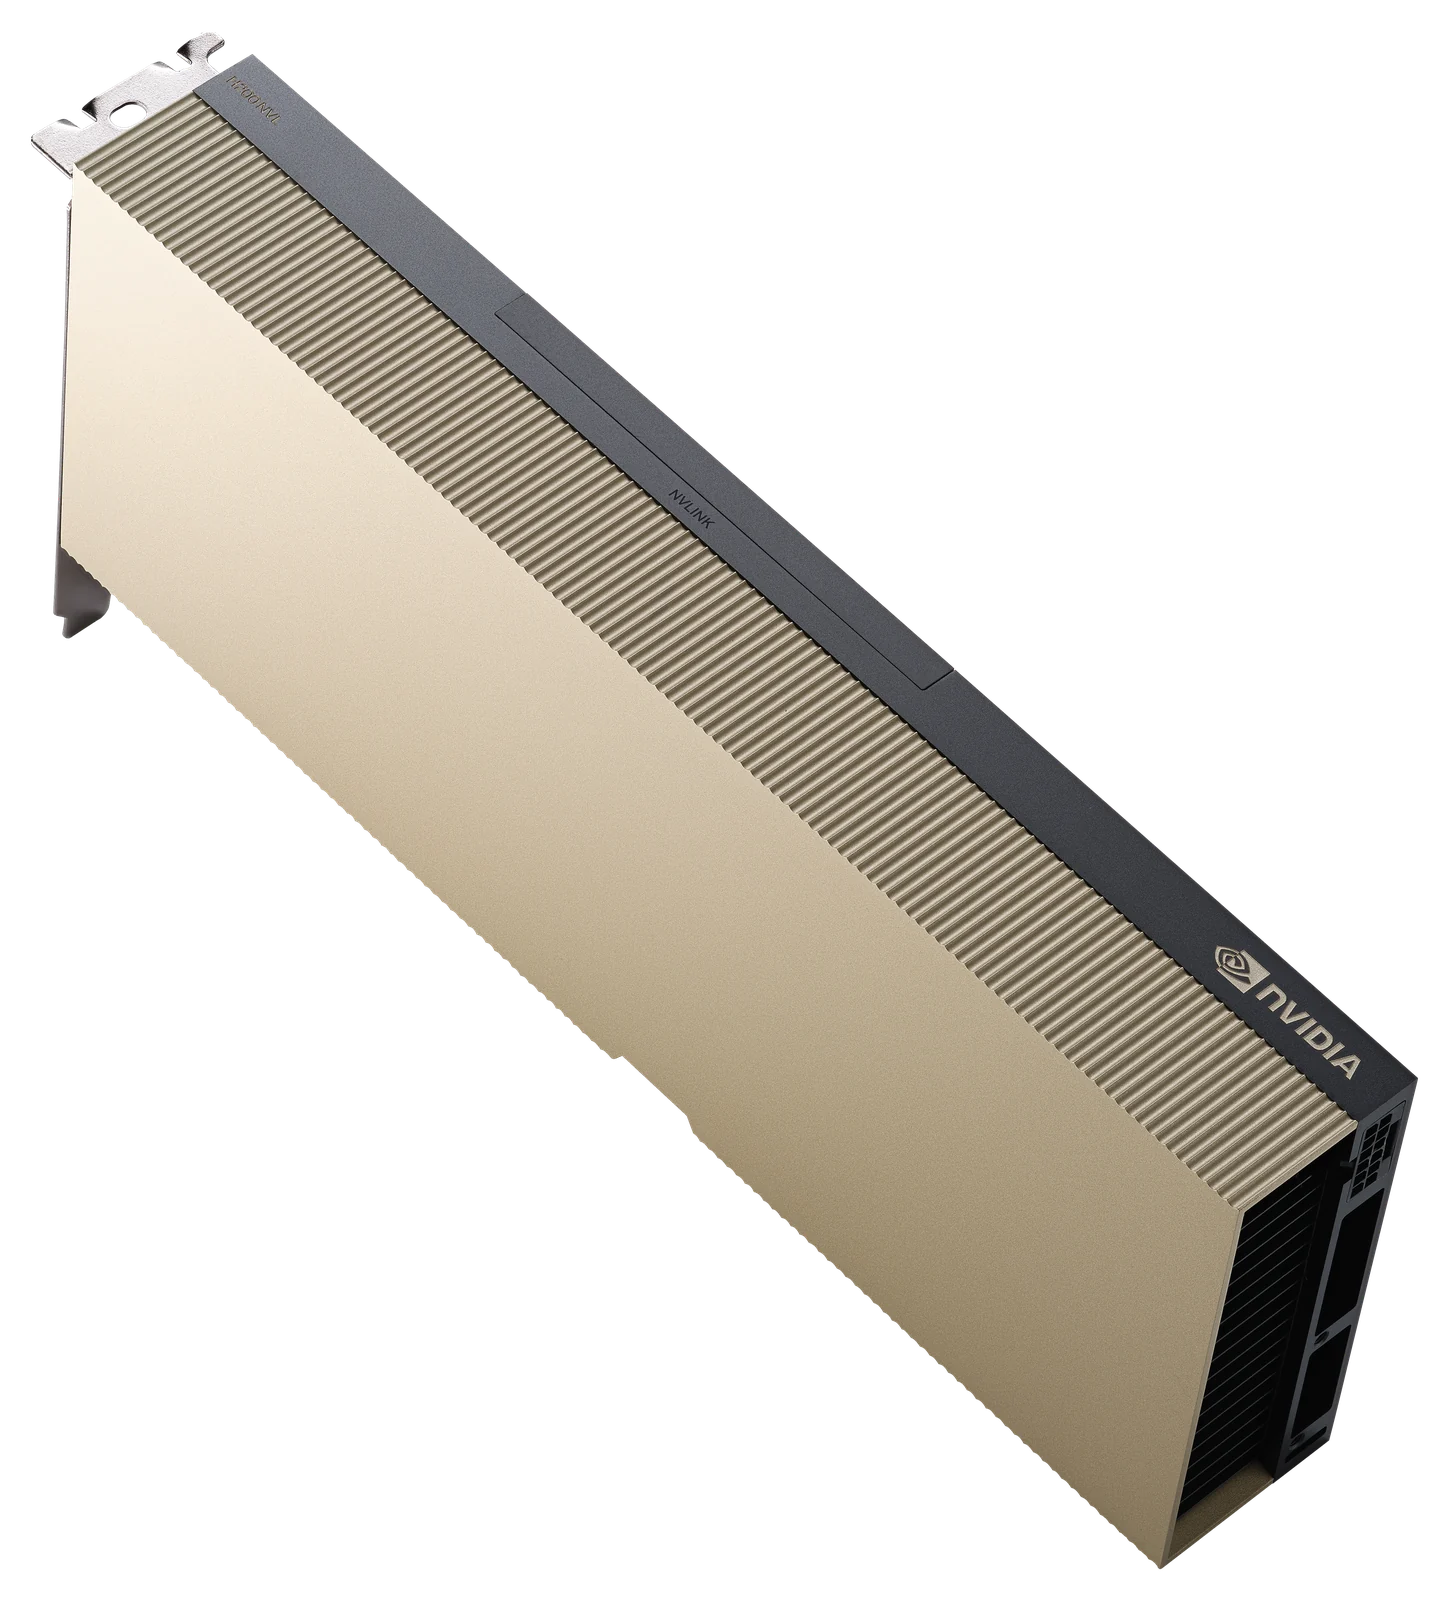
| H200 NVL | 141 ГБ | HBM3e | 4,8 ТБ/с | до 600 Вт | Карта PCIe |
| H200 SXM | 141 ГБ | HBM3e | 4,8 ТБ/с | до 700 Вт | Модуль на плате HGX |
SXM: восемь GPU в одном сервере
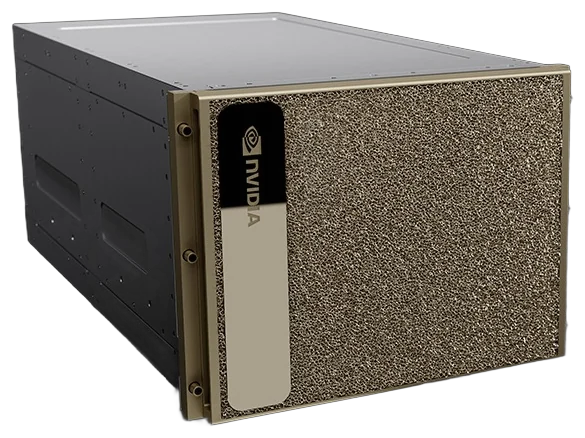
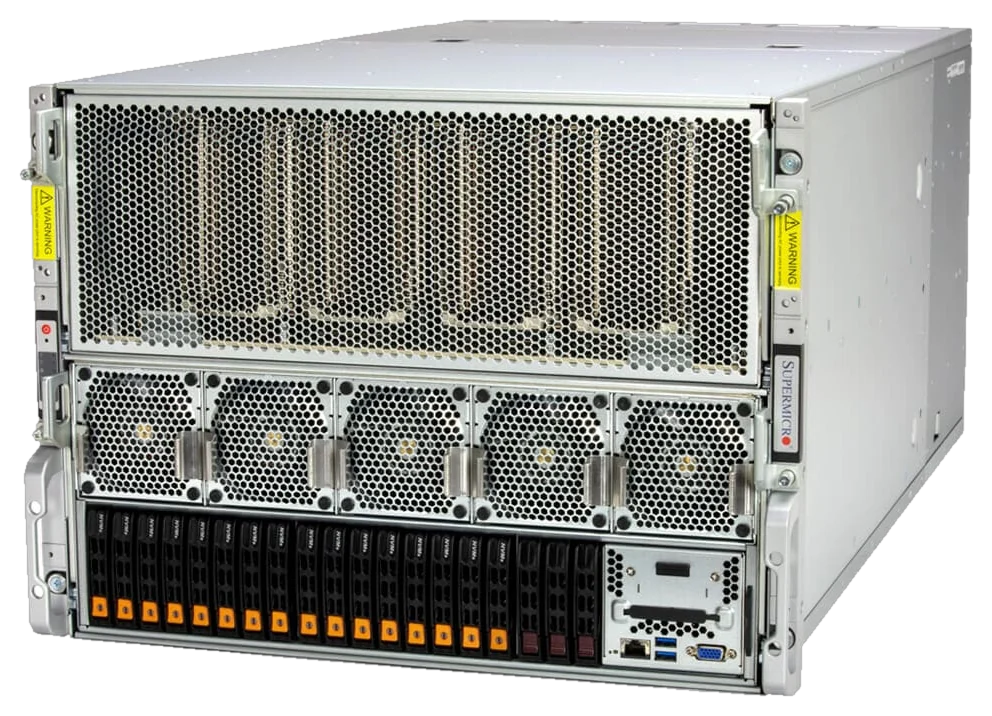
SXM-модули ставятся на плату HGX по восемь штук и связываются через NVLink со скоростью 900 ГБ/с на GPU. На этой плате построены DGX H200 и сервер Supermicro на HGX H200: в каждом восемь H200 SXM и 1 128 ГБ памяти GPU. Для сравнения, в системе на восьми H100 SXM памяти 640 ГБ.
NVL: PCIe-карта для обычного сервера
H200 NVL устанавливается в стандартный слот PCIe 5.0 x16 и потребляет до 600 Вт. Две или четыре карты можно связать NVLink-мостом на 900 ГБ/с, а одну карту разделить на независимые экземпляры MIG, до семи штук.
Из-за более низкого лимита мощности паспортная производительность у NVL немного ниже, чем у SXM: 3 341 ТФЛОПС в FP8 против примерно 4 ПФЛОПС на GPU в DGX H200 (32 ПФЛОПС на восемь карт). Подробно эту карту мы разобрали в обзоре H200 NVL.
У H100 в формате PCIe две версии: обычная на 80 ГБ HBM2e и NVL на 94 ГБ HBM3. Обе уступают H200 NVL и по объёму, и по скорости памяти.
Что даёт больший объём памяти
Модель крупнее на одной карте
Возьмём Llama 3.3 70B в FP8: около 70 ГБ под веса. На H100 с её 80 ГБ после служебных буферов под контекст остаются считанные гигабайты, хватит разве что на один короткий диалог. На H200 свободными остаются около 60 ГБ.
С gpt-oss-120b похожая картина. Её веса в формате MXFP4 занимают около 61 ГБ, и модель помещается в H100. Но на H200 под контекст и одновременные запросы остаётся в несколько раз больше места.
Больше места под KV-кеш
Каждому диалогу нужен KV-кеш. Для модели класса Llama 70B это около 10 ГБ на диалог с контекстом 32 тысячи токенов. Значит, в 60 свободных гигабайтах H200 помещается около шести таких диалогов одновременно, а на H100 ни одного полноценного.
Для корпоративного сервиса, куда запросы приходят параллельно, это решающая разница. Одна H200 закрывает задачу, для которой H100 пришлось бы ставить парой.
Восемь GPU: 640 ГБ против 1 128 ГБ
На уровне сервера разница ещё заметнее. DeepSeek V3 и R1 в родном FP8 занимают около 700 ГБ. В восемь H100 (640 ГБ) полная модель без квантования не помещается, а в восемь H200 помещается, и под кеш остаётся несколько сотен гигабайт. Сколько памяти нужно другим популярным моделям, мы посчитали в статье о том, сколько видеопамяти нужно для LLM.
Что даёт более быстрая память
Генерация текста упирается в чтение весов из памяти: на каждый новый токен модель читает их целиком. Поэтому теоретический потолок скорости для одного диалога равен пропускной способности памяти, делённой на объём весов.
Для Llama 3.3 70B в FP8 (около 70 ГБ весов):
| GPU | Скорость памяти | Теоретический потолок, токенов в секунду |
|---|---|---|
| H100 PCIe | 2 ТБ/с | ~29 |
| H100 SXM | 3,35 ТБ/с | ~48 |
| H200 SXM и H200 NVL | 4,8 ТБ/с | ~69 |
Реальная скорость ниже, но пропорция сохраняется: для одного пользователя H200 быстрее H100 SXM примерно в 1,4 раза. Заявленные NVIDIA «до 1,9 раза» выше этого соотношения. В многопользовательском режиме помогает и объём: в 141 ГБ помещается больше одновременных запросов, которые карта обрабатывает одной пачкой.
В задачах, где упор в вычисления (обучение, обработка длинного промпта), разница между H100 и H200 меньше, ведь ядра у них одни и те же. Выигрыш при обучении в другом: модель делится на меньшее число GPU, а пачка данных может быть больше.
NVIDIA H200 или H100: что выбрать
В новых проектах мы предлагаем H200, а не H100. Причина простая: вычисления и потребление те же, а памяти в 1,76 раза больше, и она быстрее. Для инференса LLM это меньше GPU на ту же модель, больше пользователей на сервер и запас под модели, которые выйдут через год.
Как выбрать версию H200:
- 1–4 карты в обычном сервере: H200 NVL. Подходит для инференса моделей 70B и дообучения, когда сервер на восемь GPU не нужен.
- Восемь GPU с NVLink: DGX H200 или сервер на HGX H200. Это уровень DeepSeek 671B в одной системе, обучения и сервиса на много пользователей. По GPU эти варианты одинаковы, различаются процессоры, оперативная память, сеть и гибкость конфигурации.
Если у вас уже работает кластер на H100, менять его ради H200 имеет смысл не всегда. Для моделей, которые свободно помещаются в 80 ГБ, и для задач с упором в вычисления разница невелика. Новые узлы на H200 разумно добавлять под инференс крупных моделей, где выигрыш от памяти максимальный.
Если нужны FP4 и максимальная скорость обучения, посмотрите на следующее поколение, например DGX B200. Когда переход на Blackwell оправдан, мы разобрали в сравнении H200 и B200.
Коротко
- H100 vs H200: один чип Hopper и одинаковые вычисления, но разная память.
- У H200 141 ГБ HBM3e и 4,8 ТБ/с против 80 ГБ и 3,35 ТБ/с у H100 SXM.
- Больший объём даёт крупные модели на одной карте и больше одновременных пользователей, более быстрая память ускоряет генерацию (по данным NVIDIA, до 1,9 раза на Llama 2 70B).
- В восемь H200 помещается полная DeepSeek R1 в FP8, в восемь H100 нет.
- Для 1–4 карт берут H200 NVL, для восьми GPU с NVLink DGX H200 или HGX-сервер.
Если вы выбираете между версиями H200 или хотите проверить, хватит ли памяти под вашу модель и число пользователей, оставьте заявку: подберём конфигурацию, а цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA
H200 NVL
Больше всего памяти в формате PCIe: 141 ГБ HBM3e на карту.
- HBM3e
- 141ГБ
- Скорость памяти
- 4,8ТБ/с
- FP8
- 3341TFLOPS
Цена по запросу
NVIDIA
DGX H200
Тот же DGX, но с почти вдвое большей памятью: 1,1 ТБ HBM3e.
- H200 SXM
- 8GPU
- Память GPU
- 1128ГБ
- FP8
- 32ПФЛОПС
Цена по запросу
Supermicro
Supermicro SYS-821GE-TNHR
Сервер на HGX H200: те же 8 GPU, что в DGX H200.
- H200 SXM
- 8GPU
- Память GPU
- 1128ГБ
- Высота
- 8U
Цена по запросу
Читайте также
H200 vs B200: сравнение NVIDIA Hopper и Blackwell
H200 vs B200: память, скорость, FP4, NVLink 5 и потребление. Сравниваем DGX H200 и DGX B200 и объясняем, когда хватит Hopper, а когда нужен Blackwell.
NVIDIA H200 NVL: обзор PCIe-ускорителя на 141 ГБ для LLM
Обзор NVIDIA H200 NVL: характеристики, чем PCIe-версия отличается от SXM, какие LLM помещаются в 141 ГБ HBM3e и когда выбрать её вместо RTX PRO 6000.
DGX или HGX: NVIDIA DGX или сервер Supermicro на тех же GPU
DGX или HGX: чем готовая система NVIDIA отличается от сервера Supermicro на той же плате с восемью GPU. Сравниваем DGX B200, DGX H200 и HGX-серверы, кому что подходит.