Запуск моделей
gpt-oss-120b и gpt-oss-20b: на каком железе запускать
Сколько памяти нужно gpt-oss-120b и gpt-oss-20b, открытым моделям OpenAI: веса в MXFP4, какие GPU подходят, сколько пользователей потянет карта и чем запускать.
Содержание
gpt-oss-120b в родном формате MXFP4 занимает около 61 ГБ и помещается в одну видеокарту с памятью от 80 ГБ. Удобнее всего карта на 96 ГБ, например RTX PRO 6000: сверх весов остаётся около 35 ГБ под контекст пользователей. Младшей gpt-oss-20b хватает 16 ГБ памяти, поэтому RTX 5090 на 32 ГБ справляется с ней с большим запасом.
Что такое gpt-oss
В августе 2025 года OpenAI выпустила две модели с открытыми весами под лицензией Apache 2.0, то есть их можно использовать в коммерческих продуктах и запускать на своём железе. Обе построены по схеме MoE: в памяти лежат все веса, но на каждый токен работает лишь небольшая их часть.
| Параметр | gpt-oss-120b | gpt-oss-20b |
|---|---|---|
| Параметров всего | 117B | 21B |
| Активных на токен | 5,1B | 3,6B |
| Веса | ~61 ГБ в MXFP4 | помещаются в 16 ГБ |
| Минимум памяти | одна карта на 80 ГБ | 16 ГБ |
| Уровни рассуждения | low, medium, high | low, medium, high |
| Лицензия | Apache 2.0 | Apache 2.0 |
Для компании это открытая модель OpenAI, которую можно развернуть внутри периметра: данные не уходят во внешний API, а расходы предсказуемы.
MXFP4: почему 117B параметров занимают 61 ГБ
Обычно модели выпускают в BF16, это 2 байта на параметр, и 117B заняли бы около 234 ГБ. gpt-oss выпущена сразу в 4-битном формате MXFP4: значения хранятся по 4 бита, а у каждой небольшой группы есть общий масштаб. В итоге выходит чуть больше полбайта на параметр с учётом служебных данных.
Важно, что это родной формат. Это не сжатая энтузиастами копия, а тот вид, в котором OpenAI выпустила модель, поэтому эталонное качество gpt-oss достигается именно в MXFP4. Дополнительно квантовать её почти нет смысла: памяти это сэкономит немного.
Среди GPU NVIDIA 4-битная арифметика аппаратно есть только у Blackwell: RTX PRO 6000, RTX 5090, DGX Spark, B200. На Hopper (H100, H200) модель тоже работает: веса хранятся в тех же 4 битах и занимают те же ~61 ГБ, а вычисления идут в более высокой точности. Подробнее о форматах читайте в статье о квантовании LLM.
На какой карте запускать gpt-oss-120b
Сверх весов памяти нужно на KV-кеш (контекст каждого диалога) и 10–20% служебного. От этого запаса зависит, сколько пользователей и какой длины документы потянет одна карта.
- 80 ГБ, например H100. Модель помещается, но под кеш и служебное остаётся меньше 20 ГБ. Хватит для разработки и небольшого числа пользователей с умеренным контекстом.
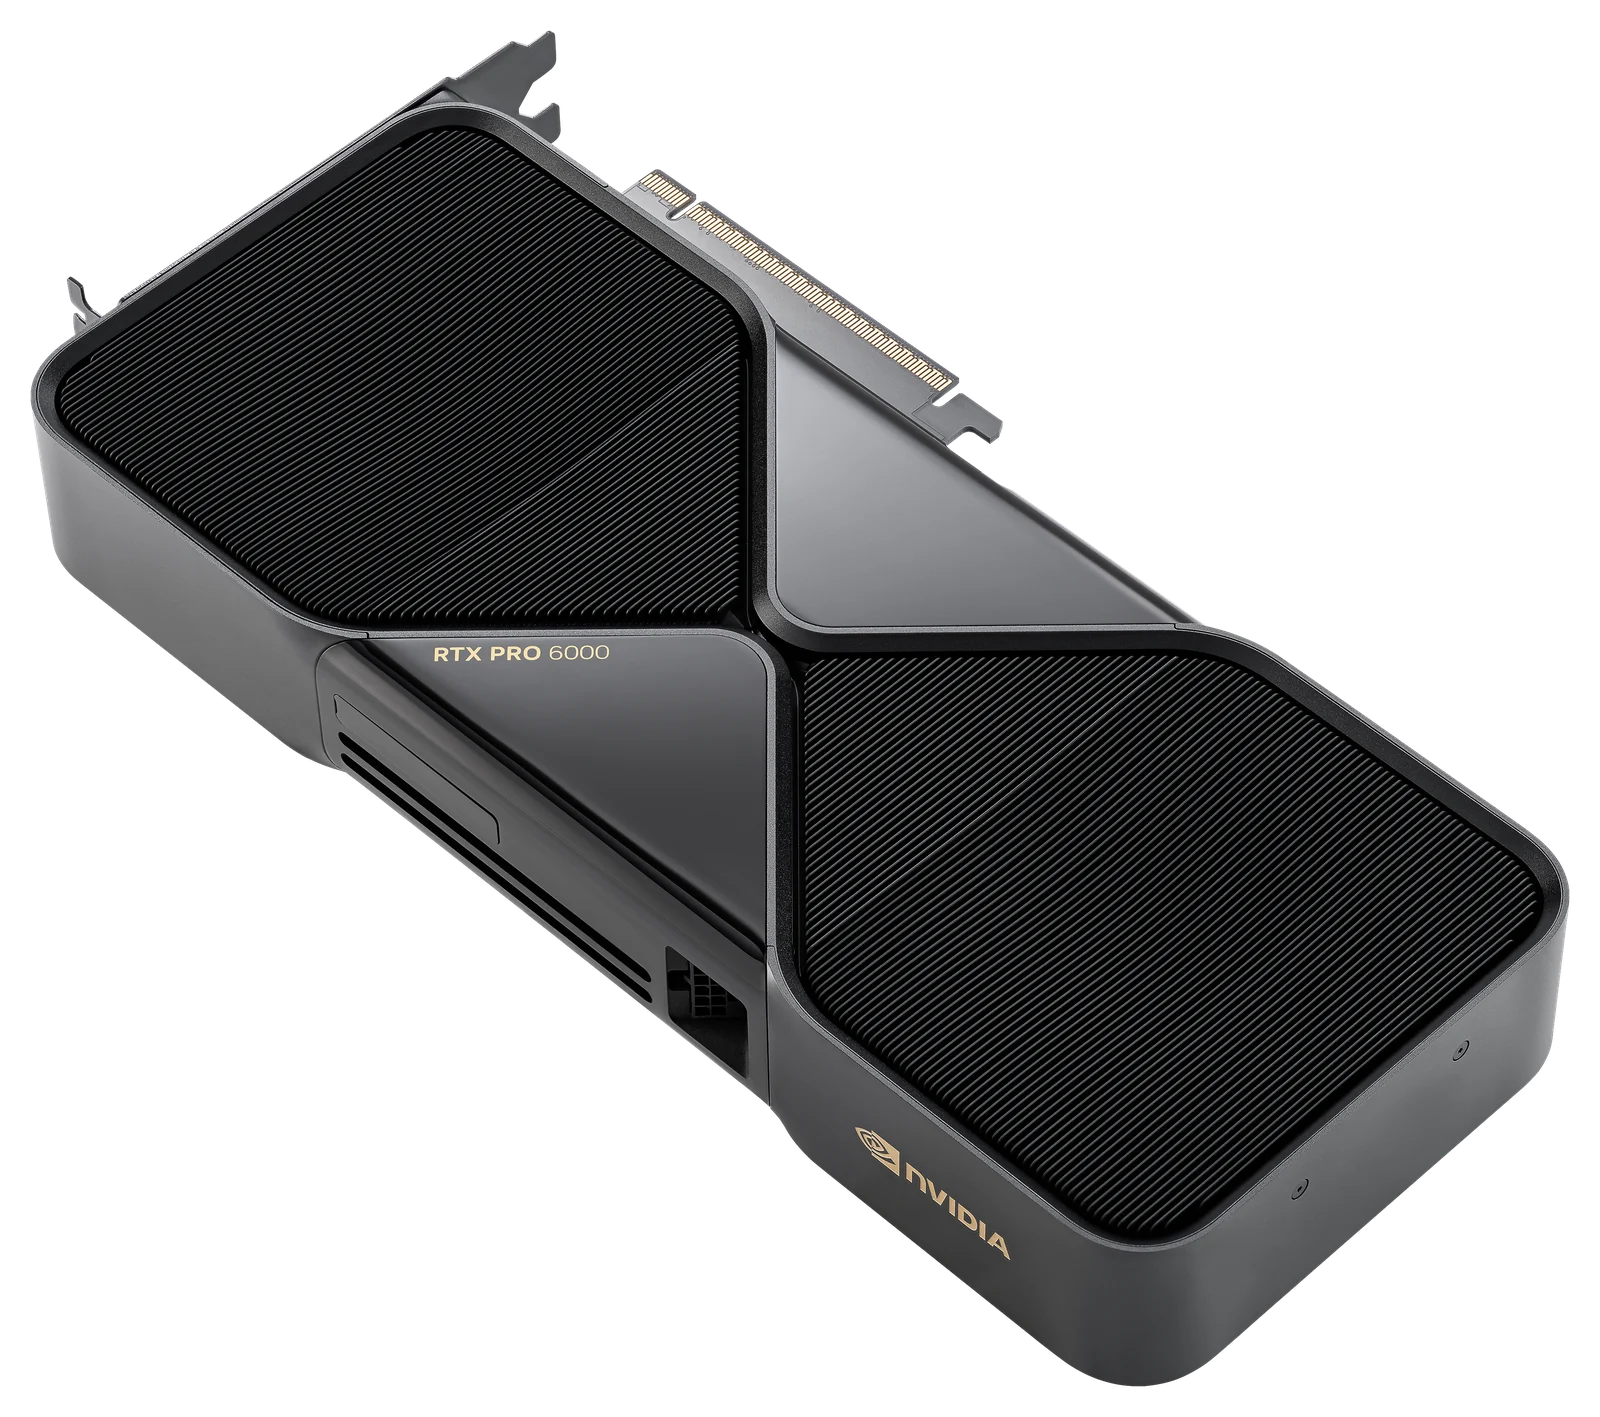
- 96 ГБ: RTX PRO 6000 Blackwell. Около 35 ГБ сверх весов, аппаратная поддержка FP4 и память с ECC. Практичный вариант для сервиса на отдел.
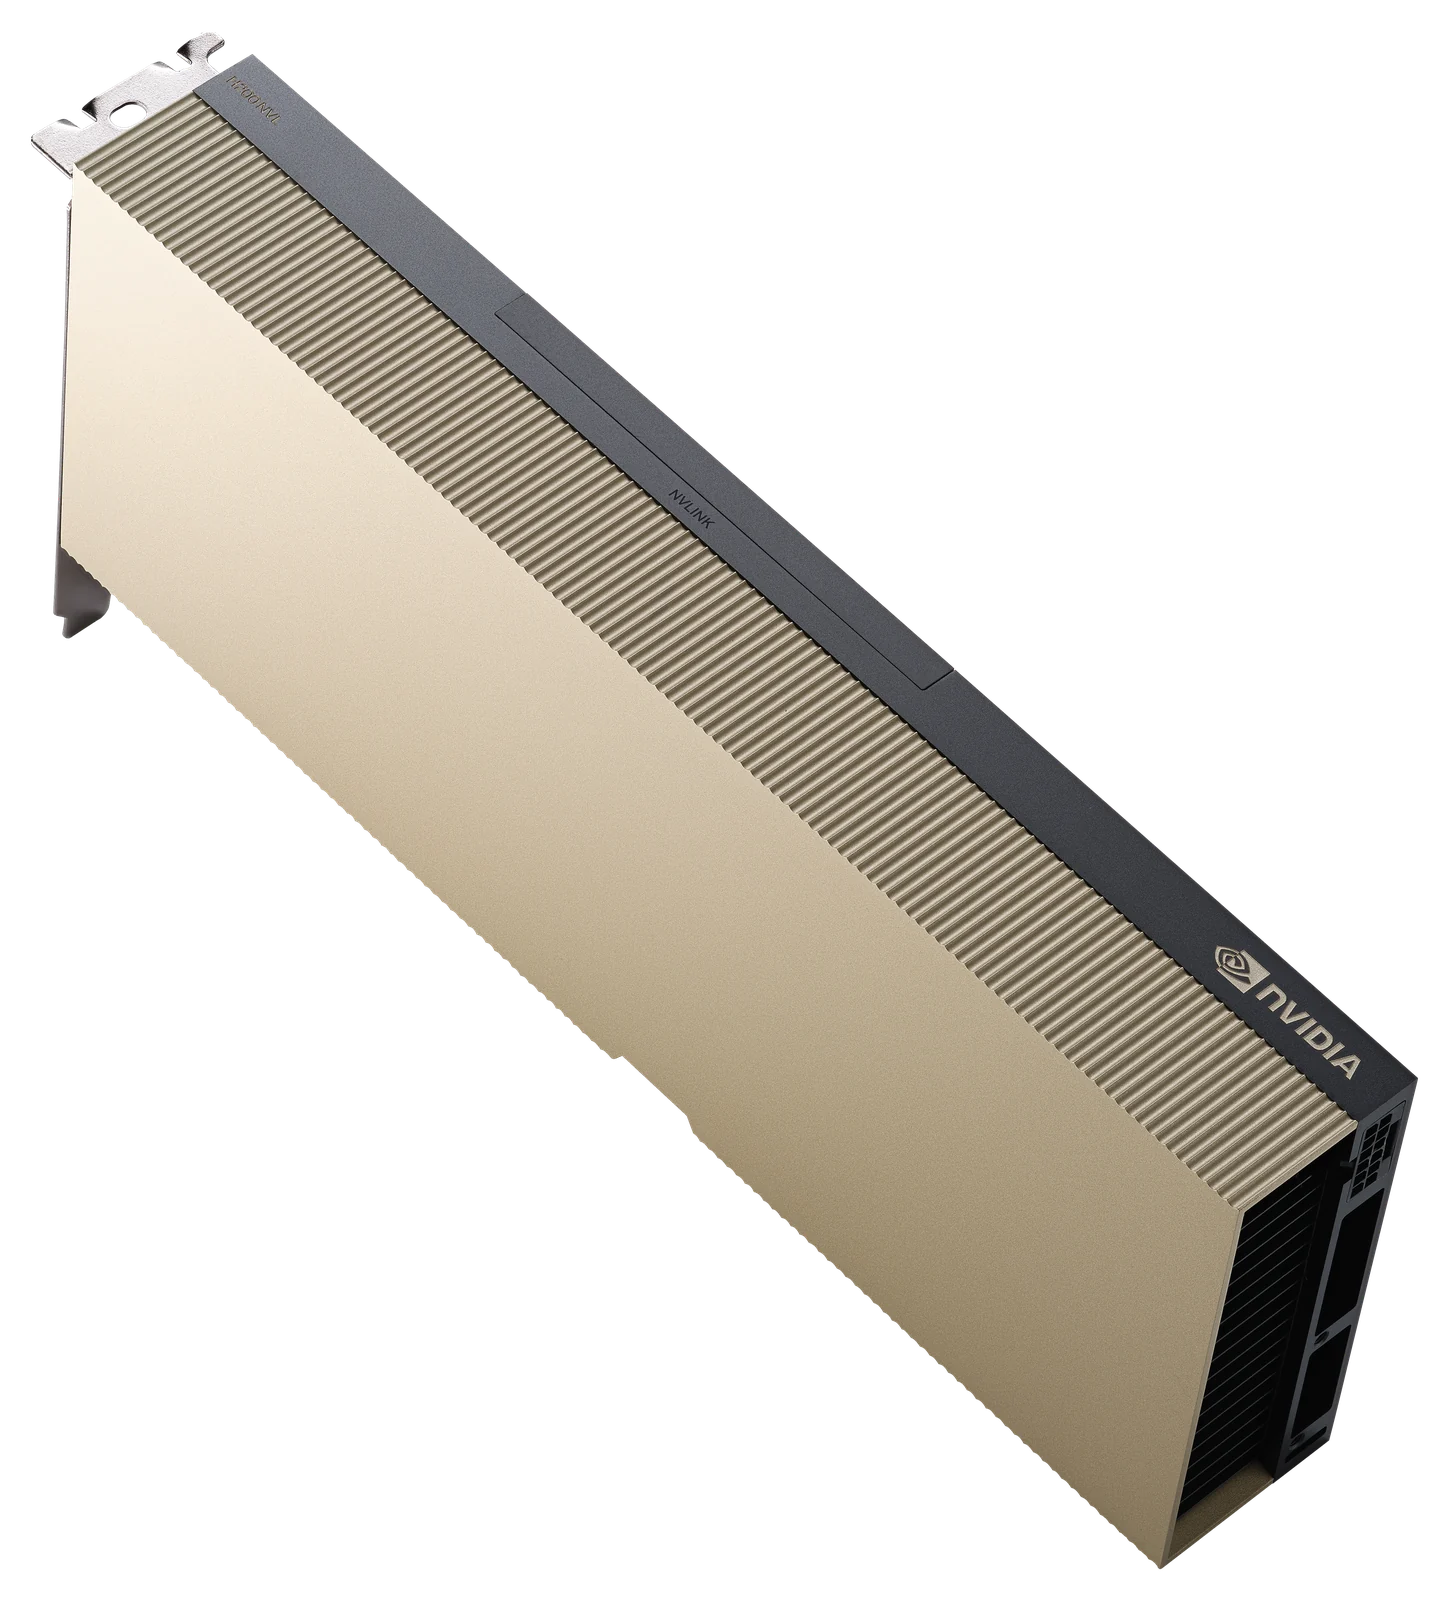
- 141 ГБ: H200 NVL. Около 80 ГБ сверх весов и память HBM3e на 4,8 ТБ/с. Вариант для сервиса на много пользователей с длинным контекстом.
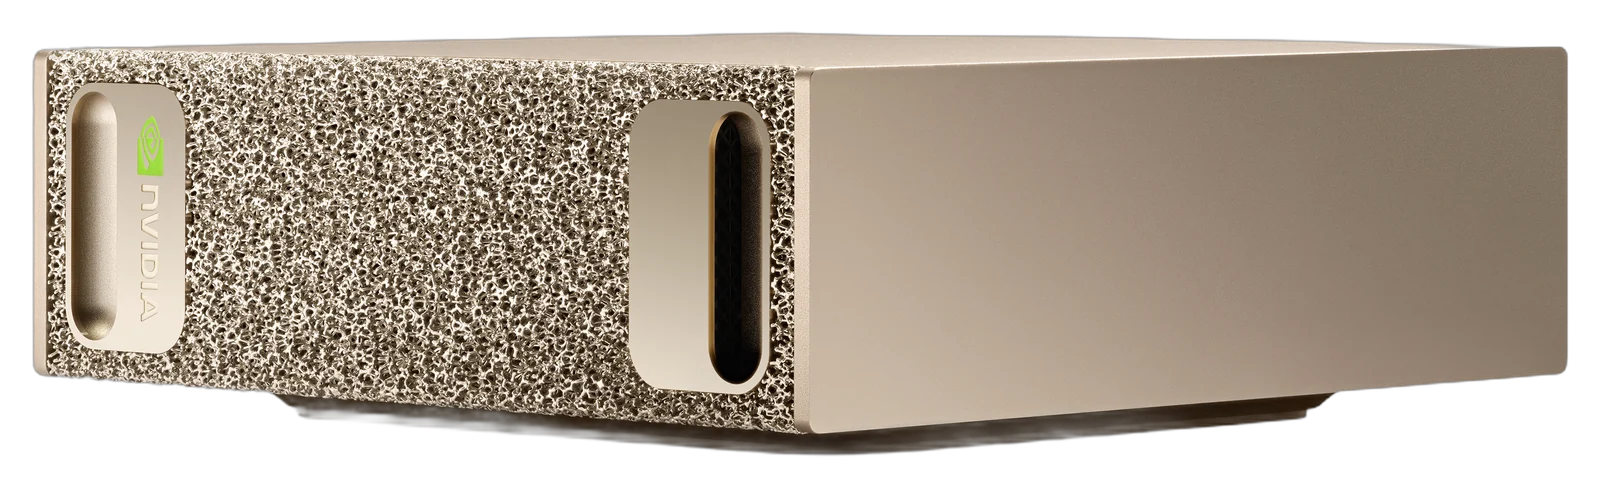
- 128 ГБ общей памяти: DGX Spark. Модель помещается целиком, остаётся место под контекст. Но память общая с процессором и заметно медленнее, чем у серверных GPU. Подходит одному разработчику, для прототипа и тестов.
Когда пользователей много, удобно масштабироваться копиями. Модель помещается в одну карту, поэтому сервер Gigabyte на 8 × RTX PRO 6000 может держать восемь независимых копий, по одной на карту. Картам не нужно обмениваться данными, и отсутствие NVLink здесь не мешает.
gpt-oss-20b: хватит 16 ГБ
Младшая модель рассчитана на работу при 16 ГБ памяти. GeForce RTX 5090 с 32 ГБ держит её с запасом под длинный контекст, этого хватает для рабочей станции разработчика или небольшой команды.
Для серверной логичнее RTX PRO 6000. Лицензия драйвера GeForce не предусматривает установку в дата-центрах, а у профессиональной карты есть MIG: её можно разделить на изолированные экземпляры, до четырёх на карту. Каждому экземпляру достаётся около четверти памяти, то есть около 24 ГБ, этого хватает на свою копию 20b. Чем отличаются эти две карты, мы разобрали в сравнении RTX 5090 и RTX PRO 6000.
20b или 120b
20b легче в запуске и отвечает быстрее, но параметров у неё в пять с лишним раз меньше, и на сложных задачах она обычно уступает старшей. Практичное деление такое:
- 20b: классификация и разметка текстов, черновики, простые ответы, сценарии с большим числом параллельных запросов.
- 120b: внутренний ассистент для сотрудников, анализ документов, код, задачи, где ошибка обходится дорого.
- Обе сразу: на одном сервере можно держать обе модели и отправлять простые запросы в 20b, а сложные в 120b.
Выбор лучше подтвердить на своих данных: соберите несколько десятков типичных запросов и сравните ответы обеих моделей.
Почему gpt-oss быстрая и что дают уровни рассуждения
Генерация упирается в чтение весов из памяти: на каждый токен модель читает все задействованные веса. У старшей модели на токен работает 5,1B параметров, в 4 битах это порядка 3 ГБ (часть слоёв хранится в более высокой точности, поэтому чуть больше). Плотная Llama 3.3 70B в 4 битах читает около 40 ГБ на токен.
Выходит, что теоретический потолок скорости генерации у старшей gpt-oss примерно в десять раз выше, чем у плотной 70B, при сопоставимом объёме памяти. Реальная скорость ниже потолка, и разрыв на практике меньше, но модель отвечает заметно быстрее плотных моделей своего класса. По этой же причине она хорошо подходит для DGX Spark: медленную память там частично компенсирует малое число активных параметров.
Уровень рассуждения выбирается в запросе:
- low: короткое рассуждение, быстрый ответ. Для классификации, извлечения данных, простых вопросов.
- medium: баланс скорости и качества для большинства задач.
- high: длинное рассуждение перед ответом. Для анализа, кода, многошаговых задач.
У высокого уровня есть цена для железа. Модель генерирует больше токенов, ответ приходит позже, а KV-кеш на один диалог растёт. Если сервис будет часто работать на уровне high, закладывайте больше памяти под кеш.
Требования gpt-oss к железу: сводная таблица
| Устройство | Память | Скорость памяти | gpt-oss-20b | gpt-oss-120b |
|---|---|---|---|---|
| RTX 5090 | 32 ГБ GDDR7 | 1,79 ТБ/с | с большим запасом | не помещается |
| H100 SXM (вне каталога) | 80 ГБ HBM3 | 3,35 ТБ/с | с большим запасом | помещается, мало места под кеш |
| RTX PRO 6000 | 96 ГБ GDDR7 с ECC | 1,79 ТБ/с | до четырёх копий через MIG | ~35 ГБ под кеш |
| DGX Spark | 128 ГБ общей памяти | ниже, чем у серверных GPU | с большим запасом | помещается, генерация медленнее |
| H200 NVL | 141 ГБ HBM3e | 4,8 ТБ/с | с большим запасом | ~80 ГБ под кеш, много пользователей |
Как в общем случае считать веса и кеш, мы показали в статье «Сколько видеопамяти нужно для LLM».
Чем запускать gpt-oss локально
- Ollama и llama.cpp. Самый простой способ: одна команда, и модель работает. Удобно на рабочей станции, DGX Spark и для одного пользователя.
- vLLM. Для многопользовательского сервиса: непрерывный батчинг, PagedAttention и OpenAI-совместимый API. Приложения, написанные под API OpenAI, подключаются к нему со сменой адреса сервера.
- TensorRT-LLM. Максимум скорости на NVIDIA, но настройка сложнее.
Коротко
- Старшая модель: 117B параметров, 5,1B активных, около 61 ГБ в родном MXFP4.
- Минимум для старшей модели одна карта на 80 ГБ, удобно 96 ГБ, для многих пользователей 141 ГБ.
- gpt-oss-20b работает при 16 ГБ памяти, RTX 5090 держит её с большим запасом.
- Малое число активных параметров даёт высокую скорость генерации даже на одной карте.
- Уровень рассуждения high повышает качество на сложных задачах, но требует больше времени и памяти под кеш.
Если планируете развернуть gpt-oss в компании, оставьте заявку: подберём карту или сервер под ваше число пользователей, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
NVIDIA
H200 NVL
Больше всего памяти в формате PCIe: 141 ГБ HBM3e на карту.
- HBM3e
- 141ГБ
- Скорость памяти
- 4,8ТБ/с
- FP8
- 3341TFLOPS
Цена по запросу
NVIDIA Популярное
DGX Spark
Суперкомпьютер размером с книгу: модели до 200B на столе.
- Общая память
- 128ГБ
- ИИ, FP4
- 1ПФЛОПС
- Вес
- 1,2кг
от 990 000 ₽
Читайте также
Сколько видеопамяти нужно для LLM: расчёт для моделей от 8B до 671B
Простая формула, сколько видеопамяти нужно языковой модели: веса, KV-кеш и запас. Таблица для Qwen3, Llama 70B, gpt-oss и DeepSeek и подбор GPU под объём.
RTX 5090 vs RTX PRO 6000 Blackwell: что взять для ИИ
RTX 5090 vs RTX PRO 6000: одна архитектура и одинаковая скорость памяти, но 32 ГБ против 96 ГБ. Разбираем ECC, MIG, лицензию драйвера и кому какая карта подходит.
Квантование LLM: FP8, INT4 и FP4 простыми словами
Что такое квантование LLM простыми словами: форматы FP8, INT8, INT4, FP4 и GGUF, сколько памяти они экономят, как влияют на качество и какое железо их поддерживает.