Сравнения
H200 vs B200: сравнение NVIDIA Hopper и Blackwell
H200 vs B200: память, скорость, FP4, NVLink 5 и потребление. Сравниваем DGX H200 и DGX B200 и объясняем, когда хватит Hopper, а когда нужен Blackwell.
Содержание
В сравнении H200 vs B200 новое поколение впереди почти по всем пунктам: у B200 180 ГБ памяти HBM3e на GPU вместо 141 ГБ, вдвое более быстрый NVLink и аппаратная поддержка FP4, которой у Hopper нет. Цена этого в инфраструктуре: DGX B200 потребляет до 14,3 кВт против 10,2 кВт у DGX H200. H200 по-прежнему хватает для инференса моделей с весами примерно до терабайта, а B200 нужен для обучения, FP4 и максимальной плотности вычислений.
Hopper и Blackwell: что изменилось
H200 относится к поколению Hopper: это тот же чип, что у H100, но с памятью HBM3e на 141 ГБ. B200 построен на архитектуре Blackwell, следующем поколении серверных GPU NVIDIA. Главные отличия для практики:
- Память: 180 ГБ на GPU против 141 ГБ, в сервере на восемь GPU 1 440 ГБ против 1 128 ГБ.
- Скорость памяти: 4,8 ТБ/с у H200, по данным NVIDIA до 8 ТБ/с у B200.
- Форматы: FP8 есть у обоих, FP4 (NVFP4) аппаратно только у Blackwell.
- Связь между GPU: NVLink 4 на 900 ГБ/с против NVLink 5 на 1,8 ТБ/с на каждый GPU.
- Потребление: система на B200 потребляет примерно на 40% больше и выше на 2U.
H200 vs B200 в цифрах: DGX H200 и DGX B200
Удобнее всего сравнивать готовые системы NVIDIA на восьми GPU. Характеристики B200 и H200 в их составе:
| Параметр | DGX H200 | DGX B200 |
|---|---|---|
| GPU | 8 × H200 SXM | 8 × B200 |
| Память на GPU | 141 ГБ HBM3e | 180 ГБ HBM3e |
| Память GPU всего | 1 128 ГБ | 1 440 ГБ |
| Скорость памяти на GPU | 4,8 ТБ/с | до 8 ТБ/с (по данным NVIDIA) |
| FP8 | 32 ПФЛОПС | 72 ПФЛОПС |
| FP4 | нет | 144 ПФЛОПС |
| Связь GPU | NVLink 4, 900 ГБ/с на GPU | NVLink 5, 14,4 ТБ/с суммарно |
| Процессоры | 2 × Xeon Platinum 8480C, 112 ядер | 2 × Xeon Platinum 8570, 112 ядер |
| Оперативная память | 2 ТБ | до 4 ТБ |
| Высота | 8U | 10U |
| Энергопотребление | до 10,2 кВт | до 14,3 кВт |
Те же восемь GPU стоят в серверах на платформе HGX: Supermicro на HGX H200 и Supermicro на HGX B200. Вычислительная начинка у них та же, что у DGX H200 и DGX B200, а процессоры, память и сеть подбираются под задачу.
Память: сколько и как быстро
Разница в объёме на уровне сервера около 28%: 1 440 ГБ против 1 128 ГБ. Для большинства открытых моделей хватает обоих вариантов. DeepSeek V3 и R1 в родном FP8 (около 700 ГБ) помещаются и в DGX H200, и в DGX B200 с запасом под кеш. Как H200 получила свой объём и что он дал по сравнению с предшественницей, мы разобрали в сравнении H100 и H200.
Разница становится принципиальной на моделях около терабайта. Kimi K2 с триллионом параметров в FP8 занимает около 1 ТБ. В 1 128 ГБ такая модель формально помещается, но под контекст почти ничего не остаётся, а в 1 440 ГБ свободными будут несколько сотен гигабайт.
Скорость памяти определяет скорость генерации: теоретический потолок для одного диалога равен пропускной способности, делённой на объём читаемых весов. При 8 ТБ/с против 4,8 ТБ/с потолок у B200 примерно в 1,7 раза выше на той же модели. Реальная скорость ниже теоретической, но направление разницы такое.
FP4: формат, который есть только у Blackwell
FP8 аппаратно поддерживают оба поколения. FP4 (вариант NVIDIA называется NVFP4) появился только в Blackwell. Это 0,5 байта на параметр вместо одного, а значит:
- модель занимает вдвое меньше памяти, чем в FP8;
- на каждый токен из памяти читается вдвое меньше данных, генерация быстрее;
- тензорные ядра считают в FP4 вдвое быстрее, чем в FP8: у DGX B200 144 ПФЛОПС против 72.
На H200 тоже можно запустить модель с 4-битными весами (INT4 через GPTQ или AWQ), и памяти она займёт примерно столько же. Но вычисления при этом идут в более высокой точности, поэтому такого прироста производительности, как у FP4 на Blackwell, не будет.
Потери качества на 4 битах заметнее, чем на 8, особенно в сложных задачах. FP4 стоит проверить на своих данных, прежде чем строить на нём сервис.
Даже без FP4 у Blackwell больше вычислений: по паспорту DGX B200 даёт 72 ПФЛОПС в FP8 против 32 у DGX H200, больше чем вдвое. NVIDIA заявляет, что DGX B200 обучает модели втрое быстрее DGX H100. Вычислительная мощность H100 и H200 одинакова, поэтому для сравнения с H200 эту цифру можно брать как примерный ориентир.
NVLink 4 против NVLink 5
Внутри сервера восемь GPU обмениваются данными через NVLink. У Hopper это NVLink 4 на 900 ГБ/с на GPU, у Blackwell NVLink 5 на 1,8 ТБ/с, вдвое больше. В DGX B200 суммарно 14,4 ТБ/с.
Где это заметно:
- Обучение. GPU постоянно обмениваются градиентами и частями модели, и чем быстрее связь, тем меньше они простаивают.
- Инференс крупной модели на восьми GPU. При тензорном параллелизме каждый слой считается на всех картах сразу, и на каждом шаге они синхронизируются.
Если модель целиком помещается на одну карту и каждый GPU обслуживает свои запросы, NVLink почти не влияет на результат. Между серверами данные идут уже по сети, обычно InfiniBand или Ethernet на 400 Гбит/с на порт. В DGX H200 для этого стоят восемь портов ConnectX-7 по 400 Гбит/с, по одному на GPU.
Потребление, стойка и охлаждение
Здесь преимущество у H200. Один H200 SXM потребляет до 700 Вт, и вся система DGX H200 укладывается в 10,2 кВт. DGX B200 потребляет до 14,3 кВт и занимает 10U вместо 8U.
Тепловыделение сервера практически равно его потреблению, поэтому охлаждение должно отводить:
- от DGX H200: до 10,2 кВт, около 34 800 BTU/ч;
- от DGX B200: до 14,3 кВт, около 48 800 BTU/ч.
Многие серверные и стойки рассчитаны на заметно меньшую мощность, особенно если в одну стойку ставится два сервера: это уже больше 20 и 28 кВт соответственно. В HGX-серверах Supermicro производитель закладывает шесть блоков питания с резервированием: по 3 000 Вт для H200 и по 5 250 Вт для B200. Что проверить в серверной до поставки, мы описали в статье о питании и охлаждении GPU-сервера.
При этом энергоэффективность на стороне Blackwell: 72 ПФЛОПС FP8 на 14,3 кВт против 32 ПФЛОПС на 10,2 кВт. На киловатт B200 даёт примерно в 1,6 раза больше вычислений.
Blackwell или Hopper: когда хватит H200, а когда нужен B200
Выбирая NVIDIA B200 или H200, отталкивайтесь от задачи и от площадки.
H200 хватит, если:
- основная задача инференс моделей с весами примерно до 1 ТБ: DeepSeek в FP8, Qwen3 235B, Llama 70B на много пользователей;
- мощность на стойку ограничена и 14 кВт на сервер площадка не выдержит;
- FP8 устраивает по скорости и качеству, а FP4 не планируется.
B200 нужен, если:
- главная задача обучение или полное дообучение крупных моделей, где решают вычисления и NVLink 5;
- планируется инференс в FP4 ради максимальной пропускной способности сервиса;
- нужна максимальная вычислительная плотность: больше вычислений на юнит стойки и на киловатт;
- веса модели приближаются к терабайту или нужен очень длинный контекст для многих пользователей.
Если и 1 440 ГБ мало, следующий шаг DGX B300 на Blackwell Ultra с 2,1 ТБ памяти GPU. Подробности в обзоре DGX B300.
Коротко
- H200 vs B200: 141 против 180 ГБ на GPU, 4,8 против до 8 ТБ/с, NVLink 4 против NVLink 5.
- FP4 аппаратно есть только у Blackwell, а в FP8 DGX B200 по паспорту больше чем вдвое мощнее DGX H200.
- DGX B200 потребляет до 14,3 кВт против 10,2 кВт и занимает 10U вместо 8U.
- H200 подходит для инференса моделей до терабайта при ограниченном питании, B200 для обучения, FP4 и максимальной плотности.
Если вы выбираете поколение под конкретную модель и площадку, оставьте заявку: посчитаем память и потребление, подготовим варианты на H200 и B200, а цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
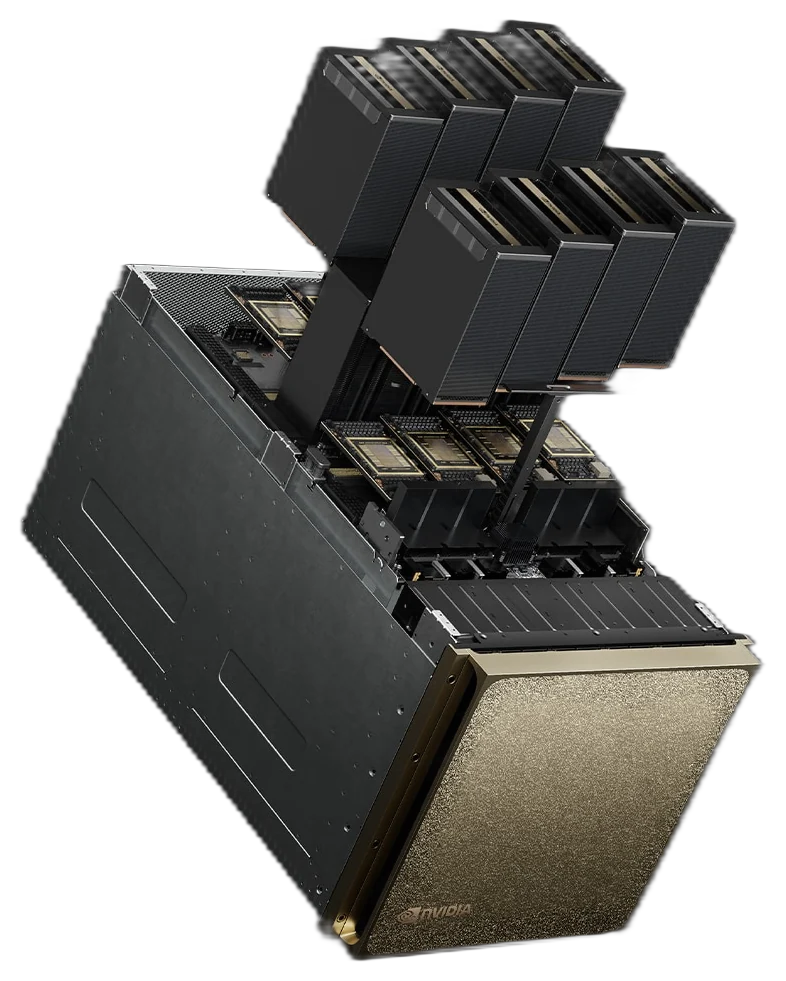
NVIDIA
DGX B200
Blackwell для обучения и инференса: 1,44 ТБ памяти GPU.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- FP4
- 144ПФЛОПС
Цена по запросу
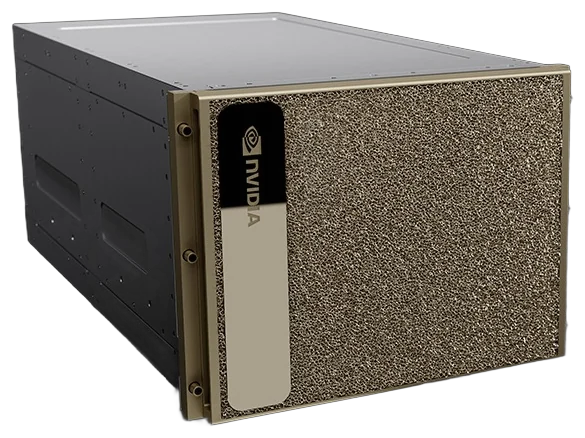
NVIDIA
DGX H200
Тот же DGX, но с почти вдвое большей памятью: 1,1 ТБ HBM3e.
- H200 SXM
- 8GPU
- Память GPU
- 1128ГБ
- FP8
- 32ПФЛОПС
Цена по запросу
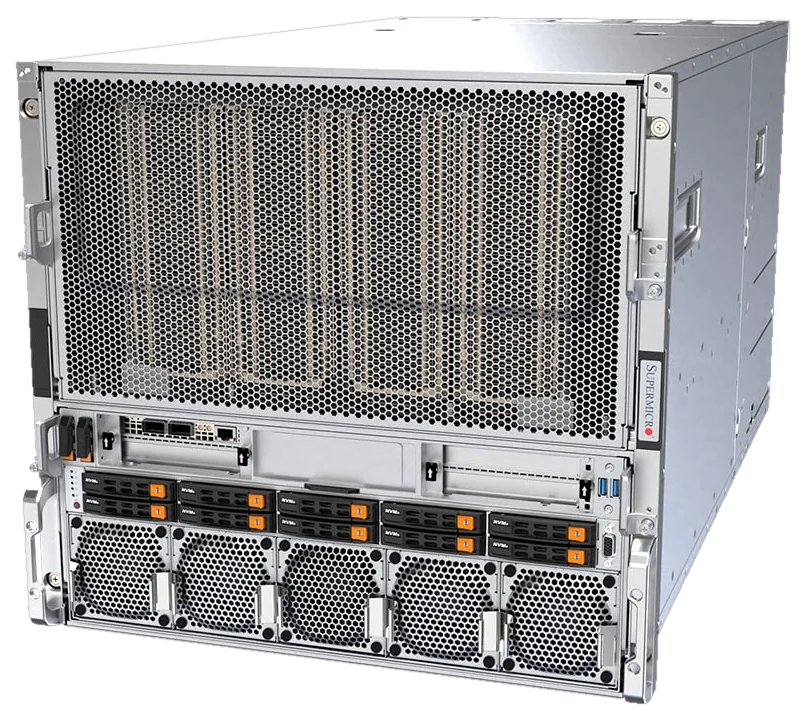
Supermicro
Supermicro SYS-A22GA-NBRT
Сервер на HGX B200: Blackwell без переплаты за бренд DGX.
- B200
- 8GPU
- Память GPU
- 1440ГБ
- Высота
- 10U
Цена по запросу
Читайте также
NVIDIA H100 vs H200: в чём разница и что выбрать
H100 vs H200: один чип Hopper, но у H200 141 ГБ HBM3e вместо 80 ГБ и 4,8 ТБ/с вместо 3,35. Что это даёт в инференсе LLM, какие есть версии и что выбрать.
NVIDIA DGX B300: обзор флагманской системы на Blackwell Ultra
Обзор NVIDIA DGX B300: характеристики, чем система на Blackwell Ultra отличается от DGX B200, для каких задач она нужна и что подготовить под питание и сеть.
DGX или HGX: NVIDIA DGX или сервер Supermicro на тех же GPU
DGX или HGX: чем готовая система NVIDIA отличается от сервера Supermicro на той же плате с восемью GPU. Сравниваем DGX B200, DGX H200 и HGX-серверы, кому что подходит.