Выбор оборудования
Сколько видеопамяти нужно для LLM: расчёт для моделей от 8B до 671B
Простая формула, сколько видеопамяти нужно языковой модели: веса, KV-кеш и запас. Таблица для Qwen3, Llama 70B, gpt-oss и DeepSeek и подбор GPU под объём.
Содержание
Сколько видеопамяти нужно для LLM, считается за минуту: число параметров × байты на параметр + 10–20% запаса + KV-кеш под контекст. Например, Llama 3.3 70B в 8-битном формате занимает около 70 ГБ под веса, и с учётом кеша ей нужна карта на 96 ГБ или больше. Ниже разберём формулу по частям, посчитаем популярные модели и подберём под них железо.
Из чего складывается память модели
Когда модель запускается, видеопамять уходит на три вещи.
- Веса. Это сама модель. Их объём зависит от числа параметров и формата хранения.
- KV-кеш. Промежуточные данные внимания для каждого токена в контексте. Растёт с длиной диалога и числом одновременных пользователей.
- Служебное. Активации, буферы библиотек, контекст CUDA. Обычно 10–20% сверху.
Если что-то из этого не помещается, модель либо не запустится, либо начнёт выгружать данные в оперативную память и замедлится в десятки раз.
Веса: параметры × формат
Сколько байт занимает один параметр, зависит от точности:
| Формат | Байт на параметр | Где используется |
|---|---|---|
| FP16 / BF16 | 2 | Обучение, эталонное качество |
| FP8 / INT8 | 1 | Инференс почти без потери качества |
| INT4 / FP4 | 0,5 | Инференс на ограниченном железе |
Отсюда простое правило: модель в FP16 занимает вдвое больше гигабайт, чем у неё миллиардов параметров, в FP8 столько же, в 4 битах вдвое меньше. Подробнее о том, чем отличаются форматы и сколько качества теряется, мы разобрали в статье о квантовании LLM.
KV-кеш: память под контекст
Кеш часто забывают, а на длинном контексте он сравним с весами. Посчитаем для Llama 3 70B: 80 слоёв, 8 голов ключей и значений, размерность головы 128, формат FP16.
- На один токен: 2 (ключ и значение) × 80 × 8 × 128 × 2 байта ≈ 0,31 МБ.
- Контекст 32 тысячи токенов: ≈ 10 ГБ на один диалог.
- Десять пользователей с таким контекстом одновременно: ≈ 100 ГБ только под кеш.
Поэтому для корпоративного сервиса на много пользователей памяти нужно в разы больше, чем «чтобы модель запустилась».
Сколько памяти нужно популярным моделям
Объём только под веса, без кеша и запаса:
| Модель | Параметров | FP16 | FP8 | 4 бита |
|---|---|---|---|---|
| Qwen3 8B | 8B | 16 ГБ | 8 ГБ | ~5 ГБ |
| Qwen3 32B | 32B | 64 ГБ | 32 ГБ | ~18 ГБ |
| Llama 3.3 70B | 70B | 140 ГБ | 70 ГБ | ~40 ГБ |
| gpt-oss-120b | 117B (MoE) | — | — | ~61 ГБ в родном MXFP4 |
| Qwen3 235B-A22B | 235B (MoE) | 470 ГБ | 235 ГБ | ~125 ГБ |
| DeepSeek V3 / R1 | 671B (MoE) | — | ~700 ГБ в родном FP8 | ~380 ГБ |
Важная деталь про модели MoE (Mixture of Experts), такие как DeepSeek, Qwen3 235B и gpt-oss. В каждом токене работает лишь часть параметров, например у DeepSeek это 37B из 671B. Но в памяти должны лежать все веса, иначе модели некуда переключаться между экспертами. Экономия у MoE в скорости, а не в объёме памяти. О запуске самой крупной из них читайте в статье «Сервер для DeepSeek».
Какое железо под какой объём
Сопоставим объёмы с реальными конфигурациями:
- 32 ГБ: GeForce RTX 5090. Модели до 32B в 4 битах, генерация изображений. Самый доступный вход.
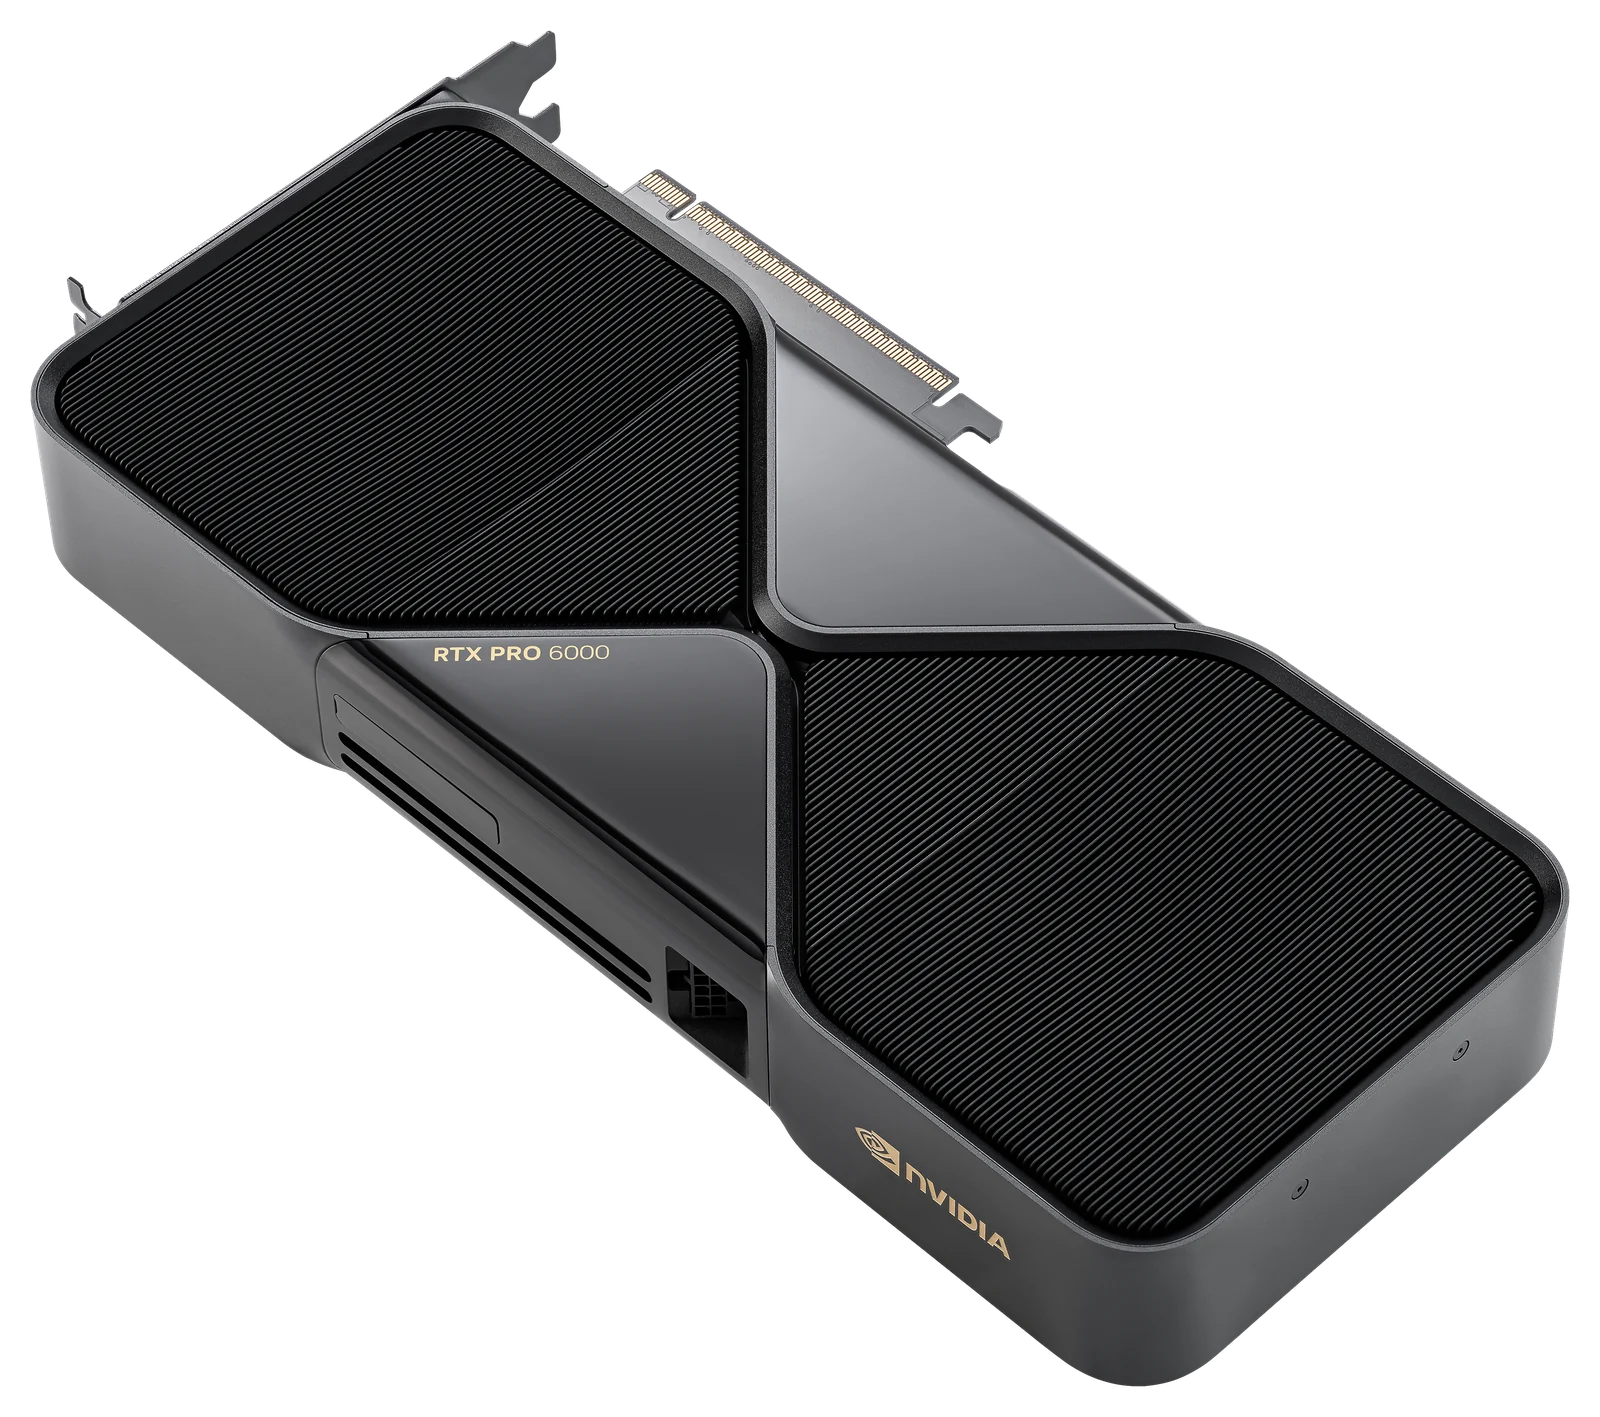
- 96 ГБ: RTX PRO 6000 Blackwell. Llama 70B в FP8 на одной карте с запасом под кеш, gpt-oss-120b целиком.
- 128 ГБ общей памяти: DGX Spark. Модели до 200B в 4 битах на столе. Но память медленнее, чем у серверных GPU (об этом ниже).
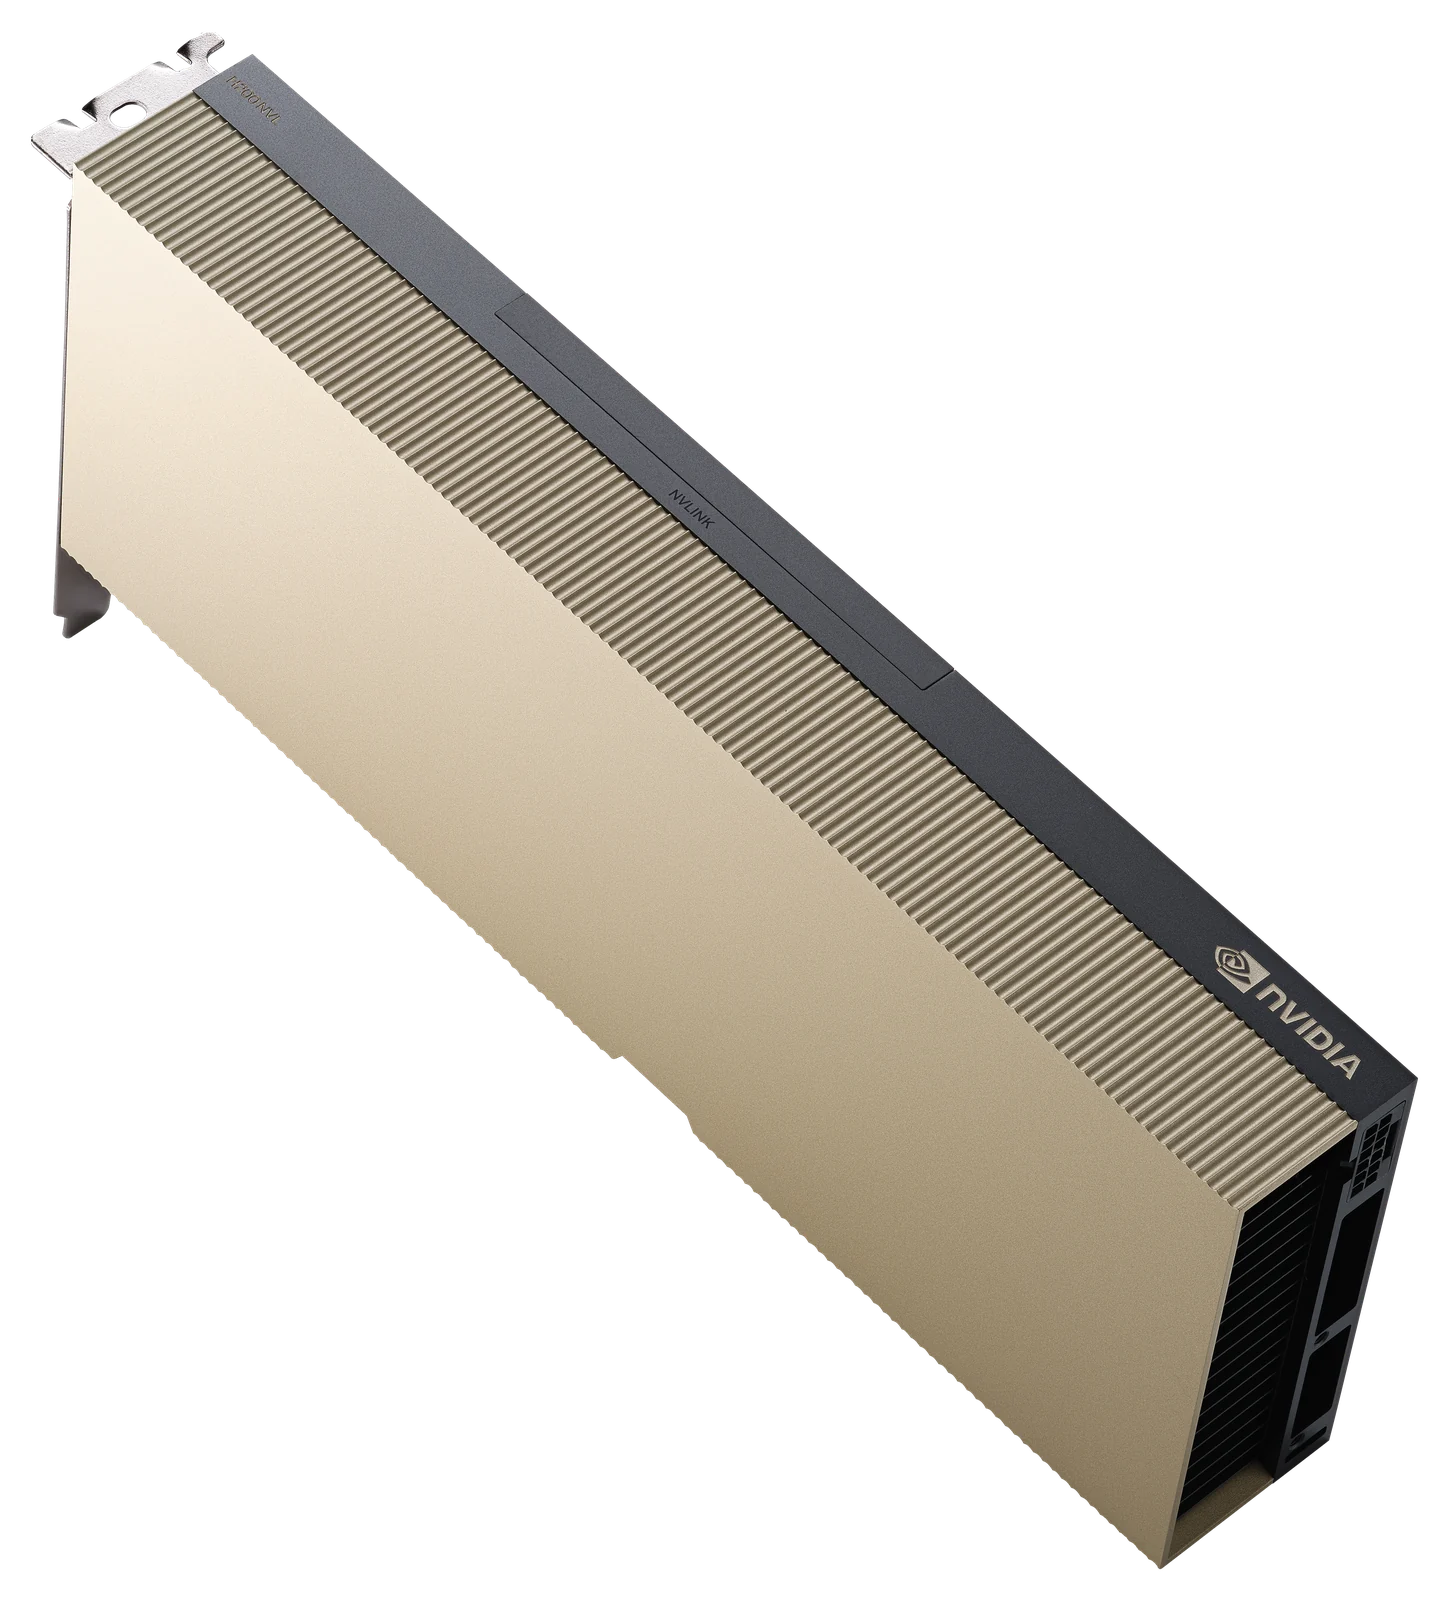
- 141 ГБ: H200 NVL. Llama 70B в FP8 с большим запасом под длинный контекст и пользователей. Без квантования веса 70B занимают около 140 ГБ, поэтому нужна пара карт.
- 512–768 ГБ. Huawei Atlas 800I A2 на восьми Ascend 910B или сервер Gigabyte на 8× RTX PRO 6000. Qwen3 235B в FP8 с запасом под пользователей.
- 1,1 ТБ и больше: DGX H200, DGX B200. DeepSeek 671B в родном FP8 в одной системе.
Объём решает, влезет ли модель. Скорость памяти решает, как быстро она ответит
Генерация текста упирается не в вычисления, а в чтение весов из памяти: для каждого нового токена модель читает их целиком. Отсюда верхняя граница скорости для одного диалога: пропускная способность памяти ÷ объём весов.
Пример для Llama 70B в 4 битах (~40 ГБ весов):
| Устройство | Скорость памяти | Потолок, токенов в секунду |
|---|---|---|
| DGX Spark | 273 ГБ/с | ~7 |
| RTX PRO 6000 | 1,79 ТБ/с | ~45 |
| H200 NVL | 4,8 ТБ/с | ~120 |
Это теоретический максимум для одного пользователя, на практике выходит меньше. Но порядок разницы честный: модель, которая «влезает» в DGX Spark, на серверной карте отвечает в десятки раз быстрее. Для прототипа и одного разработчика хватит Spark, для сервиса на отдел нужна карта с быстрой HBM-памятью.
Типичные ошибки при расчёте
- Считать только веса. Модель запустится, но упадёт на первом длинном документе или втором пользователе.
- Путать MoE с маленькой моделью. Активных параметров мало, а памяти нужно под все.
- Складывать память нескольких игровых карт. Без быстрой связи между GPU модель, разрезанная на четыре RTX 5090, работает заметно медленнее одной карты с тем же суммарным объёмом.
- Забывать про рост. Через полгода появится модель крупнее, а пользователей станет больше. Закладывайте запас 30–50%.
Коротко
- Веса: миллиарды параметров × 2 (FP16), × 1 (FP8), × 0,5 (4 бита) гигабайт.
- Плюс KV-кеш: около 10 ГБ на диалог с контекстом 32 тысячи токенов для модели 70B.
- Плюс 10–20% служебного и запас на рост.
- Объём определяет, запустится ли модель, а скорость памяти определяет, насколько быстро она ответит.
Если хотите, мы посчитаем конфигурацию под вашу модель, число пользователей и длину контекста: оставьте заявку, ответим с вариантами железа и сроками.
Оборудование из статьи
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
NVIDIA
H200 NVL
Больше всего памяти в формате PCIe: 141 ГБ HBM3e на карту.
- HBM3e
- 141ГБ
- Скорость памяти
- 4,8ТБ/с
- FP8
- 3341TFLOPS
Цена по запросу
NVIDIA
DGX H200
Тот же DGX, но с почти вдвое большей памятью: 1,1 ТБ HBM3e.
- H200 SXM
- 8GPU
- Память GPU
- 1128ГБ
- FP8
- 32ПФЛОПС
Цена по запросу
Читайте также
Квантование LLM: FP8, INT4 и FP4 простыми словами
Что такое квантование LLM простыми словами: форматы FP8, INT8, INT4, FP4 и GGUF, сколько памяти они экономят, как влияют на качество и какое железо их поддерживает.
Сервер для DeepSeek V3 и R1: какое железо нужно для полной модели
Какой сервер для DeepSeek V3 и R1 нужен, чтобы запустить полную модель на 671B: сколько памяти занимают веса и варианты на H200, B200, Ascend и RTX PRO 6000.
gpt-oss-120b и gpt-oss-20b: на каком железе запускать
Сколько памяти нужно gpt-oss-120b и gpt-oss-20b, открытым моделям OpenAI: веса в MXFP4, какие GPU подходят, сколько пользователей потянет карта и чем запускать.