Запуск моделей
Qwen3 локально: какие GPU нужны для моделей 8B, 32B и 235B
Как запустить Qwen3 локально или на своём сервере: сколько памяти нужно моделям от 8B до 235B в BF16, FP8 и 4 битах и какие GPU и серверы под них подойдут.
Содержание
Запустить Qwen3 локально можно на очень разном железе. Qwen3 8B в FP8 занимает около 8 ГБ и работает на одной видеокарте на 32 ГБ. Qwen3 32B в FP8 (32 ГБ) с запасом помещается в RTX PRO 6000 на 96 ГБ. А флагману Qwen3 235B-A22B нужно около 235 ГБ под веса в FP8, это уже сервер на несколько ускорителей. Ниже таблица по всей линейке и подбор железа под каждую модель.
Линейка Qwen3 и лицензия
Qwen3 выпустила Alibaba в апреле 2025 года. В линейке шесть плотных моделей (0,6B, 1,7B, 4B, 8B, 14B и 32B) и две модели MoE: Qwen3 30B-A3B с 3B активных параметров и Qwen3 235B-A22B с 22B активных. Цифра после «A» в названии показывает, сколько параметров работает на каждый токен.
Модели распространяются под лицензией Apache 2.0. Их можно использовать в коммерческих продуктах, дообучать и разворачивать внутри компании. Заявлена поддержка 119 языков и диалектов, русский в их числе.
У Qwen3 есть режим с рассуждением, когда модель сначала «думает» и только потом отвечает, и режим без него. Рассуждение помогает на сложных задачах, но модель генерирует больше токенов. Значит, ответ приходит позже, а KV-кеш на один диалог растёт.
Требования Qwen3 к железу: таблица памяти
Объём только под веса, без кеша и служебной памяти:
| Модель | Тип | BF16 | FP8 | 4 бита | Подходящее железо |
|---|---|---|---|---|---|
| Qwen3 0,6B–4B | плотные | 1,2–8 ГБ | 0,6–4 ГБ | до ~3 ГБ | Любая современная видеокарта |
| Qwen3 8B | плотная | 16 ГБ | 8 ГБ | ~5 ГБ | RTX 5090 |
| Qwen3 14B | плотная | 28 ГБ | 14 ГБ | ~8 ГБ | RTX 5090 в FP8, RTX PRO 6000 в BF16 |
| Qwen3 30B-A3B | MoE | 60 ГБ | 30 ГБ | ~17 ГБ | RTX PRO 6000, RTX 5090 в 4 битах |
| Qwen3 32B | плотная | 64 ГБ | 32 ГБ | ~18 ГБ | RTX PRO 6000, RTX 5090 в 4 битах |
| Qwen3 235B-A22B | MoE | 470 ГБ | 235 ГБ | ~125 ГБ | 4 × H200 NVL, 8 × RTX PRO 6000, Atlas 800I A2 |
Считается просто: миллиарды параметров × 2 байта в BF16, × 1 в FP8, × 0,5 в 4 битах. Сверху добавьте 10–20% служебной памяти и KV-кеш под контекст. Для сервиса на много пользователей кеш бывает сравним с весами, поэтому карту стоит брать с запасом. Подробно расчёт разобран в статье «Сколько видеопамяти нужно для LLM».
Qwen3 локально: какое железо под какую модель
8B и 14B: одна карта на 32 ГБ
GeForce RTX 5090 с 32 ГБ памяти и скоростью 1,79 ТБ/с держит Qwen3 8B даже в BF16 с запасом под кеш, а 14B в FP8. Этого хватает для разработки, прототипа или сервиса на небольшую группу.
Для серверной RTX 5090 не подходит: лицензия драйвера GeForce не предусматривает установку в дата-центрах. Там нужна профессиональная или серверная карта.
32B и 30B-A3B: RTX PRO 6000
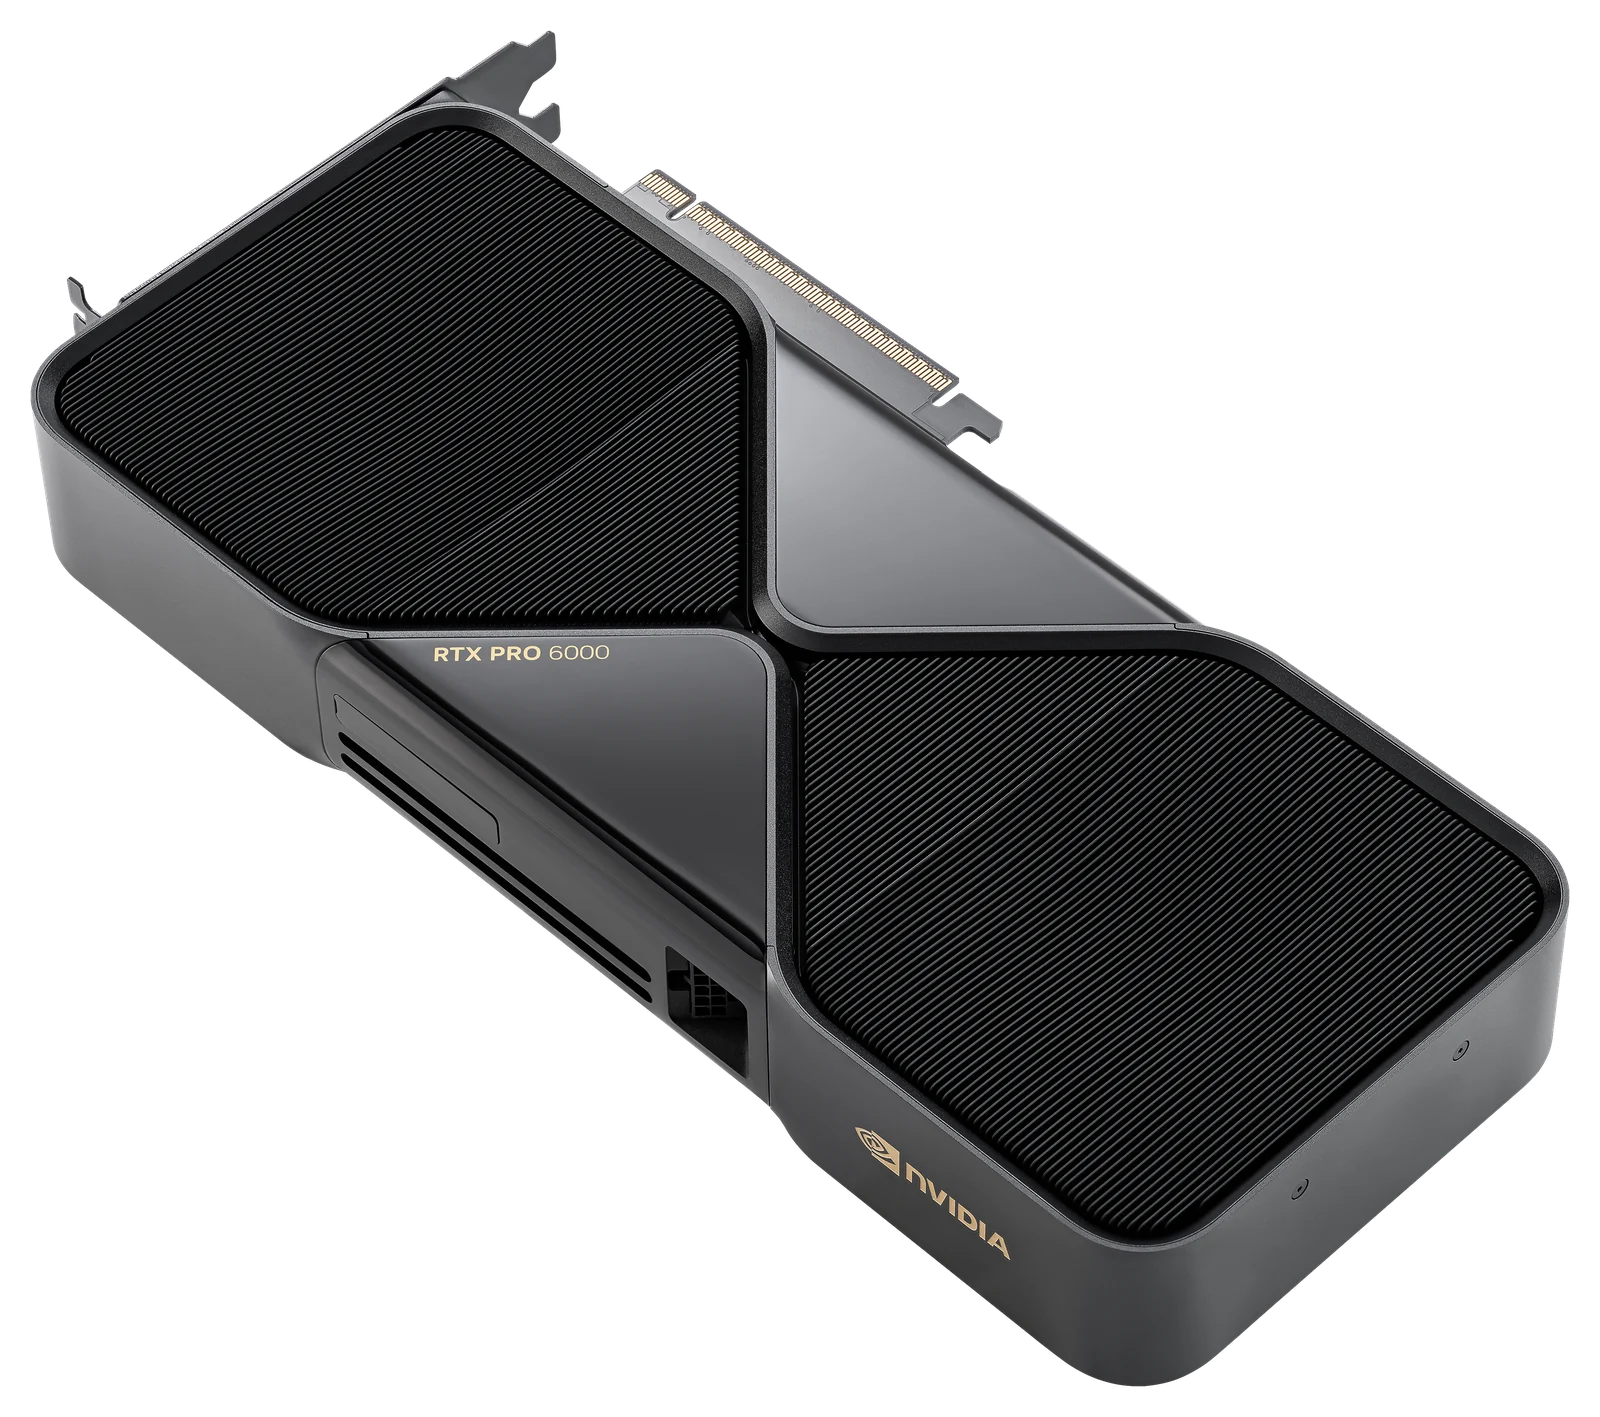
RTX PRO 6000 Blackwell с 96 ГБ памяти с ECC держит Qwen3 32B даже в BF16. В FP8 модель занимает треть карты, а остальное уходит под контекст пользователей. Это удобная конфигурация для внутреннего ассистента на отдел.
Карту можно разделить через MIG на изолированные экземпляры, до четырёх на карту. Так на одной RTX PRO 6000 работают, например, несколько небольших моделей для разных команд, и они не мешают друг другу.
Почему 30B-A3B такая быстрая
На каждый токен у 30B-A3B работают только 3B параметров. В FP8 это около 3 ГБ чтения из памяти на токен против 32 ГБ у плотной 32B. Генерация упирается именно в чтение весов, поэтому теоретический потолок скорости для одного диалога у 30B-A3B примерно в десять раз выше.
На практике разрыв меньше: при таком малом объёме чтения начинают сказываться другие накладные расходы, например выбор экспертов и работа с кешем. Но модель заметно быстрее плотной. Памяти при этом нужно как модели на 30B, ведь все эксперты должны лежать в памяти. Выбирать между 30B-A3B и 32B лучше на своих задачах: первая выигрывает в скорости, качество обеих стоит проверить на типичных запросах.
Qwen3 235B: железо для серьёзного сервиса
Qwen3 235B-A22B по объёму памяти ведёт себя как модель на 235B, а по скорости генерации ближе к плотной модели на 22B: в FP8 она читает около 22 ГБ на токен. Это вариант для сервиса на компанию, сложных задач и длинных документов. Варианты железа:
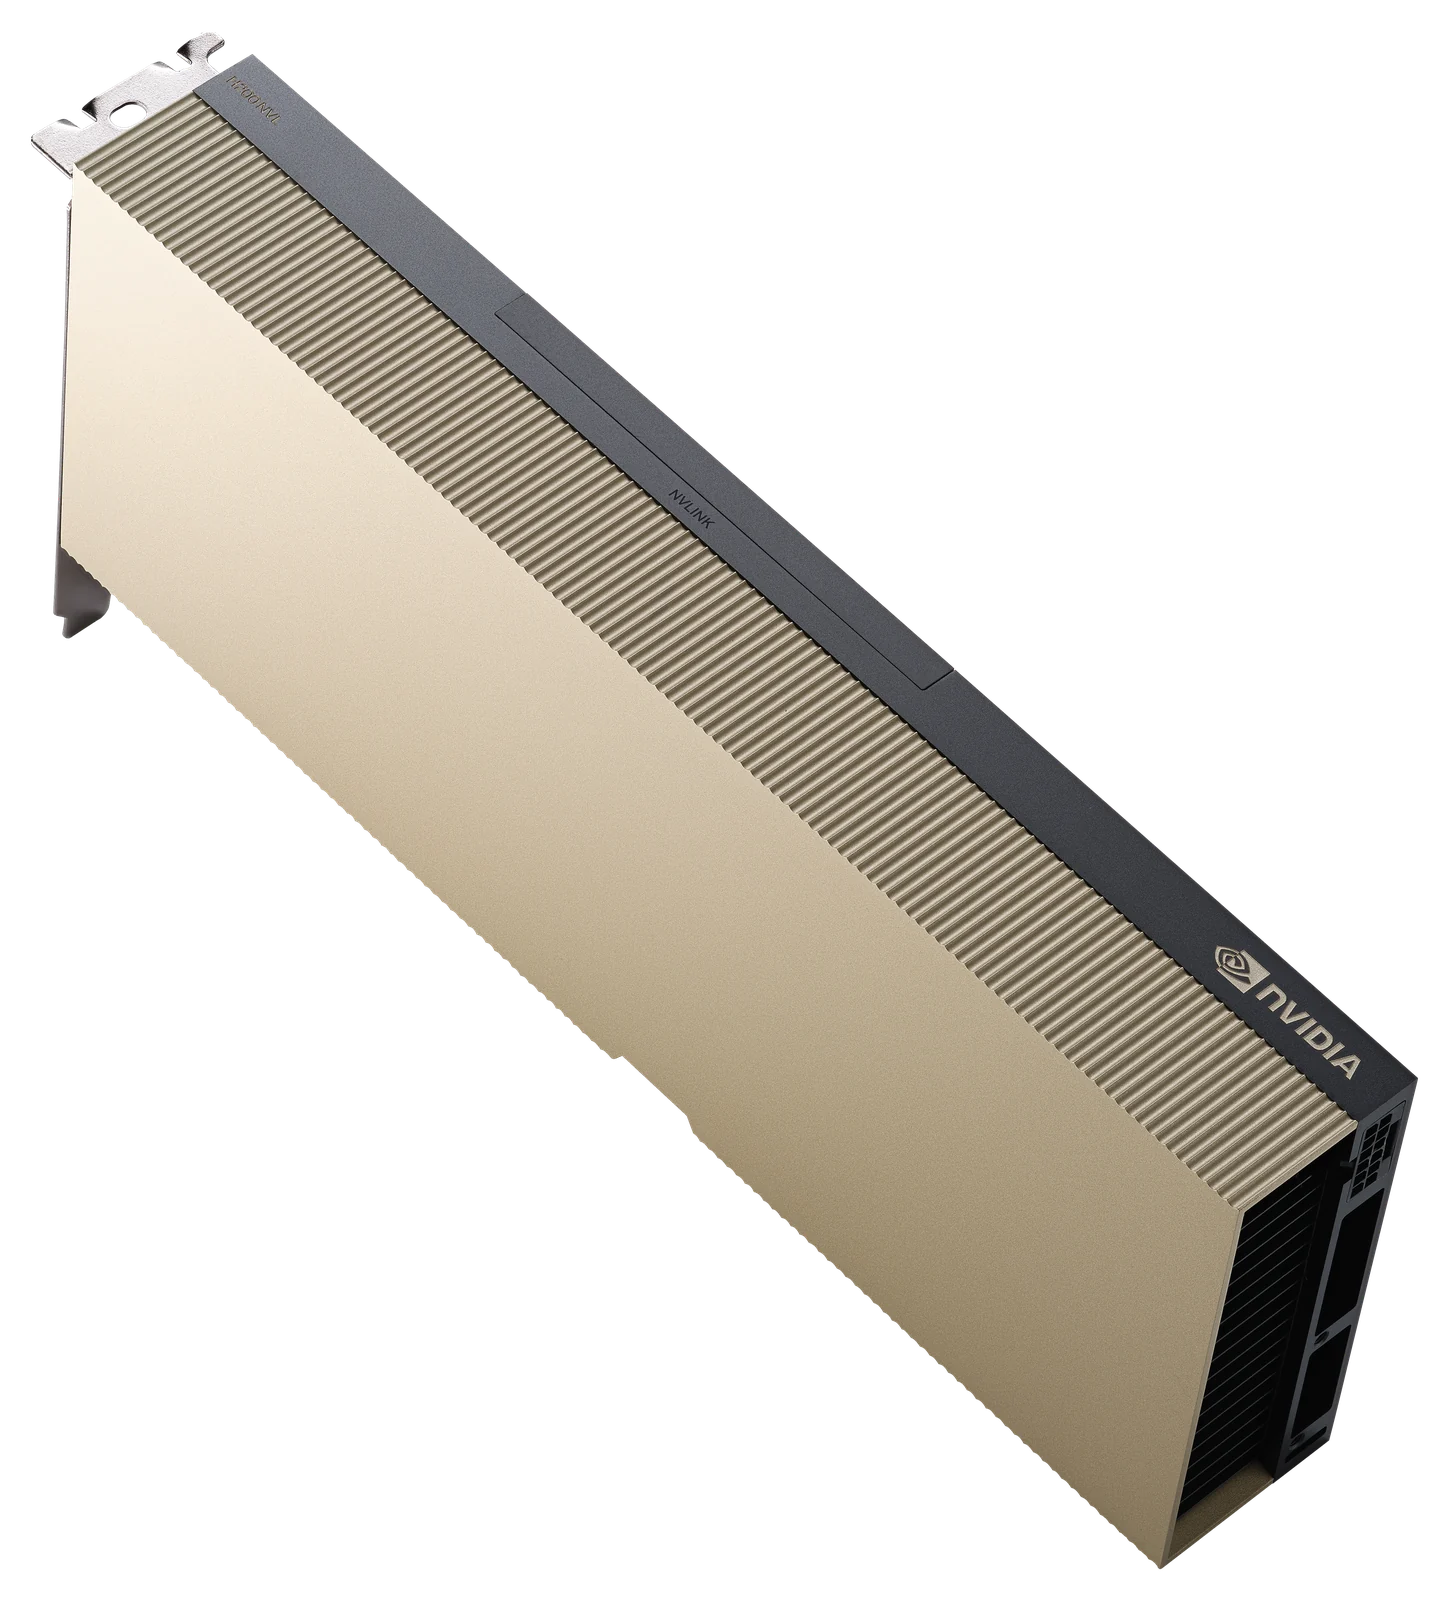
- 4 × H200 NVL. Четыре карты по 141 ГБ, связанные NVLink-мостом на 900 ГБ/с, дают 564 ГБ. FP8-версия занимает меньше половины, остальное идёт под кеш. У H200 NVL самая быстрая память из трёх вариантов (4,8 ТБ/с на карту), а значит и самый высокий теоретический потолок скорости генерации. Двух карт (282 ГБ) хватит для 4-битной версии.
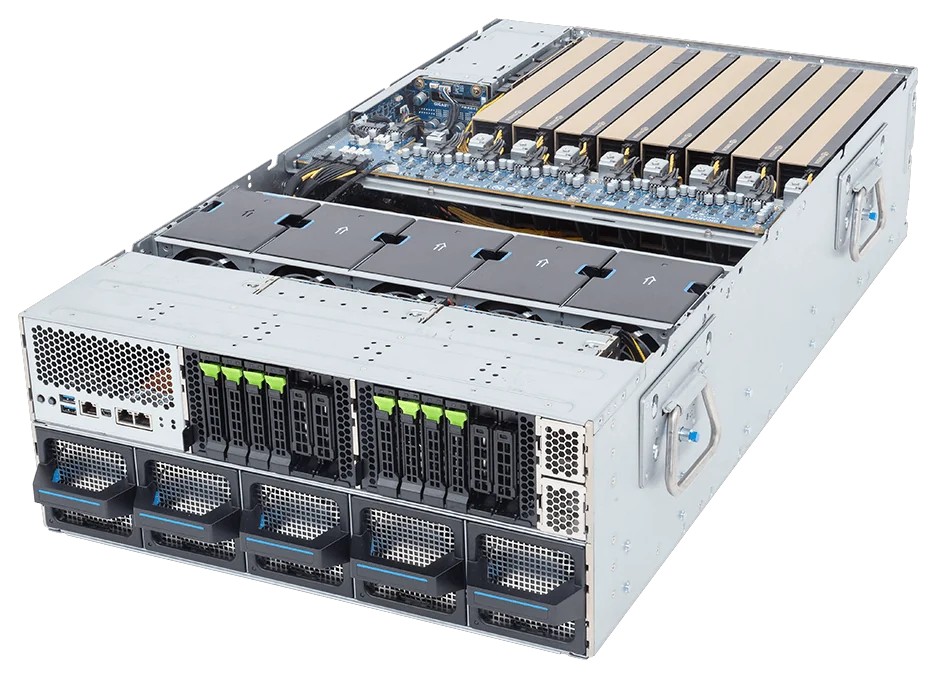
- Сервер на 8 × RTX PRO 6000. Gigabyte XL44-SX2 даёт 768 ГБ памяти GPU в корпусе 4U. Здесь помещается FP8 с большим запасом под пользователей и даже BF16 (470 ГБ). Карты связаны через PCIe 5.0, без NVLink.
- Huawei Atlas 800I A2. Восемь Ascend 910B по 64 ГБ, всего 512 ГБ HBM, чипы связаны по схеме full-mesh на 392 ГБ/с. 8-битная версия помещается с запасом под кеш.
| Конфигурация | Память | Связь ускорителей | Что помещается |
|---|---|---|---|
| 2 × H200 NVL | 282 ГБ HBM3e | NVLink-мост, 900 ГБ/с | 4 бита с запасом, FP8 впритык |
| 4 × H200 NVL | 564 ГБ HBM3e | NVLink-мост, 900 ГБ/с | FP8 с большим запасом |
| Gigabyte XL44-SX2 | 768 ГБ GDDR7 с ECC | PCIe 5.0 | FP8 с большим запасом, BF16 |
| Atlas 800I A2 | 512 ГБ HBM | full-mesh, 392 ГБ/с | 8 бит с запасом |
Запуск Qwen на своём сервере: софт
Qwen3 поддерживают все популярные движки, выбор зависит от сценария:
- Ollama и llama.cpp. Простой запуск в формате GGUF (Q4_K_M, Q8_0), удобно для прототипа и одного пользователя.
- vLLM. Стандарт для многопользовательского сервиса: PagedAttention, непрерывный батчинг и OpenAI-совместимый API.
- SGLang. RadixAttention переиспользует общий префикс запросов, это полезно, когда у всех пользователей одинаковый длинный системный промпт.
- На Huawei Ascend: vLLM Ascend и MindIE поверх стека CANN, для своего кода PyTorch через torch_npu. Qwen, как и DeepSeek, относится к популярным открытым моделям, которые на Ascend уже запускаются. Больше работы требует перенос собственного обучающего кода и нишевых библиотек.
Как подобрать сервер под число сотрудников и одновременных запросов, мы разобрали в статье «Сервер для локальной LLM в компании».
С какой модели начать
- Классификация, извлечение данных, простой чат-бот: Qwen3 8B или 14B на одной карте.
- Ассистент на отдел, работа с документами: Qwen3 32B или 30B-A3B на RTX PRO 6000.
- Сервис на компанию, сложные задачи, длинный контекст: Qwen3 235B-A22B на сервере с памятью от 512 ГБ.
Начинать разумно с модели поменьше и проверять качество на своих данных. Переходить на модель крупнее стоит тогда, когда меньшая перестаёт справляться с реальными задачами, а не заранее.
Коротко
- Qwen3: плотные модели от 0,6B до 32B и две MoE, лицензия Apache 2.0 разрешает коммерческое использование.
- Память под веса: миллиарды параметров × 2 (BF16), × 1 (FP8), × 0,5 (4 бита) гигабайт, плюс кеш и служебное.
- 8B и 14B работают на одной карте на 32 ГБ, 32B и 30B-A3B на RTX PRO 6000, 235B-A22B на сервере от 512 ГБ.
- MoE-модели читают на токен только активные параметры, поэтому генерируют быстрее плотных моделей того же объёма.
- На Huawei Qwen3 запускается через vLLM Ascend и MindIE.
Если выбираете железо под Qwen3, оставьте заявку: посчитаем конфигурацию под вашу модель и число пользователей, цену и срок пришлём в течение рабочего дня.
Оборудование из статьи
NVIDIA Популярное
RTX PRO 6000 Blackwell
96 ГБ памяти в одной карте: модели 70B и больше без кластера.
- GDDR7 с ECC
- 96ГБ
- ИИ, FP4
- 4000TOPS
- Потребление
- 600Вт
Цена по запросу
NVIDIA
H200 NVL
Больше всего памяти в формате PCIe: 141 ГБ HBM3e на карту.
- HBM3e
- 141ГБ
- Скорость памяти
- 4,8ТБ/с
- FP8
- 3341TFLOPS
Цена по запросу
Gigabyte
Gigabyte XL44-SX2
Восемь RTX PRO 6000 в одном сервере: 768 ГБ памяти GPU.
- RTX PRO 6000
- 8GPU
- Память GPU
- 768ГБ
- Высота
- 4U
Цена по запросу
Читайте также
Сколько видеопамяти нужно для LLM: расчёт для моделей от 8B до 671B
Простая формула, сколько видеопамяти нужно языковой модели: веса, KV-кеш и запас. Таблица для Qwen3, Llama 70B, gpt-oss и DeepSeek и подбор GPU под объём.
Сервер для локальной LLM в компании: как подобрать конфигурацию
Как подобрать сервер для LLM в компании: расчёт памяти под модель и пользователей, KV-кеш, три типовые конфигурации от отдела до крупного сервиса и софт для запуска.
vLLM, Ollama или SGLang: чем запускать LLM на сервере
vLLM или Ollama, SGLang или TensorRT-LLM: чем отличаются движки для запуска LLM, что выбрать для сервиса на компанию и как движок влияет на выбор GPU.